第5章:知识切片——构建原子化知识库
本章摘要
在完成了第四天的风格克隆演练后,我们已经掌握了如何塑造智能体的“性格”与“语调”。然而,一个真正的智能体不仅仅是一个复读机,它必须具备基于事实的推理能力。这就引出了大模型工程落地中的核心矛盾:人类的知识通常以“篇章”或“书籍”的形式存在,而大语言模型的处理逻辑却受制于物理极限。
如果我们试图给 AI 塞进一整头牛(长达数万字的研究报告),它不仅会面临上下文窗口(Context Window)的截断,更会因为注意力机制的稀释而产生“中间迷失”(Lost in the Middle)现象,导致输出结果的准确性直线下降。
今天我们学习的核心理念是原子化设计。我们将这种过程比喻为“细嚼慢咽”的知识消化。只有被切碎、提炼并赋予结构的知识,才能作为高价值的养分进入智能体的“海马体”(Obsidain 知识库)。
我们将深入探讨为何长文本是 AI 的噩梦,并引入 S.C.O.R.E. 模型 来指导我们如何自动化地执行这一“肢解”任务,将庞大且笨重的文本转化为灵动且互联的原子笔记。这一步是构建 RAG(检索增强生成)系统的物理基础,没有高质量的切片,未来的智能检索将如沙上筑塔。
基础理论:给 AI 的“咀嚼”指南
“如果说 Prompt Engineering 是教 AI 如何‘说话’,那么 Knowledge Chunking(知识切片)就是教 AI 如何‘阅读’。在把人类的图书馆搬进硅基大脑之前,我们必须先把书本变成砖块。”
知识切片在智能体工程中,本质上是一个“信息重组”的过程。它将人类习惯的线性、流式的阅读材料(文章、书籍、报告),转化为机器擅长的离散、高维的数据库记录(向量、图谱)。这不仅是一个简单的文本处理动作,更是一场关于计算成本、认知负荷与检索精度的精密工程博弈。
今天,我们将深入大语言模型(LLM)的“消化系统”底层,揭示为什么哪怕在 Context Window(上下文窗口)突破 1M Token 的今天,我们依然需要像外科医生一样,对知识进行精准的解剖与缝合。
2.1 物理边界:上下文窗口与计算的“熵增”
每一个大语言模型都有其预定义的上下文窗口限制,这决定了它在单次推理中能“握住”的 Token 总量。虽然 Gemini 或 GPT等模型宣称支持 128k 甚至 1M 的 Token,但在工程实践中,盲目填充上下文(Context Stuffing)往往是通往低效与高成本的捷径。
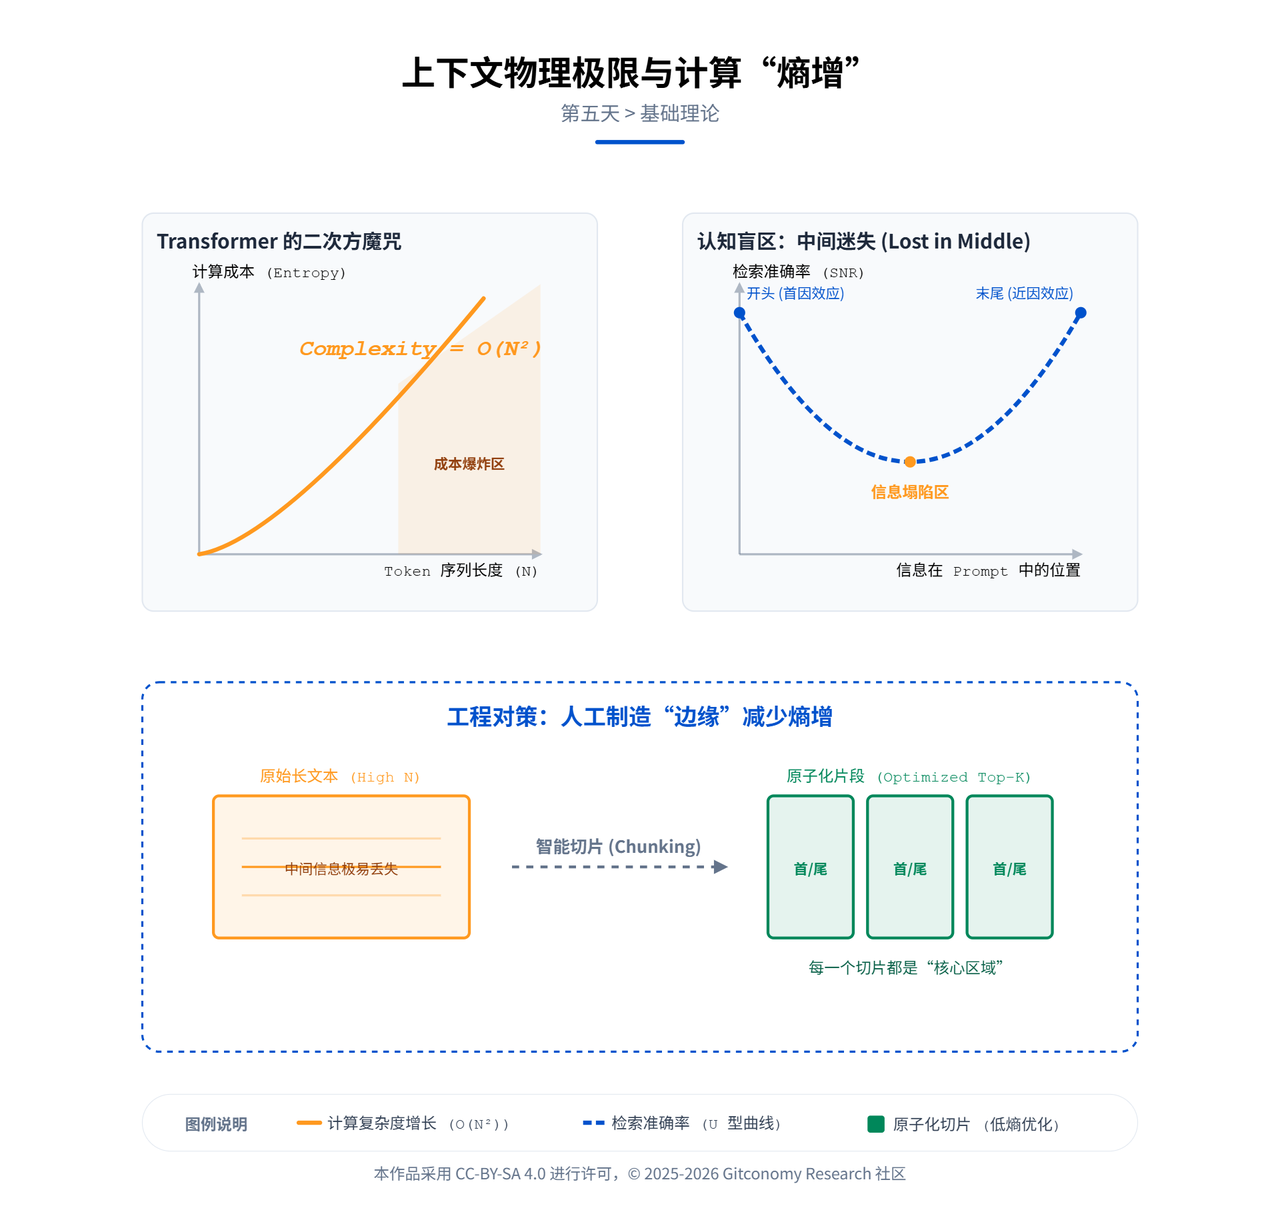
图5-1: 上下文物理极限与计算“熵增”原理
2.1.1 Transformer 的二次方魔咒:O(N2)O(N2) 的代价
为什么我们不能把整本书塞进 Prompt 里?这不仅仅是“放不放得下”的问题,更是“算不算得动”的问题。
从计算机科学的底层视角来看,当前主流 LLM 所依赖的Transformer 架构,其核心组件——自注意力机制(Self-Attention Mechanism)——并不是免费的午餐。在推理过程中,模型需要计算序列中每一个 Token 与其他所有 Token 之间的关联权重,以理解上下文关系。
这就导致了一个残酷的数学事实:计算开销(FLOPs)和显存占用(KV Cache)与序列长度 NN 呈现二次方增长关系:复杂度为:O(N2)O(N2)
这意味着工程成本的指数级爆炸:
•
当我们将输入文本增加到原来的 2 倍 时,计算成本不是增加 2 倍,而是激增至 4 倍。
•
当输入增加到 10 倍 时,成本将暴涨至 100 倍。
这种非线性的成本增长带来了两个严重的工程后果:
延迟的不可接受:在实时交互的智能体系统中,用户期待的是秒级响应。处理超长上下文导致的几十秒甚至几分钟的“思考时间(Time to First Token)”,会彻底破坏“智能助手”的体验,使其退化为“离线批处理任务”。
昂贵的 Token 开销费用:Token 的增加直接对应着 API 账单的飙升。在企业级 RAG 系统中,如果每次查询都需要重新读取数万字的背景文档,其运营成本将是不可持续的。
因此,高效的智能体工程绝不是盲目地“喂整牛”,而是通过精准的“知识切片”,仅在必要时将最相关的片段(Top-K Chunks)推送到模型的注意力中心,实现计算资源的“熵减”。
2.1.2 信噪比(SNR)与注意力的稀释
除了计算成本,长文本还带来了“信噪比” (Signal-to-Noise Ratio) 的稀释问题。
当我们把整本《公司员工手册》扔给 AI 去回答一个关于“差旅报销流程”的具体问题时,99% 的文本(如关于“着装规范”、“休假制度”或“知识产权协议”的章节)对于当前特定任务来说都是噪声(Noise)。在 RAG(检索增强生成)系统中,检索的本质是在高维向量空间(Vector Space)中寻找“最相似”的片段。
工程原则:最小够用上下文(Minimum Viable Context)。我们只给 AI 看解决当前问题所必须的那几段话,多一句都是干扰。
2.2 认知盲区:“中间迷失”现象深度解析
即便我们不考虑成本,假设拥有无限算力,大语言模型在处理长文本时,在认知层面也存在着类似于人类的“缺陷”。
斯坦福大学与加州大学伯克利分校的研究者在论文《Lost in the Middle: How Language Models Use Long Contexts》中揭示了一个令人不安的真相:模型的注意力并非均匀分布。
2.2.1 U 型性能曲线与注意力沉没
实验数据表明,当相关信息位于长上下文的不同位置时,模型的检索准确率呈现出显著的 U 型曲线(表5-1):
表 5-1:长文本上下文的注意力分布特征
2.2.2 工程本质:人工制造“边缘”
这种“中间迷失”现象意味着,如果我们不进行切片,而是将整个文档投入 Prompt,那么隐藏在文档中部的关键论据可能永远无法被智能体正确调取。
知识切片的工程本质,就是人工制造更多的“开头”和“结尾”。
通过将长文拆解为独立的片段(Chunks),我们将原本位于长文“中间”的死角,变成了每一个独立片段的“开头”或“结尾”。当这些片段被 RAG 系统检索并作为 Context 喂给模型时,它们处于 Prompt 的显著位置,从而规避了认知盲区,确保了信息的召回率(Recall)。
2.3 哲学回归:原子笔记的复兴
在 AI 时代,德国社会学家尼克拉斯·卢曼(Niklas Luhmann)的“卡片盒笔记法”(Zettelkasten)获得了算法层面的新生。如果在 Day 1 我们把 Obsidian 比作智能体的“海马体”,那么“原子笔记(Atomic Notes)”就是构成记忆的神经元。
2.3.1 原子性 (Atomicity) 的双重定义
原子笔记的核心原则是“一个笔记,一个思想”。这一原则在 AI 工程中具有双重含义:
人类认知的解耦:原子性意味着你可以随意组合、拼接这些卡片来构建新的文章,而不用担心上下文牵连。这使得知识变成了可复用的“乐高积木”。
机器语义的纯粹性:对于 AI,原子性意味着语义的低熵状态。一个包含多个主题(如既讲“苹果财报”又讲“香蕉种植”)的笔记,在向量空间中是一个模糊的、多峰分布的点。而一个原子切片(只讲“苹果财报”)在向量空间中是一个清晰的、锐利的方向向量。原子化程度越高,向量检索的精度越高。
2.3.2 独立性与去语境化
一个合格的原子切片必须是”自解释的(Self-Contained)”。这是知识切片中最容易被忽视的工程难点。
在原始长文中,句子是依赖上下文存在的。例如:
原文段落: “它具有极高的导电性,且在常温下保持稳定。”
如果我们机械地切分出这句话,AI 读到“它”时会感到困惑——“它”是谁?是石墨烯?是超导体?还是铜?如果这个切片被单独检索出来,就是一个废数据。
智能切片工程要求我们在切割的同时,进行“去语境化(De-contextualization)”处理——即把隐性的上下文显性化:
处理后的切片: “**[石墨烯]**具有极高的导电性,且在常温下保持稳定。”
通过 S.C.O.R.E. 模型驱动的 AI 切片,我们可以强制模型执行这种“指代消解”(Coreference Resolution),确保每一个切片即使脱离了原文,依然是一个完整、独立的事实单元。
💡 提示工程技巧:Markdown 的结构价值 AI 非常喜欢 Markdown 的结构。在切片时,保留 # 标题 和 --- 分隔符,相当于给 AI 提供了语义的“抓手”。
•
H1/H2 标题:作为强语义特征,在混合检索(Hybrid Search = 关键词 + 向量)中具有极高的权重。
•
分割线:明确了逻辑边界,防止 AI 在推理时发生跨主题的“串线”。
•
列表与表格:结构化数据天然是低熵的,保留 Markdown 表格语法能显著提升 AI 对数据的理解力。
2.4 切片策略分类学:如何优雅地“肢解”知识
并非所有的切片方式都是平等的。根据数据的结构(PDF、Markdown、代码)和检索需求(事实问答、摘要、分析),我们需要在不同的“切片刀”之间做出权衡。以下是 2025 年主流的 RAG 切片策略分类学:
2.4.1 策略对比:从暴力拆解到语义洞察
表格加载中...
表 5-2:2025 主流 RAG 切片策略对比
2.4.2 黄金重叠度 (Overlap) 的艺术
无论选择哪种物理切片策略(固定或递归),设置 10%-20% 的重叠度 (Chunk Overlap) 都是至关重要的工程保险。
这就像是全景照片拼接时的边缘重叠,确保了相邻切片之间有足够的语义“胶水”。
•
防止语义断裂:例如,一个关于“因果关系”的论证,如果被切成两段且没有重叠,第一段只有“原因”,第二段只有“结果”,AI 检索到任意一段都无法理解两者的必然联系。
•
滑动窗口效应:重叠区允许我们在检索时保留一定的上下文余量,使得检索窗口可以在文本上平滑滑动,而不是跳跃式移动,从而捕捉到跨越切分点的完整语义。
实战演练:利用 S.C.O.R.E. 模型自动化切片
场景设定:你的老板丢给你一篇硬核的《2025年生成式AI数据工程与智能体架构深度研究报告》)(Markdown 格式),字数虽只有几千字,但信息密度极高,包含了算法原理、切片策略和架构模型。 任务目标:你需要将其拆解为独立的“原子化概念卡片”,存入 Obsidian,以便未来你的 AI 助手能精准回答“什么是语义切片?”或“PEAR 模型包含哪几个阶段?”等问题。
图5-2:第五天实验步骤
3.1 准备“原石”
首先,我们需要待处理的高熵文本。请在 Obsidian 中新建一篇笔记,命名为 Source-GenAI-Report-2025.md,并将以下样本报告内容粘贴进去作为输入素材:
[输入素材预览] 摘要:随着大语言模型(LLM)上下文窗口的扩展……本文深入探讨了2025年RAG系统的核心挑战…… 第一章:上下文物理极限与认知盲区……自注意力机制的计算开销与序列长度 N 呈现二次方增长关系…… 第二章:RAG 系统的切片策略演进……包括固定大小切片、递归字符切片、语义切片…… 第四章:……智能体运行环境需遵循 PEAR 闭环:Perceive(感知)、Evaluate(评估)、Act(行动)、Reflect(反思)……
注:实际操作中,请使用完整的报告文本
3.2 设计“切片刀” Prompt
我们将使用 S.C.O.R.E. 模型 来构建这个能够自动化拆解知识的 Prompt。重点在于 Requirements 模块,我们需要在这个模块中定义“原子化”的物理标准,强迫 AI 识别出文中的“切片策略”和“PEAR模型”等独立概念。
请在Obsidian中输入以下 Prompt:
代码块
Markdown
**S (Role - 角色设定)**:
你是一位资深的知识架构师,精通卡片盒笔记法 (Zettelkasten) 和信息论。你擅长从冗长的技术报告中剥离噪音,提炼出高信噪比的原子化知识晶体。
**C (Context - 语境背景)**:
我将提供一篇关于《2025年生成式AI数据工程》的深度报告。该文本包含复杂的算法原理(如 O(N^2))和架构模型(如 PEAR)。目前的线性格式不适合知识库存储,也不利于 AI 未来的精准检索。
**O (Objective - 任务目标)**:
请将这篇文章“切碎”,识别出文中的核心概念(如特定的切片策略、架构模型),并将其拆解为多个独立的原子化笔记 (Atomic Notes)。
**R (Requirements - 切片契约)**:
请严格遵守以下输出规则:
1. 原子性:每张卡片只阐述【一个】核心概念。
备注:将需要分析的样本复制粘贴到{{input}}中
3.3 运 注释:触发动作,将宏大任务转化为具体的“识别”与“拆解”子任务链
将光标放在 Prompt 最后,运行 Text Generator——Ctrl+p(Windows)或者Ctrl+J(macOS/Linux)。基于我们提供的样本,AI 应当输出如下结构的原子化笔记:
卡片1:注意力机制的计算开销 (self-attention-complexity.md)
代码块
YAML
---
type: concept
tags: [transformer, complexity, latency]
topic: Context Limits
---
**【定义/原理】** 在 Transformer 架构中,自注意力机制(Self-Attention)负责计算序列中每个 Token 之间的关联性。其核心计算复杂度与输入序列长度 $N$ 呈现二次方增长关系。
**【特征与瓶颈】**
- **计算壁垒**:这意味着上下文窗口的线性扩展(如从 4k 到 128k),会导致算力和延迟的指数级上升。
- **应用限制**:处理超长文本(Context Stuffing)在企业级应用中会带来昂贵的边际成本。
中间迷失现象 (lost-in-the-middle.md)
代码块
YAML
---
type: phenomenon
tags: [llm, recall, psychology]
topic: Context Limits
---
**【定义/原理】** 斯坦福大学研究揭示的一种大模型认知偏差。模型对长文本开头(首因效应)和结尾(近因效应)的信息提取精度最高,而位于文档中间部分的关键信息极易被忽略或遗忘。
**【特征与启示】**
- **性能曲线**:呈现典型的 **U 型曲线**。
固定大小切片 (fixed-size-chunking.md)
代码块
YAML
---
type: strategy
tags: [rag, chunking, prototyping]
topic: Chunking Strategies
---
**【定义/原理】** 最基础的数据切分策略。忽略语义结构,强制按照设定的字符数(Character Count)或 Token 数进行截断。
**【特征/优缺点】**
- **优点**:计算成本极低,无需依赖模型,适合 MVP 快速开发。
递归字符切片 (recursive-character-splitting.md)
代码块
YAML
---
type: strategy
tags: [rag, chunking, best-practice]
topic: Chunking Strategies
---
**【定义/原理】** 通用 RAG 系统的首选方案。它不强制硬切,而是使用一组优先级递减的分隔符列表来尝试寻找最佳切分点。
语义切片 (semantic-chunking.md)
代码块
YAML
---
type: algorithm
tags: [rag, chunking, embedding, cosine-similarity]
topic: Chunking Strategies
---
文档结构感知切片 (structure-aware-chunking.md)
代码块
YAML
---
type: strategy
tags: [rag, chunking, markdown, html]
topic: Chunking Strategies
---
元数据架构 (metadata -schema.md)
代码块
YAML
---
type: concept
tags: [metadata, yaml, retrieval]
topic: Intelligent Knowledge Engineering
---
GraphRAG (知识图谱增强检索)
代码块
YAML
---
type: architecture
tags: [graph-rag, knowledge-graph, multi-hop]
PEAR 模型 (PEAR Loop)
代码块
YAML
---
type: model
反思模式 (Reflection Pattern)
代码块
YAML
---
type: pattern
3.4 结果的白盒化检查
当 AI 输出切片后,我们不能直接全盘接收。高质量的切片必须满足“半结构化数据”的标准。AI 在切片时为了追求逻辑的“圆满”,可能会自行补全一些它认为理所当然但在原文中并无记载的信息。在将切片存入 Obsidian 前,必须通过“事实校对”环节,确保每一条数据都有原文支撑。
💡 提示工程技巧:利用结构化标记 注意到样本中原本就有 1., 2. 和 #### 等 Markdown 标记吗?AI 非常擅长利用这些“天然边界”进行切分。在准备长文时,如果你能先花 1 分钟手动把大标题刷一遍,AI 的切片准确率会提升 30% 以上。
本章总结
今天,我们完成了智能体工程中至关重要的“数据预处理”环节:
切片即理解:大模型的物理极限要求我们不能投喂“整牛”。只有经过熵减、被切碎并去语境化的知识,才是 AI 能高效计算的养分。
结构即索引:通过 S.C.O.R.E. 模型的 Requirements,我们强制 AI 输出了带有 YAML 元数据和标准结构的原子笔记。这不仅是给人看的,更是给机器读的。
Obsidian 的新角色:它正式成为了你智能体系统的海马体 (Hippocampus)——负责将长篇的、混沌的输入,编码为独立的、离散的、可被检索的高质量记忆神经元。
明天,我们将进一步激活这些原子卡片,学习数据契约 ,利用 Dataview 插件将 Obsidian 彻底升级为一个可查询的本地向量与图谱数据库。
课后思考
如何有效管理知识的切片?
学员可以思考如何通过切片策略提升 RAG 系统的查询效率。在实践中,切片的大小、重叠度和上下文内容的选择直接影响模型的推理速度和准确性。你能想到哪些方法来优化长文本的切片策略,以避免性能瓶颈?
如何克服”中间迷失”现象?
中间迷失现象揭示了长文本处理中对信息的注意力稀释问题。在实际的智能体应用中,如何在切片过程中有效处理文本的“头”和“尾”信息,确保关键内容不会因为过长的上下文被忽略?
如何提升智能体的推理精度?
本章强调通过精准的知识切片提升智能体的推理精度。学员可以思考如何通过调整上下文窗口和知识切片的交互,提升智能体在复杂任务中的表现,例如如何避免因过长上下文导致的“认知误差”或“计算负担”。
附录 1:核心术语表 (Glossary)