第7章:记忆链接——增强图谱推理网络
本章摘要
在第六天,我们为原子笔记注入了“数字基因”——通过 YAML Frontmatter 赋予了每个知识片段结构化的身份标识。然而,这些带有元数据的笔记在文件系统中依然是孤立的节点。一个真正的智能大脑,其力量不仅来自神经元本身,更来自神经元之间错综复杂的连接网络。
今天,我们将完成从“孤岛笔记”到“知识网络”的质变。通过建立笔记之间的 双向链接 (Bi-directional Linking),我们将在 Obsidian 中为 AI 构建起“神经突触”,让智能体能够看透概念之间的隐性关系,并执行复杂的 多跳推理 (Multi-hop Reasoning)。这种基于知识图谱的增强检索(GraphRAG)架构,将彻底超越简单的向量匹配,为未来的自动化智能体提供精准的导航路标。
基础理论:基于图谱的推理网络
在传统的思维定式中,文件夹是层级化的、线性的,而真实的知识是网状的。为了让 AI 能够像人类一样进行联想记忆,我们必须在底层物理层面改变数据的存储结构。
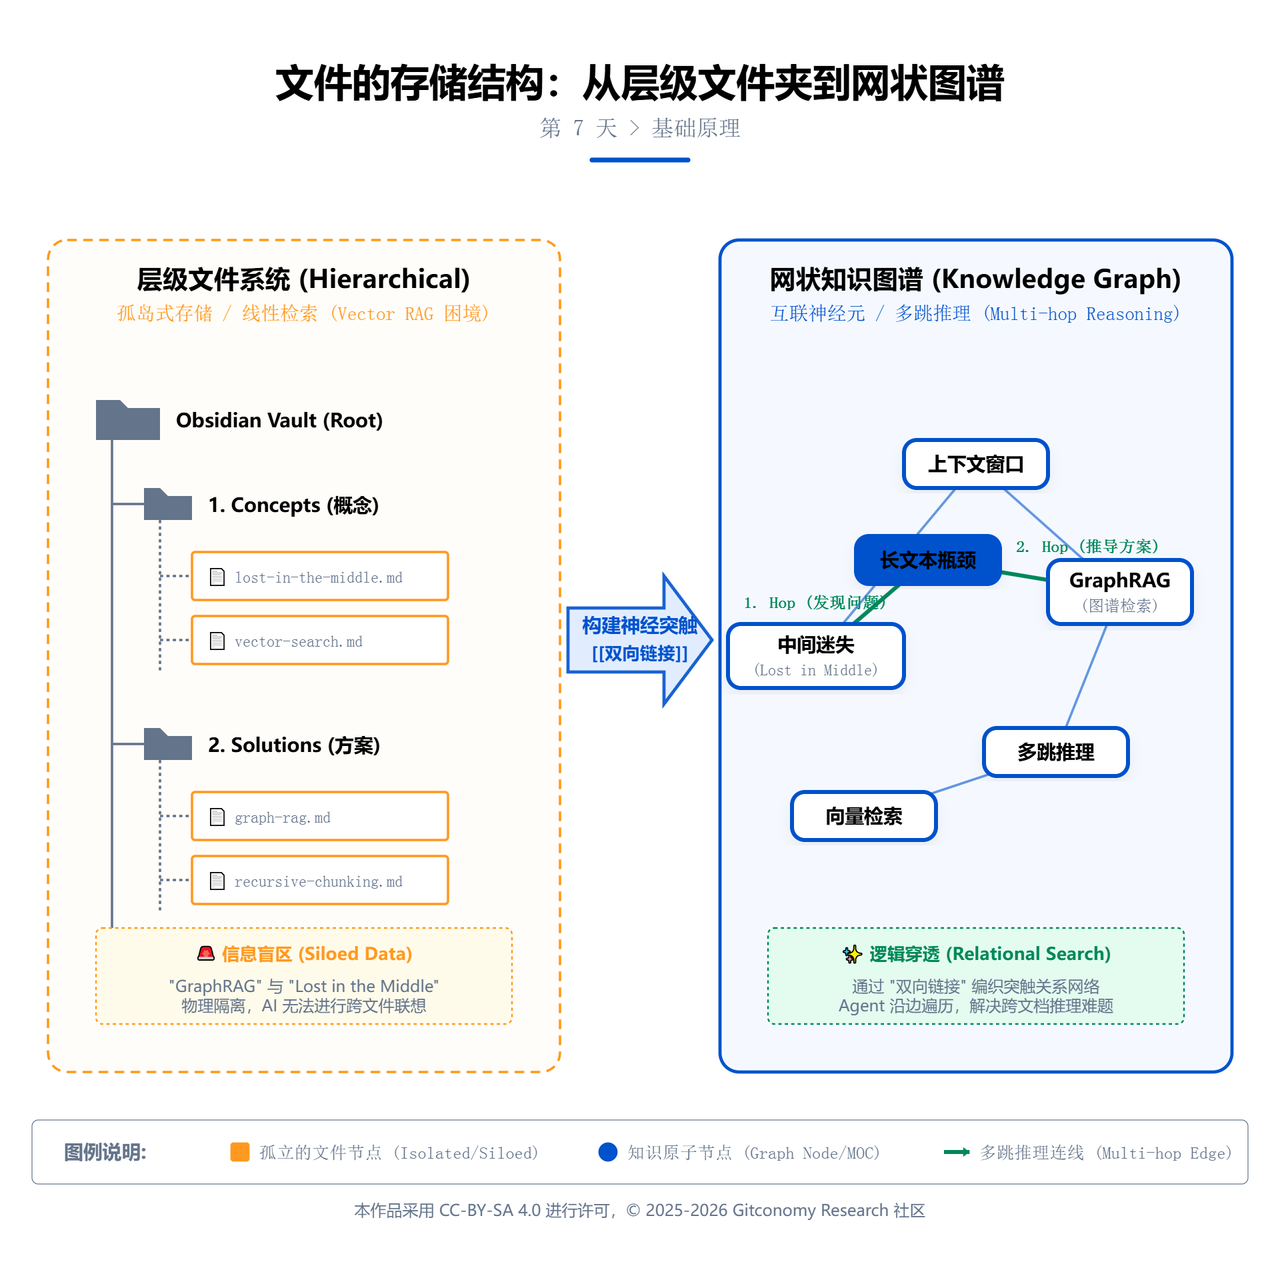
图7-1:文件结构与网状图谱结构对比
2.1 从孤岛笔记到神经回路:链接的物理意义
想象一下你的原子笔记是大脑中的一个个神经元。第六天的数据契约(元数据)为每个神经元赋予了类型(是运动神经元还是感觉神经元?),但神经元之间如果没有突触连接,它们就无法形成回路,无法协同工作,无法产生智能。
在Obsidian中,双向链接 [[笔记名称]] 就是这些突触。当你在一篇笔记中引用另一篇笔记时,你不仅创建了一个跳转链接,更是在两个概念之间建立了一条语义通路。这条通路会被Obsidian的后台索引捕捉,形成一张机器可读的知识图谱。如果没有链接,你的笔记库只是一个文件系统;有了链接,它才是一个第二大脑。
•
原子笔记 (Nodes)*= 神经元:存储具体的信息单元(如一个概念、一个数据)。
•
双向链接 (Edges) = 突触:传递信号的桥梁。
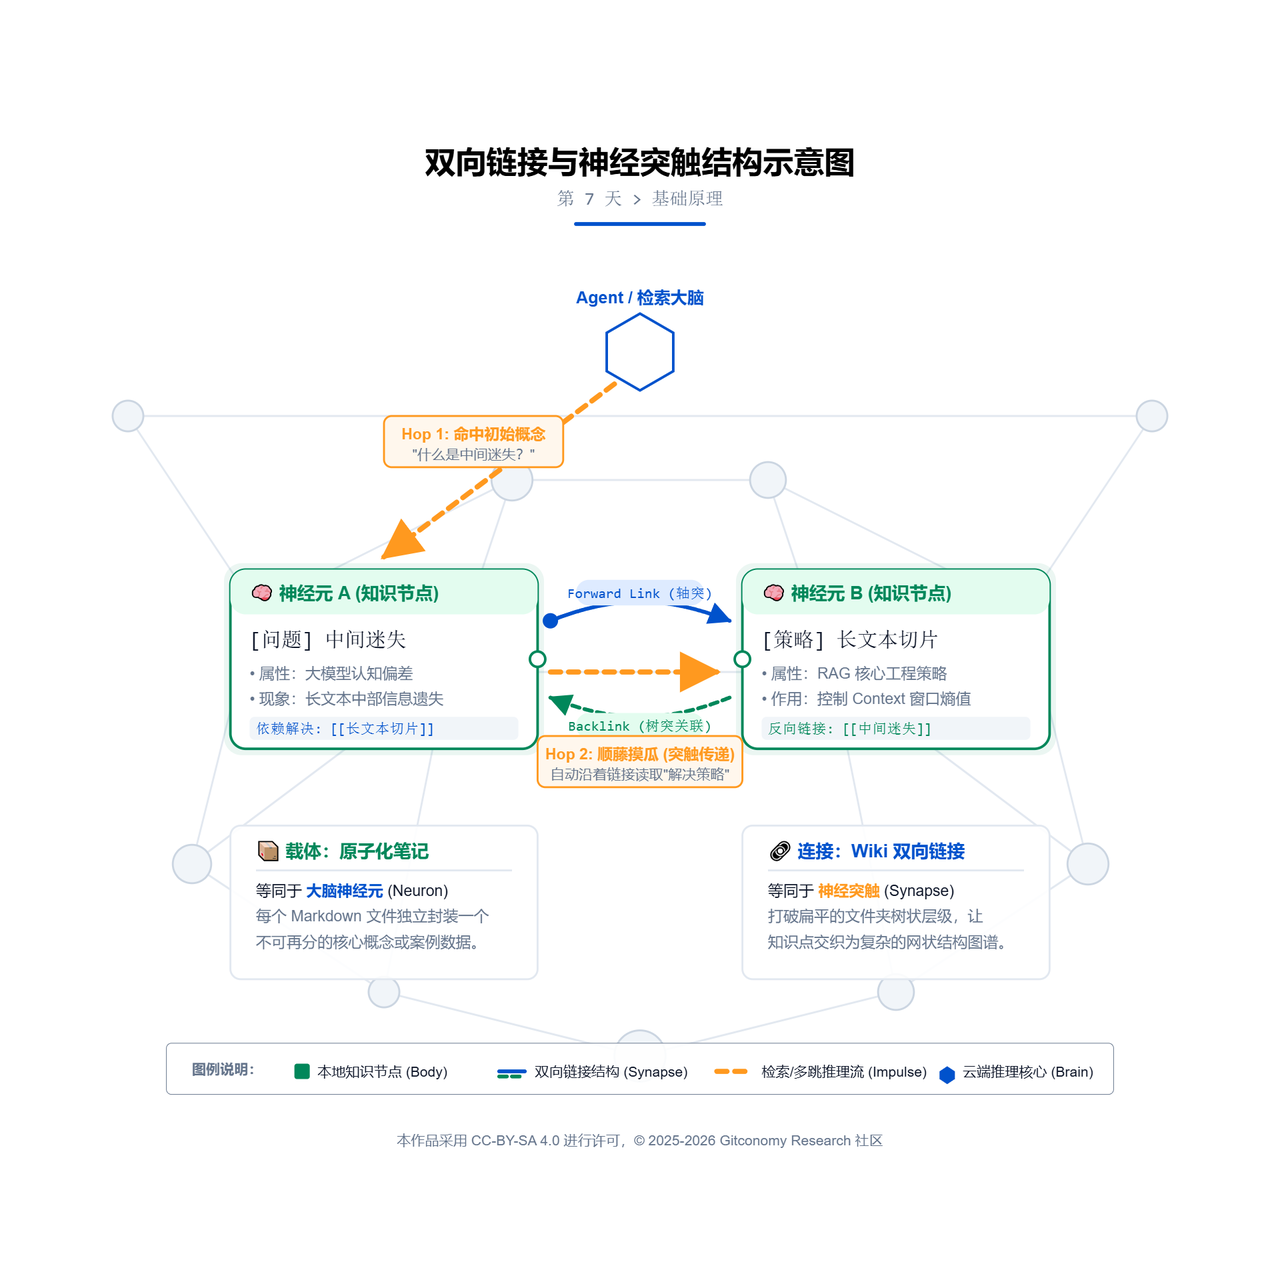
图7-2:从层级文件夹到网状知识图谱的演进
2.2 向量检索的局限与 GraphRAG 的崛起
目前大多数 AI 教程所教授的 RAG(检索增强生成)系统,主要依赖 向量检索 (Vector Search)。其原理是将用户提问转化为高维向量,然后通过余弦相似度寻找“长得像”的文本片段。但这在工程实践中存在严重的逻辑盲区。
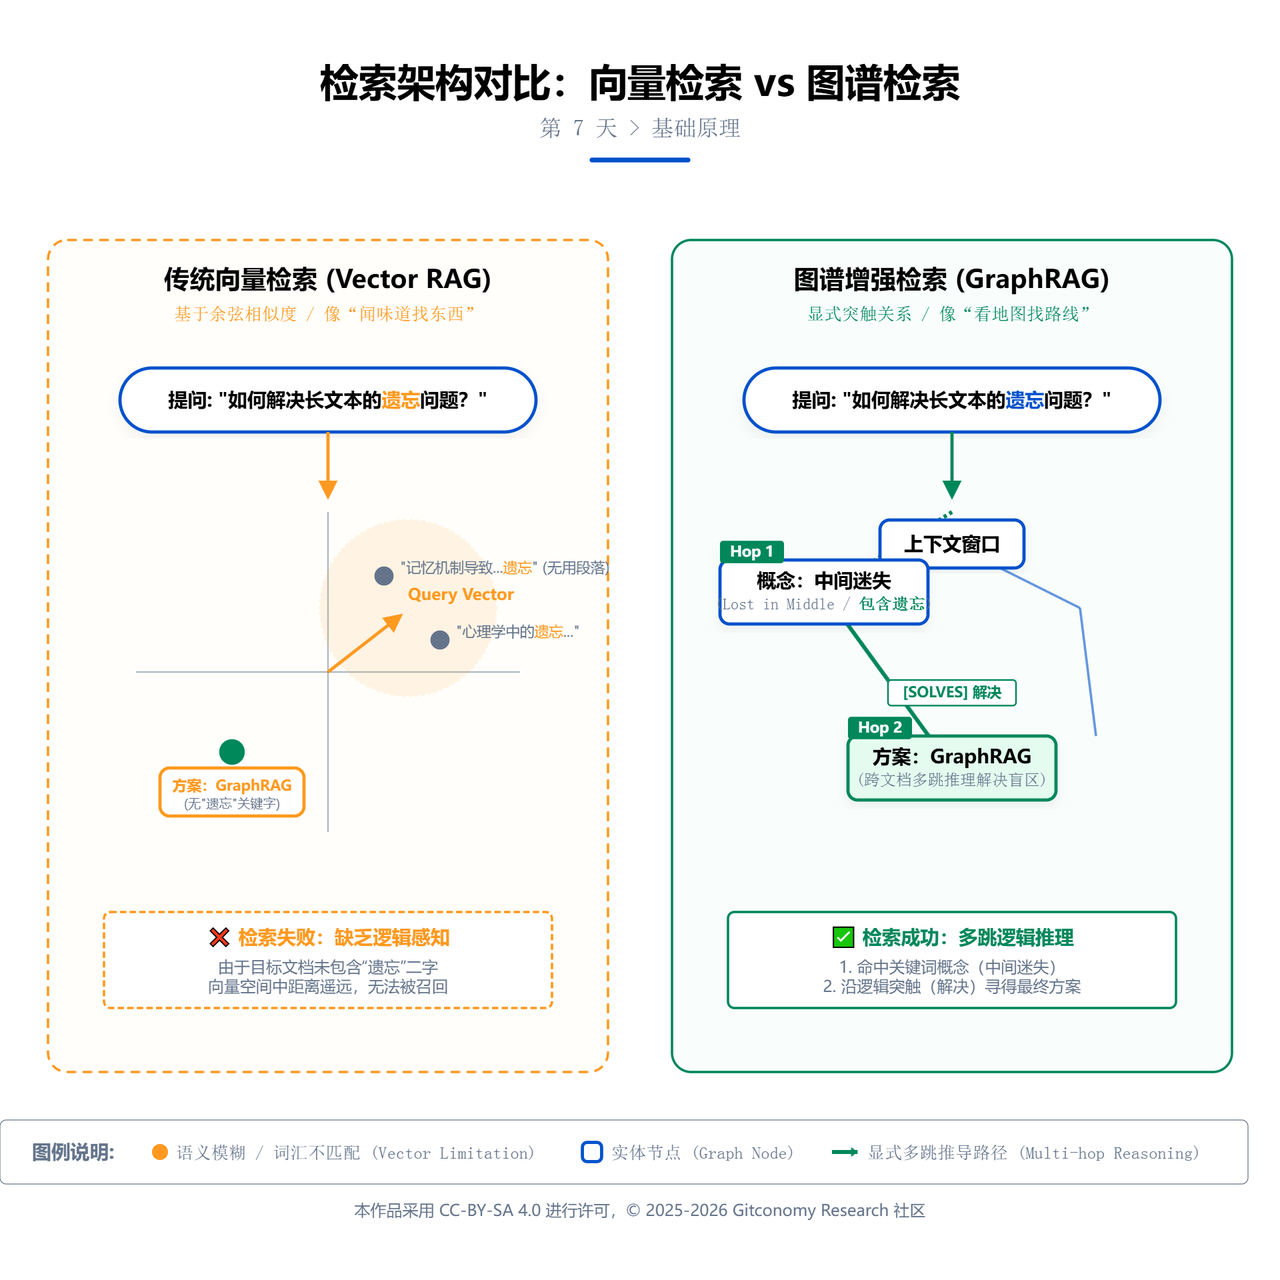
图7-3:向量检索与图谱检索比较
#AXuFVwwqztgn text { white-space: pre; }#AXuFVwwqztgn .fb0 { stroke: var(--N900-FG, 0.15); }#AXuFVwwqztgn .fb0 {stroke: rgba(31,35,41, 0.15)}#AXuFVwwqztgn .fx0 { stroke-miterlimit: 10; }#AXuFVwwqztgn .fx0 {stroke-miterlimit: 10}#AXuFVwwqztgn .fa1 { fill: rgb(187, 191, 196); }#AXuFVwwqztgn .fa1 {fill: rgb(187, 191, 196)}#AXuFVwwqztgn .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#AXuFVwwqztgn .fx1 {font-style: normal}#AXuFVwwqztgn .fx2 { text-anchor: middle; }#AXuFVwwqztgn .fx2 {text-anchor: middle}#AXuFVwwqztgn .fx3 { dominant-baseline: central; }#AXuFVwwqztgn .fx3 {dominant-baseline: central}#AXuFVwwqztgn .fx4 { stroke: none; }#AXuFVwwqztgn .fx4 {stroke: none}#AXuFVwwqztgn .fc0 { fill: var(--text-caption); }#AXuFVwwqztgn .fc0 {fill: #646a73}#AXuFVwwqztgn .fa2 { fill: var(--text-link-disabled); }#AXuFVwwqztgn .fa2 {fill: rgb(187, 191, 196)}#AXuFVwwqztgn .fa3 { fill: rgb(31, 35, 41); }#AXuFVwwqztgn .fa3 {fill: rgb(31, 35, 41)}#AXuFVwwqztgn .fx5 { font: 700 14px LarkHackSafariFont, LarkEmojiFont, "Microsoft YaHei", -apple-system, BlinkMacSystemFont, "Helvetica Neue", Helvetica, "Noto Sans", Tahoma, "Nimbus Sans L", Arial, "Liberation Sans", "PingFang SC", "Hiragino Sans GB", "Noto Sans CJK SC", "Source Han Sans SC", "Source Han Sans CN", "Microsoft YaHei", "Wenquanyi Micro Hei", "WenQuanYi Zen Hei", STHeiti, SimHei, sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji", system-ui; }#AXuFVwwqztgn .fx5 {font-style: normal}#AXuFVwwqztgn .fx6 { text-anchor: start; }#AXuFVwwqztgn .fx6 {text-anchor: start}#AXuFVwwqztgn .fx7 { dominant-baseline: alphabetic; }#AXuFVwwqztgn .fx7 {dominant-baseline: alphabetic}#AXuFVwwqztgn .fc1 { fill: rgb(255, 255, 255); }#AXuFVwwqztgn .fc1 {fill: rgb(255, 255, 255)}#AXuFVwwqztgn .fc2 { fill: rgb(5, 16, 26); }#AXuFVwwqztgn .fc2 {fill: rgb(5, 16, 26)}#AXuFVwwqztgn .fx8 { font: 400 14px LarkHackSafariFont, LarkEmojiFont, "Microsoft YaHei", -apple-system, BlinkMacSystemFont, "Helvetica Neue", Helvetica, "Noto Sans", Tahoma, "Nimbus Sans L", Arial, "Liberation Sans", "PingFang SC", "Hiragino Sans GB", "Noto Sans CJK SC", "Source Han Sans SC", "Source Han Sans CN", "Microsoft YaHei", "Wenquanyi Micro Hei", "WenQuanYi Zen Hei", STHeiti, SimHei, sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji", system-ui; }#AXuFVwwqztgn .fx8 {font-style: normal}#AXuFVwwqztgn .fb1 { fill: var(--N900-FG, 0.15); }#AXuFVwwqztgn .fb1 {fill: rgba(31,35,41, 0.15)}#AXuFVwwqztgn .fb2 { fill: rgb(221, 221, 221); }#AXuFVwwqztgn .fb2 {fill: rgb(221, 221, 221)}#AXuFVwwqztgn .fa4 { fill: var(--bg-body); }#AXuFVwwqztgn .fa4 {fill: #fff}ABC12345比较维度传统向量检索 (Vector RAG)知识图谱增强检索 (GraphRAG)匹配逻辑逻辑感知多跳推理能力全局视角基于语义的模糊相似度。极弱。无法感知因果、包含或对立关系。几乎为零。无法回答需要跨文档推导的问题。只能寻找局部碎片(Local Search)。基于显式的物理连接与逻辑关系。极强。通过有向边 (Edges) 定义严谨的逻辑。优秀。能够沿着 A -> B -> C 的路径进行网络遍历。能通过社区发现(Community)生成全景摘要。
表 7-1:向量检索 (Vector RAG) 与图谱检索 (GraphRAG) 的工程对比
多跳推理的威力:假设用户提问 “如何解决长文本中的信息遗忘问题?” 如果使用纯向量检索,由于目标笔记中可能只写了“递归切片”或“GraphRAG”等技术名词,没有出现“遗忘”这个词,检索极其容易失败。 而在 GraphRAG 架构下,智能体会沿着网络进行 多跳推理:
Hop 1:检索到 lost-in-the-middle.md(中间迷失现象),其中包含“首因效应”与“信息遗忘”。
Hop 2:智能体顺着图谱中的边 (Edge) 发现,该现象被 graph-rag.md 链接,且关系定义为“解决方案”。
结论输出:智能体沿着路径成功推导出答案。即使它没在方案笔记里看到“遗忘”二字,也能通过网络拓扑结构锁定靶点。
图7-4:知识图谱多跳推理示意
💡 极客洞察:向量检索像是让AI“闻味道找东西”——只能找到气味相似的;而图谱检索是让AI“看地图找路线”——能看到事物之间的连接路径,找到即使看起来不像但逻辑相关的内容。
2.3 双向链接的魔法:反向链接的力量
在Obsidian中,链接的真正力量来自双向性。当你在“GraphRAG.md”中写下 [[Lost in the Middle]] 时,Obsidian会自动在“Lost in the Middle.md”笔记的底部(或侧边栏)创建一个反向链接区域,显示所有链接到该笔记的其他笔记。
这个简单的机制产生了两个重要效应:
上下文外显化:你不需要记住所有链接,系统会帮你展示。当阅读“中间迷失”时,你能立刻看到哪些解决方案链接到了它。
关系涌现:随着链接增多,你会注意到某些笔记成为了枢纽节点(有很多笔记链接到它),这往往标志着核心概念或关键问题。
实战演练:编织智能体的局部网络
场景: 打开你的 Obsidian 仓库。此时,我们在第五天切分出的原子笔记正孤零零地躺在文件夹里。
•
📄 笔记 A:lost-in-the-middle.md (中间迷失现象) —— [问题]
•
📄 笔记 B:graph-rag.md (知识图谱增强检索) —— [方案]
虽然我们知道“GraphRAG 是解决中间迷失的手段之一”,但 AI 不知道。在 AI 眼里,这是两个完全无关的文件。我们的任务是建立连接,打通推理路径。
图7-5:第 7 天实验流程
3.1 步骤一:手动建立“强连接” (Explicit Linking)
首先,我们体验一下最基础的“神经突触”构建——手动双向链接。
找到 【特征/优缺点】 部分。
我们想在这里补充说明 GraphRAG 解决了什么问题。请在编辑器中输入 [[,Obsidian 会自动弹出笔记列表,选择 lost-in-the-middle。
修改后的笔记代码:
✨ 效果验收:
•
在 预览模式 下,[[lost-in-the-middle]] 变成了蓝色的可点击链接。
•
当你把鼠标悬停在链接上,会浮现出“中间迷失”的卡片预览。这意味着两条知识已经物理连接了。
3.2 步骤二:使用 AI 发现“隐性连接” (Librarian Agent)
当你有 1000 条笔记时,手动连线是不现实的。我们需要训练一个 “AI 图书管理员”,让它帮我们阅读笔记,并自动发现逻辑关系。
请使用以下 Prompt,将第5天的两段切片内容喂给 AI:
📋 提示词设计:关系挖掘机 (Relationship Miner)
代码块
Markdown
**S (Role)**: 你是一位资深的知识图谱架构师 (Librarian Agent),擅长在非结构化文本中发现深层的逻辑关联,并构建可供机器遍历的图谱网络。
// 注释:设定专业角色,激活大模型在知识图谱和逻辑推理领域的专业权重。
**C (Context)**: 我正在构建一个关于生成式 AI 的本地图谱。目前有两个独立的原子笔记,需要评估它们之间是否存在可以建立双向链接的语义通道。
// 注释:明确任务背景,指出当前面临的“信息孤岛”问题。
**O (Objective)**: 请阅读我提供的【笔记 A】和【笔记 B】,分析它们之间是否存在强逻辑关系,并输出标准的 Markdown 追加文本。
// 注释:明确动作,触发关系提取的思维链。
**R (Requirements - 契约约束)**:
🤖 AI 输出结果演示
当你运行上述 Prompt 后,AI 应该会输出类似以下内容的建议:
Text Generator输出的结果示例:
代码块
Markdown
Tars输出的结果示例:
代码块
Markdown
- **概括主张**:
- 笔记A的核心主张:中间迷失现象导致长文本中间部分信息难以召回(如未切分的超长文本处理瓶颈)。
- 笔记B的核心主张:GraphRAG通过实体关系图谱构建解决多跳推理弱项问题,擅长跨文档全局性问题处理。
- **寻找交集**:
- 两篇笔记均涉及解决文本信息处理问题。
- 图谱技术(GraphRAG)可显式连接跨文档关系,间接延伸至单一文档内部矛盾(如中间迷失现象):
▶️ 通过图谱聚类将中间迷失的关键信息纳入关系链中
▶️ 用显式关系替代隐式上下文,绕过物理长度限制
💡 提示工程技巧:要让AI准确提取关系,可以使用思维链 (CoT) 技巧。在Prompt中加入:“请按以下步骤思考:1. 概括每个笔记的核心主张;2. 寻找主张之间的逻辑交集;3. 对照关系类型定义选择最匹配的。”
3.3 步骤三:点亮图谱 (Graph View)
现在,我们将这些微小的连接可视化。
在 Obsidian 中完成上述修改(将 AI 建议的链接贴入笔记)。
点击左侧边栏的 “打开图谱视图 (Open graph view)”。
见证时刻:
•
你应该能看到 graph-rag 和 lost-in-the-middle 两个点之间,出现了一条连线。
•
这代表你的知识库不再是散乱的沙子,而开始结晶成网。
💡 架构师视点: 未来的 Agent 在回答问题时,就不会只盯着关键词匹配了。当你问“_GraphRAG 为什么比传统 RAG 好?_”时,Agent 会顺着这条线爬到 lost-in-the-middle,然后回答:“因为它解决了长文本中间信息易丢失的物理缺陷。” —— 这就叫“多跳推理 (Multi-hop Reasoning)。
3.4 继续编织
请尝试用同样的方法(手动或 AI),建立以下 Day 5 笔记之间的连接:
Recursive Character Splitting (递归切片) →→ Fixed-Size Chunking (固定切片)
◦
_提示关系_:IMPROVES_ON (改进了…)
PEAR Model (PEAR模型) →→ Reflection Pattern (反思模式)
◦
_提示关系_:CONTAINS (包含…作为其子步骤)
进阶思考:链接作为“意图的路径”
4.1 链接即导航:AI Agent的未来“行走路径”
在未来的智能体系统中,双向链接不仅仅是人类浏览时的跳转工具,更是AI Agent的导航路标。
想象这样一个场景:你的智能体需要回答“如何为我的研究论文构建一个智能文献管理系统?”这个复杂问题。在没有图谱的系统中,智能体可能只能进行关键词检索,找到一些零散的笔记。
但在有图谱的系统中,智能体可以:
路径规划:识别用户意图中的关键概念(“研究论文”、“文献管理”)
图遍历:从相关节点出发,沿着链接探索相关概念:
综合回答:沿着这些路径收集到的信息,智能体可以构建一个完整的解决方案,而不仅仅是堆砌相关笔记。
4.2 MOC:为知识图谱建立“骨架”
当笔记和链接数量增多时,图谱可能变得过于复杂而难以导航。这时,我们需要Map of Content(MOC)——一种特殊的笔记,作为某个主题的“目录”或“入口”。
如何创建MOC:
新建笔记“RAG技术全景图.md”
使用标题组织结构:
代码块
Markdown
为每个列表项添加简短说明,解释该笔记在此上下文中的意义
👍
MOC的价值:
•
人类友好:提供主题的鸟瞰视图,避免在数百个链接中迷失
•
机器友好:MOC本身成为一个高级节点,智能体可以先访问MOC理解整体结构,再深入细节
•
版本控制:当知识演进时,更新MOC比更新所有分散的链接更容易
本章总结
本章超越了传统的向量检索范式,引入了 GraphRAG 的图谱推理思想。你学会了通过双向链接在概念之间建立显式的语义通路,使智能体能够执行“多跳推理”——沿着 A → B → C 的路径发现隐含关联。知识的价值不在节点本身,而在节点之间的连接。向量检索是“闻味道”,图谱检索是“看地图”——后者能到达前者无法企及的推理深度。
👍
💡 知识的价值不在节点本身,而在节点之间的连接——双向链接是构建第二大脑的神经突触。
下一章预告:知识网络已编织完毕,但 AI 仍被动等待你的指令。第8章将引入 PEAR 闭环与 ReAct 范式——赋予智能体自主感知、规划、执行与反思的能力,使其从“问答机器”进化为“自主行动者”。
课后思考
链接的噪音问题
如果每篇笔记都过度链接到其他所有相关笔记(“连接一切”的极端),会对检索造成什么负面影响?如何通过“链接类型”(如solves:、contrasts:、evidences:这样的前缀)或链接权重来解决这个问题?
动态图谱vs静态图谱
我们今天构建的是相对静态的图谱(基于显式链接)。但真实世界的知识关系是动态演化的。如何设计一个系统,让AI能够基于新的上下文动态发现并建议新链接,甚至淘汰过时链接?
规模化挑战
当知识库增长到数万笔记、数十万链接时,Obsidian的图谱视图可能会变得难以渲染和解读。有哪些工程策略可以管理超大规模的知识图谱?(提示:分层、聚类、子图隔离)
附录 1:核心术语表 (Glossary)