第九章:提示词与思维链 (CoT) 高级技巧实战指南
⛓️
思维链 (Chain of Thought, CoT) 提示词是解锁大语言模型 (LLM) 高级推理能力的秘密武器。只需简单地要求 AI “一步一步地思考”,或为其提供分步推导的示例,你就能迫使模型为当前问题分配更多的算力。本指南将带你全面掌握 Zero-Shot CoT、Few-Shot CoT、自洽性 (Self-Consistency) 以及思维树 (ToT) 等前沿技巧。
核心要点
•
算力就是逻辑:CoT 迫使 LLM 生成更多的 Token,这实际上是给了它更多的“测试时算力(Test-Time Compute)”来解决问题。
•
Zero-Shot vs Few-Shot:虽然“一步一步思考”很管用,但直接在 Prompt 中提供 2-3 个具体的推理示例(Few-Shot)能带来高得多的准确率。
•
集成方法:自洽性 (Self-Consistency) 会多次运行 CoT 并取多数票结果,这能极大地降低模型的幻觉率。
•
复杂规划:对于需要前瞻性规划的任务(如创意写作或复杂的代码架构设计),请使用思维树 (ToT) 策略。
为什么我们需要思维链?
传统的提示词(Standard Prompting)要求模型直接从问题跳到答案。对于简单的事实查询(“法国的首都是哪里?”),这非常有效。
然而,在处理算术题、逻辑谜题或复杂的编程任务时,标准提示词往往会失败。为什么?因为 LLM 是逐个 Token 生成文本的。如果它不把中间的推导步骤输出出来,它就没有足够的“工作记忆(Working Memory)”来暂存中间计算结果。
思维链 (CoT) 通过强制模型大声说出其内部的推理过程解决了这个问题。通过把步骤写下来,模型就能“读”到自己的逻辑,从而顺理成章地推导出正确的最终答案。
Zero-Shot CoT:一句神奇的咒语
在 Kojima 等人于 2022 年发表的一篇突破性论文中,Zero-Shot CoT 证明了:你甚至不需要提供任何示例,就能让模型进行严密的逻辑推理。
你只需要在 Prompt 的最后附加上这句神奇的咒语: 👉 "Let's think step by step."(让我们一步一步来思考。)
对比示例:
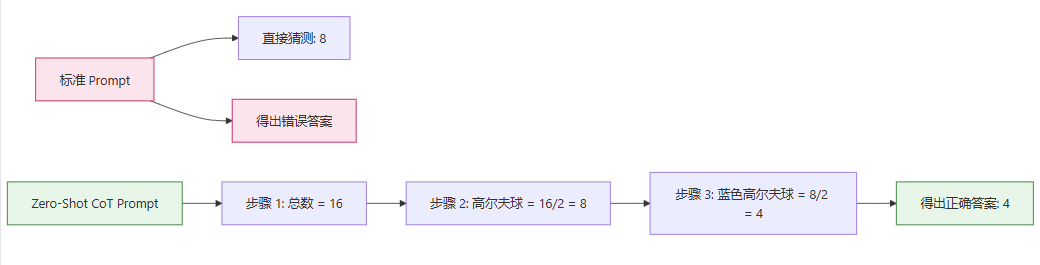
标准 Prompt(通常会失败): 杂技演员能同时抛接 16 个球。其中一半是高尔夫球,高尔夫球中又有一半是蓝色的。请问有多少个蓝色的高尔夫球?
Zero-Shot CoT Prompt(成功解题): 杂技演员能同时抛接 16 个球。其中一半是高尔夫球,高尔夫球中又有一半是蓝色的。请问有多少个蓝色的高尔夫球? 让我们一步一步来思考。
Few-Shot CoT:用示例引导思考
虽然 Zero-Shot 极其简单,但对于生产环境而言,Wei 等人提出的 Few-Shot CoT 才是最可靠的选择。在这种方法中,你需要在 Prompt 里提供几个带有完整推导过程的示例(Shots),明确地向模型演示应该如何进行推理。
代码块
Plain Text
问:罗杰有 5 个网球。他又买了 2 罐网球,每罐有 3 个。他现在有多少个网球?
答:罗杰一开始有 5 个球。2 罐网球,每罐 3 个,就是 6 个网球。5 + 6 = 11。答案是 11。
问:食堂原来有 23 个苹果。如果他们用 20 个做午餐,又买了 6 个,他们现在有多少个苹果?
答:食堂最初有 23 个苹果。他们用 20 个做午餐,所以还剩 23 - 20 = 3 个。他们又买了 6 个,所以现在有 3 + 6 = 9 个。答案是 9。
通过提供这些示例,模型在解答你的实际问题时,会完美地模仿你设定的推理风格和输出格式。
自洽性 (Self-Consistency):投票的力量
自洽性 (Self-Consistency) 将 CoT 推向了新的高度。由于大模型在生成文本时带有一定的随机性(受 temperature 参数控制),如果你将同一个 CoT Prompt 运行 5 次,可能会得到 5 条略有不同的推理路径。
自洽性的工作原理如下:
针对同一个问题,让模型生成多条不同的推理路径(例如 5 条)。
从每条路径的末尾提取最终答案。
采取“多数表决(Majority Vote)”机制。
如果 4 条路径得出的答案是“42”,而 1 条路径得出的答案是“40”,系统就会输出 42。这种集成方法能极大地降低大模型在数学和逻辑任务中的幻觉率。
思维树 (ToT):高级逻辑探索
当任务需要复杂的战略规划(例如写小说、解数独、或设计软件架构)时,单线的 CoT 就显得力不从心了。
思维树 (Tree of Thoughts, ToT) 引导模型生成多个可能的“下一步”,评估每个步骤的潜力,并有意识地选择最好的一条路径继续走下去。如果发现当前路径是一条死胡同,模型还能回溯(Backtrack)到上一个节点重新选择。
ToT 提示词示例(简化版):
代码块
Plain Text
假设有 3 位不同的专家正在解答这个问题。
所有专家都会写下他们思考的第一步,然后与大家分享。
接着,所有专家会基于讨论继续写下第二步,以此类推。
如果在任何时候,某位专家意识到自己的思路是错的,他就会退出讨论。
问题是:[插入极其复杂的问题]
CoT 提示词的最佳实践
使用分隔符:要求模型将其推理过程包裹在
结合 System Prompt:将你的 Few-Shot CoT 示例放在系统提示词(System Prompt)中,以确保模型在整个多轮对话中严格遵守你的推理格式。
注意上下文窗口:CoT 会生成海量的 Token。请务必将 API 的 max_tokens 参数设置得足够大,否则模型的推理过程可能会在半途被强制截断。
⚠️ 常见错误:
•
在简单的事实查询中使用 CoT → 纠正:千万不要对“日本的首都是哪里?”这样的问题使用“一步一步思考”。这纯粹是在浪费 Token 成本,且徒增延迟,没有任何好处。
•
在 Few-Shot 示例中提供错误的推理逻辑 → 纠正:仔细检查你提供的示例!如果你给的逻辑是错的,模型会盲目地复制你的错误逻辑。
常见问题 (FAQ)
Q1:CoT 在较小的模型(比如 7B 参数的模型)上有效吗?
CoT 表现出一种“涌现(Emergent)”特性。它在超大参数模型(如 GPT-4 或 Claude 3.5)上表现得如同魔法般神奇;但在较小的模型(100 亿参数以下)上,模型往往很难在漫长的推理链中保持逻辑的连贯性,容易中途跑偏或产生混乱的输出。
Q2:新的推理模型(如 OpenAI o1、DeepSeek R1)与 CoT 是什么关系?
像 OpenAI o1 和 DeepSeek R1 这样的模型,已经将 CoT 硬编码到了它们的底层架构中。它们通过强化学习,在后台自动生成隐藏的思维链。对于这些模型,你反而不应该在 Prompt 中添加“一步一步思考”,因为这会干扰它们原生的推理过程。
Q3:使用 CoT 会更贵吗?
是的。因为各大 API 的计费方式是基于生成的 Token 数量的。强制模型在输出 10 个字的最终答案前,先写下 200 字的推理过程,会显著增加你的 API 调用成本。
总结
思维链 (CoT) 提示词是 AI 开发者不可或缺的工具。无论你是使用简单的 Zero-Shot 咒语,严谨的 Few-Shot 示例,还是高级的自洽性投票机制,CoT 都能将 LLM 从一个简单的文本预测器,改造为一个强大的逻辑推理引擎。