第五章:什么是LLM幻觉?检测与防范AI生成错误的实用方法
🤖
大语言模型(LLM)正在改变我们与技术交互的方式,但它们有一个令人头疼的问题:幻觉(Hallucination)。当AI自信满满地告诉你一个根本不存在的"事实"时,这就是幻觉现象。理解并解决这个问题,是构建可靠AI应用的关键。
核心要点
•
幻觉定义:LLM生成看似合理但实际错误或虚构的内容
•
三大类型:事实性错误、逻辑矛盾、虚构引用
•
根本原因:训练数据局限、概率采样机制、知识截止日期
•
检测方法:交叉验证、知识库比对、一致性检查、置信度分析
•
解决策略:RAG增强、提示工程优化、温度调节、多模型验证
什么是LLM幻觉
LLM幻觉是指大语言模型生成的内容看起来流畅、自信,但实际上包含错误、虚假或无中生有的信息。这种现象之所以被称为"幻觉",是因为模型表现得好像它"看到"了并不存在的东西。
幻觉的典型表现
#DRqgKNOfUFBW text { white-space: pre; }#DRqgKNOfUFBW .fb0 { stroke: var(--N900-FG, 0.15); }#DRqgKNOfUFBW .fb0 {stroke: rgba(31,35,41, 0.15)}#DRqgKNOfUFBW .fx0 { stroke-miterlimit: 10; }#DRqgKNOfUFBW .fx0 {stroke-miterlimit: 10}#DRqgKNOfUFBW .fa1 { fill: rgb(187, 191, 196); }#DRqgKNOfUFBW .fa1 {fill: rgb(187, 191, 196)}#DRqgKNOfUFBW .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#DRqgKNOfUFBW .fx1 {font-style: normal}#DRqgKNOfUFBW .fx2 { text-anchor: middle; }#DRqgKNOfUFBW .fx2 {text-anchor: middle}#DRqgKNOfUFBW .fx3 { dominant-baseline: central; }#DRqgKNOfUFBW .fx3 {dominant-baseline: central}#DRqgKNOfUFBW .fx4 { stroke: none; }#DRqgKNOfUFBW .fx4 {stroke: none}#DRqgKNOfUFBW .fc0 { fill: var(--text-caption); }#DRqgKNOfUFBW .fc0 {fill: #646a73}#DRqgKNOfUFBW .fa2 { fill: var(--text-link-disabled); }#DRqgKNOfUFBW .fa2 {fill: rgb(187, 191, 196)}#DRqgKNOfUFBW .fa3 { fill: rgb(31, 35, 41); }#DRqgKNOfUFBW .fa3 {fill: rgb(31, 35, 41)}#DRqgKNOfUFBW .fx5 { font: 400 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#DRqgKNOfUFBW .fx5 {font-style: normal}#DRqgKNOfUFBW .fx6 { text-anchor: start; }#DRqgKNOfUFBW .fx6 {text-anchor: start}#DRqgKNOfUFBW .fx7 { dominant-baseline: alphabetic; }#DRqgKNOfUFBW .fx7 {dominant-baseline: alphabetic}#DRqgKNOfUFBW .fc1 { fill: rgb(255, 255, 255); }#DRqgKNOfUFBW .fc1 {fill: rgb(255, 255, 255)}#DRqgKNOfUFBW .fx8 { font: 700 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#DRqgKNOfUFBW .fx8 {font-style: normal}#DRqgKNOfUFBW .fc2 { fill: rgb(51, 51, 51); }#DRqgKNOfUFBW .fc2 {fill: rgb(51, 51, 51)}#DRqgKNOfUFBW .fb1 { fill: var(--N900-FG, 0.15); }#DRqgKNOfUFBW .fb1 {fill: rgba(31,35,41, 0.15)}#DRqgKNOfUFBW .fb2 { fill: rgb(225, 228, 232); }#DRqgKNOfUFBW .fb2 {fill: rgb(225, 228, 232)}#DRqgKNOfUFBW .fa4 { fill: var(--bg-body); }#DRqgKNOfUFBW .fa4 {fill: #fff}ABC1234567表现形式示例危害程度虚构事实错误引用数据捏造时间错误逻辑矛盾过度泛化声称某人获得了从未获得的奖项引用不存在的论文或书籍编造统计数据和研究结果将事件放在错误的时间线上前后陈述自相矛盾将特例当作普遍规律高高高中中低
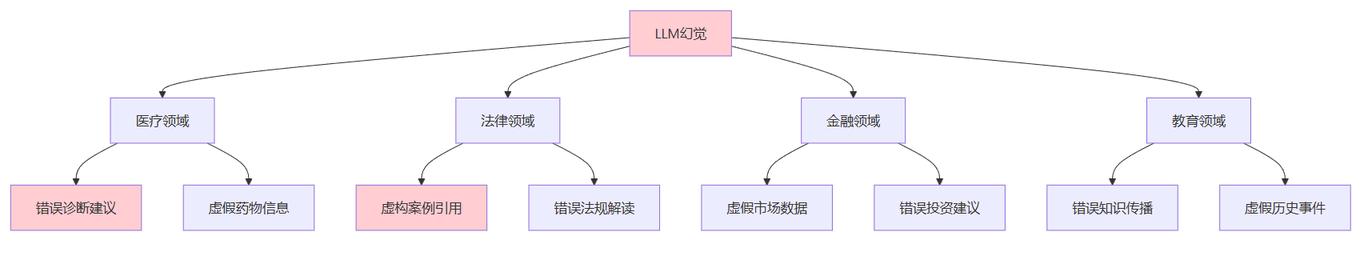
幻觉问题的严重性
幻觉的类型
LLM幻觉可以分为三大类型,每种类型都有其独特的特征和应对方法。
事实性错误(Factual Hallucination)
模型生成与现实世界事实不符的内容。
代码块
Python
user_query = "爱因斯坦是哪一年获得诺贝尔物理学奖的?"
hallucinated_response = "爱因斯坦于1905年因相对论获得诺贝尔物理学奖。"
correct_response = "爱因斯坦于1921年获得诺贝尔物理学奖,获奖原因是光电效应理论,而非相对论。"
特征:
•
涉及具体的人物、日期、数字
•
通常可以通过外部知识库验证
•
模型表现出高度自信
逻辑矛盾(Logical Inconsistency)
模型在同一回答或对话中产生自相矛盾的陈述。
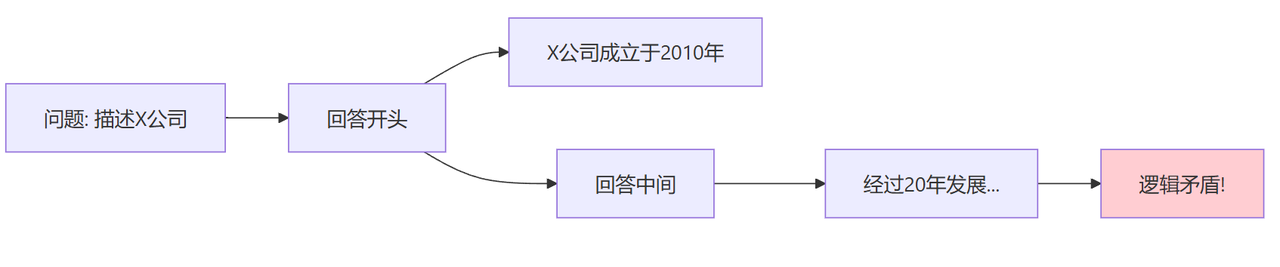
特征:
•
前后陈述不一致
•
数学计算错误
•
因果关系混乱
虚构引用(Fabricated References)
模型编造不存在的来源、论文、书籍或专家言论。
#FMpoSISQXCIa text { white-space: pre; }#FMpoSISQXCIa .fb0 { stroke: var(--N900-FG, 0.15); }#FMpoSISQXCIa .fb0 {stroke: rgba(31,35,41, 0.15)}#FMpoSISQXCIa .fx0 { stroke-miterlimit: 10; }#FMpoSISQXCIa .fx0 {stroke-miterlimit: 10}#FMpoSISQXCIa .fa1 { fill: rgb(187, 191, 196); }#FMpoSISQXCIa .fa1 {fill: rgb(187, 191, 196)}#FMpoSISQXCIa .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#FMpoSISQXCIa .fx1 {font-style: normal}#FMpoSISQXCIa .fx2 { text-anchor: middle; }#FMpoSISQXCIa .fx2 {text-anchor: middle}#FMpoSISQXCIa .fx3 { dominant-baseline: central; }#FMpoSISQXCIa .fx3 {dominant-baseline: central}#FMpoSISQXCIa .fx4 { stroke: none; }#FMpoSISQXCIa .fx4 {stroke: none}#FMpoSISQXCIa .fc0 { fill: var(--text-caption); }#FMpoSISQXCIa .fc0 {fill: #646a73}#FMpoSISQXCIa .fa2 { fill: var(--text-link-disabled); }#FMpoSISQXCIa .fa2 {fill: rgb(187, 191, 196)}#FMpoSISQXCIa .fa3 { fill: rgb(31, 35, 41); }#FMpoSISQXCIa .fa3 {fill: rgb(31, 35, 41)}#FMpoSISQXCIa .fx5 { font: 400 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#FMpoSISQXCIa .fx5 {font-style: normal}#FMpoSISQXCIa .fx6 { text-anchor: start; }#FMpoSISQXCIa .fx6 {text-anchor: start}#FMpoSISQXCIa .fx7 { dominant-baseline: alphabetic; }#FMpoSISQXCIa .fx7 {dominant-baseline: alphabetic}#FMpoSISQXCIa .fc1 { fill: rgb(255, 255, 255); }#FMpoSISQXCIa .fc1 {fill: rgb(255, 255, 255)}#FMpoSISQXCIa .fc2 { fill: rgb(51, 51, 51); }#FMpoSISQXCIa .fc2 {fill: rgb(51, 51, 51)}#FMpoSISQXCIa .fb1 { fill: var(--N900-FG, 0.15); }#FMpoSISQXCIa .fb1 {fill: rgba(31,35,41, 0.15)}#FMpoSISQXCIa .fb2 { fill: rgb(225, 228, 232); }#FMpoSISQXCIa .fb2 {fill: rgb(225, 228, 232)}#FMpoSISQXCIa .fa4 { fill: var(--bg-body); }#FMpoSISQXCIa .fa4 {fill: #fff}AB12345虚构类型示例虚假论文虚假书籍虚假专家虚假统计"根据Smith等人2023年在Nature发表的研究...""正如《AI的未来》一书第三章所述...""哈佛大学AI研究院院长John Doe教授指出...""据统计,95%的企业已采用AI技术..."
幻觉产生的原因
理解幻觉产生的根本原因,有助于我们采取针对性的解决策略。
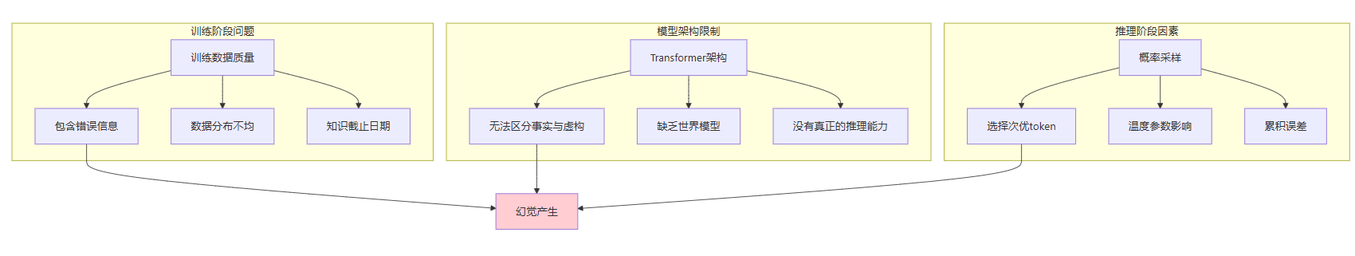
原因分析流程图
训练数据局限性
LLM从海量文本中学习,但这些数据本身就存在问题:
•
数据质量参差不齐:互联网数据包含大量错误信息
•
知识截止日期:模型无法获取训练后的新信息
•
数据偏差:某些领域的数据量远多于其他领域
概率采样机制
LLM本质上是"下一个词预测器",它基于概率选择输出:
代码块
Python
def simplified_llm_generation(prompt, temperature=1.0):
"""
简化的LLM生成过程演示
temperature越高,随机性越大,幻觉风险越高
缺乏真正的理解
LLM不具备真正的世界知识和推理能力:
表格加载中...
#FhwPJlUfrBgW text{white-space:pre}.fb0{stroke:var(--N900-FG, 0.15)}.fx0{stroke-miterlimit:10}.fa1{fill:#bbbfc4}.fx1{font:normal 400 12px MonospacedNumber,LarkHackSafariFont,LarkEmojiFont,LarkChineseQuote,-apple-system,BlinkMacSystemFont,Helvetica Neue,Tahoma,PingFang SC,Microsoft Yahei,Arial,Hiragino Sans GB,sans-serif,Apple Color Emoji,Segoe UI Emoji,Segoe UI Symbol,Noto Color Emoji}.fx2{text-anchor:middle}.fx3{dominant-baseline:central}.fx4{stroke:none}.fc0{fill:var(--text-caption)}.fa2{fill:var(--text-link-disabled)}.fa3{fill:#1f2329}.fx5{font:400 normal 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"}.fx6{text-anchor:start}.fx7{dominant-baseline:alphabetic}.fc1{fill:#ffffff}.fc2{fill:rgb(51, 51, 51)}.fb1{fill:var(--N900-FG, 0.15)}.fb2{fill:rgb(225, 228, 232)}.fa4{fill:var(--bg-body)}AB12345人类认知LLM处理理解概念的本质基于因果推理知道自己不知道什么可以验证信息学习词汇的统计关联基于模式匹配对所有问题都尝试回答无法访问外部知识
检测幻觉的方法
有效检测幻觉是减少其危害的第一步。
检测方法对比
表格加载中...
检测流程
减少幻觉的策略
策略概览
RAG检索增强生成
RAG是目前最有效的减少幻觉策略之一,通过引入外部知识库为LLM提供可靠的上下文。
代码块
Python
from langchain.vectorstores import Chroma
from langchain.embeddings import OpenAIEmbeddings
from langchain_openai import ChatOpenAI
def rag_with_hallucination_reduction(query, knowledge_base):
"""
使用RAG减少幻觉的示例
"""
embeddings = OpenAIEmbeddings()
vectorstore = Chroma.from_documents(knowledge_base, embeddings)
relevant_docs = vectorstore.similarity_search(query, k=5)
context = "\n".join([doc.page_content for doc in relevant_docs])
提示工程优化
精心设计的提示词可以显著减少幻觉:
代码块
Python
anti_hallucination_prompt = """
你是一个严谨的AI助手。在回答问题时,请遵循以下原则:
## 核心原则
1. **诚实性**:如果不确定,请明确说明
2. **可验证性**:尽可能提供可验证的信息来源
3. **保守性**:宁可少说,不要编造
## 回答格式
- 确定的信息:直接陈述
- 不确定的信息:使用"据我所知"、"可能"等限定词
- 无法回答:明确说明"我没有足够的信息来回答这个问题"
## 禁止行为
- 不要编造引用、统计数据或专家言论
- 不要虚构不存在的事件或人物
温度参数调节
温度参数直接影响输出的随机性和幻觉概率:
代码块
Python
def adjust_temperature_for_task(task_type):
多模型交叉验证
使用多个模型验证输出的一致性:
代码块
Python
def multi_model_verification(query, models):
"""
多模型交叉验证减少幻觉
代码实战:事实核查系统
下面是一个简单但实用的事实核查系统实现:
代码块
Python
import re
from typing import List, Dict, Anyfrom dataclasses import dataclass
from langchain_openai import ChatOpenAI
from langchain.embeddings import OpenAIEmbeddings
from langchain.vectorstores import Chroma
@dataclassclass FactCheckResult:
claim: str
verdict: str
confidence: float
evidence: List[str]
explanation: strclass HallucinationDetector:
"""LLM幻觉检测与事实核查系统"""def __init__(self, knowledge_base_path: str = None):
self.llm = ChatOpenAI(model="gpt-4-turbo", temperature=0)
self.embeddings = OpenAIEmbeddings()
self.knowledge_base = Noneif knowledge_base_path:
self.load_knowledge_base(knowledge_base_path)
常见问题
为什么LLM会产生幻觉?
LLM产生幻觉的根本原因在于其工作原理:它是基于概率预测下一个词,而非真正理解内容。模型没有区分事实与虚构的能力,也无法访问外部知识来验证自己的输出。训练数据中的错误信息和知识截止日期进一步加剧了这个问题。
如何判断AI输出是否可信?
判断AI输出可信度的方法包括:1)检查是否包含具体的、可验证的事实;2)使用搜索引擎或专业数据库交叉验证;3)注意模型是否使用了不确定性语言;4)对于关键决策,始终进行人工审核。
RAG能完全消除幻觉吗?
RAG可以显著减少但无法完全消除幻觉。RAG的效果取决于知识库的质量和覆盖范围。如果知识库本身包含错误,或者用户问题超出知识库范围,幻觉仍可能发生。最佳实践是将RAG与其他策略(如提示工程、温度调节)结合使用。
不同LLM的幻觉程度有差异吗?
是的,不同模型的幻觉倾向存在差异。一般来说,更大、更新的模型幻觉率较低。GPT-4、Claude 3等最新模型在减少幻觉方面有明显改进。但即使是最先进的模型也无法完全避免幻觉,因此验证机制始终必要。
如何在生产环境中处理幻觉风险?
生产环境中处理幻觉的最佳实践包括:1)实施RAG架构,确保回答基于可靠来源;2)设置置信度阈值,低于阈值时触发人工审核;3)建立反馈机制,持续收集和修正错误;4)对高风险场景(医疗、法律、金融)实施强制人工审核。
总结
LLM幻觉是当前AI应用面临的核心挑战之一。理解幻觉的类型、成因和检测方法,是构建可靠AI系统的基础。
关键要点回顾
✅ LLM幻觉 = 模型生成看似合理但实际错误的内容
✅ 三大类型:事实性错误、逻辑矛盾、虚构引用
✅ 根本原因:训练数据局限 + 概率采样 + 缺乏真正理解
✅ 核心策略:RAG增强、提示工程、温度调节、多模型验证
✅ 最佳实践:技术手段 + 人工审核相结合