一文读懂:Prompt、Context、Harness、Loop Engineering
核心观点:四层工程,缺一不可
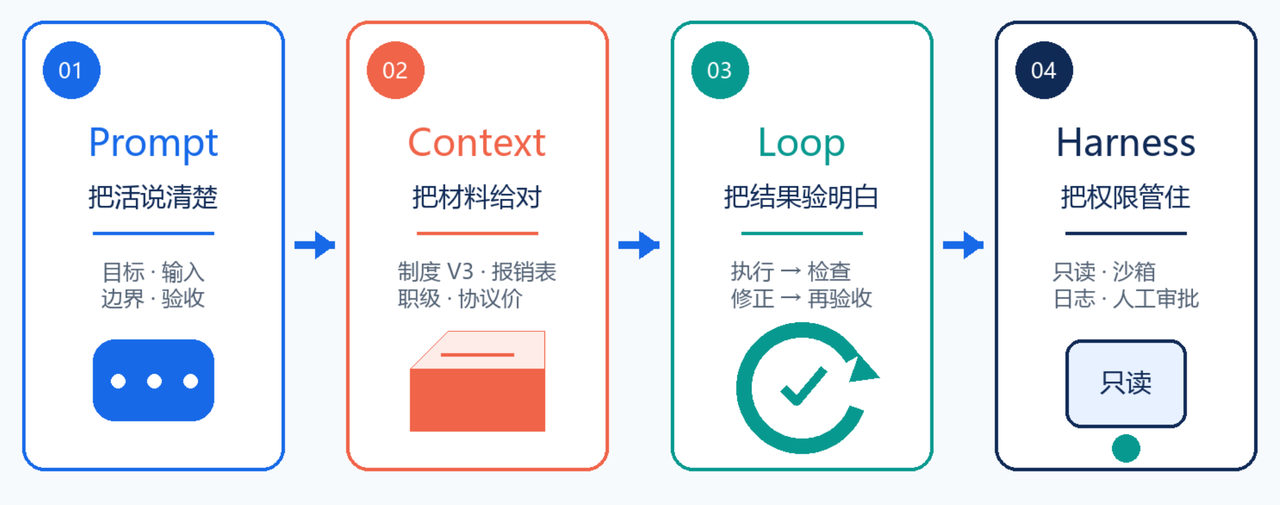
AI Agent 就像一位刚入职的数字同事:脑子快、知识广、手速惊人,但不认识公司的文件夹,不知道谁能审批,也不知道“尽快”是十分钟还是下周三。要让它真正干活,至少需要配齐四套工程:
•
Prompt(任务单):这次要做什么
•
Context(资料包):开工前看哪些资料、凭什么做判断
•
Loop(工作闭环):做错后怎么检查、返工、再验收
•
Harness(办公制度):能用什么工具、有什么权限、在哪里操作、出事怎么兜住
一句话人话版:Prompt 决定“这次要做什么”,Context 决定“凭什么做判断”,Loop 决定“怎么一路做到合格”,Harness 决定“在哪儿做、能做什么、出了事怎么兜住”。
💡
贯穿全文的案例任务:“整理本月差旅报销,找出不合规单据,生成汇总表,并通知相关同事补材料。” 四套工程将逐一登场。
一、Prompt:不是“咒语”,是写清楚任务单
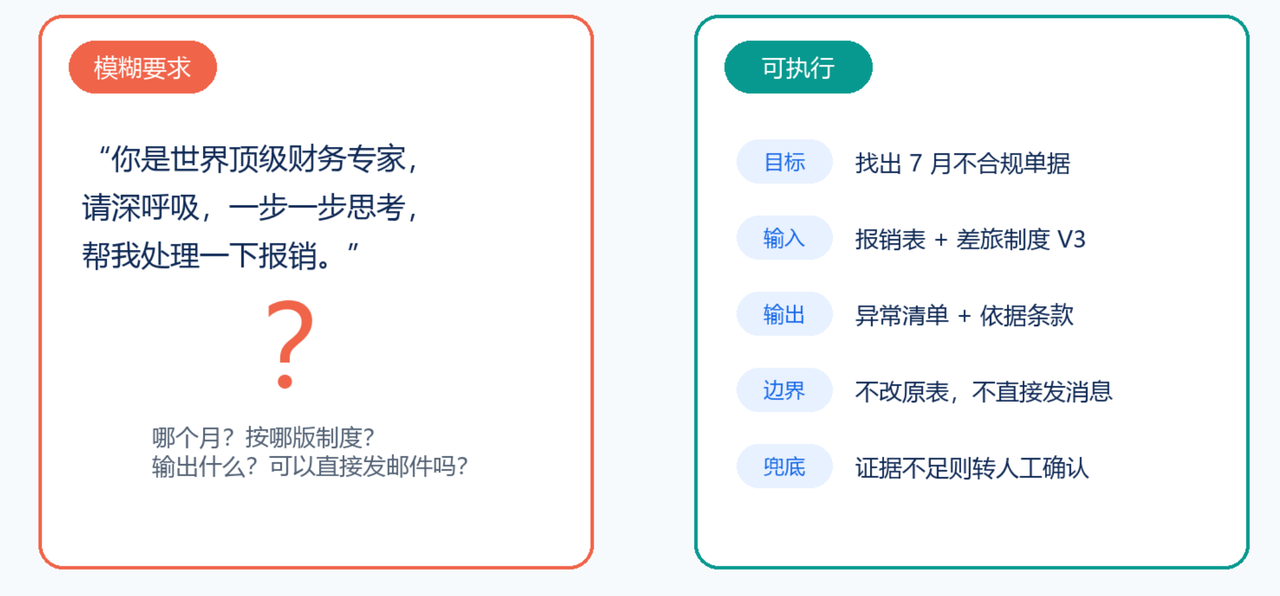
很多人把 Prompt 当成赛博咒语:句子越长、语气越神秘,模型就越听话。于是任务写成:“你是一位拥有 20 年经验、世界顶级的财务专家,请深呼吸,一步一步思考,帮我处理报销。”模型读完,工作范围依然一片模糊——不知道处理哪个月、依据哪版制度、输出什么格式、什么算异常、能不能直接通知员工。
好 Prompt 的五块积木
目标:最终要交付什么
输入:使用哪些数据或材料
边界:哪些事不要做,哪些决定必须交给人
标准:怎样算完成、怎样算合格
格式:结果用表格、JSON、邮件草稿还是自然语言
示例
检查 2026 年 7 月差旅报销表。依据提供的《差旅制度 V3》标记超标、缺票和重复报销。输出一张异常清单,包含员工、单号、异常类型、依据条款和建议动作。不要修改原始数据,不要直接发送消息;证据不足时标记“待人工确认”,不得猜测。
最佳实践
•
先写验收标准,再润色语气:“输出看起来专业”无法验收,“每条异常必须附规则编号”可以
•
把事实与指令分开:制度原文放资料区,任务要求放指令区,避免模型把资料里的句子误当命令
•
结构化输出配 Schema:需要系统继续处理时,优先用 JSON Schema、Pydantic、Zod 等约束字段
•
给边界案例,不只给标准答案:明确“信息不足”“规则冲突”“工具失败”时的做法
•
把 Prompt 当代码管理:版本化、做回归样例、记录模型与参数,不要靠“祖传神句”
常用工具
•
日常试写:ChatGPT、Claude、Gemini、Microsoft Copilot 的交互界面或 Playground
•
模板与结构化输出:Microsoft Agent Framework、LangChain、Semantic Kernel、PydanticAI
•
测试与评估:Promptfoo、LangSmith、Braintrust、Microsoft Foundry 评估能力
•
版本管理:Git 加普通文本文件就够用;团队规模变大后再引入 Prompt Registry
要点:Prompt 负责把任务讲清楚,但不负责凭空知道你公司的情况。任务单写得再好,没给差旅制度和报销数据,Agent 也只能表演“无实物财务审核”。
二、Context:不是把仓库倒给 AI,是准备随用随取的资料包
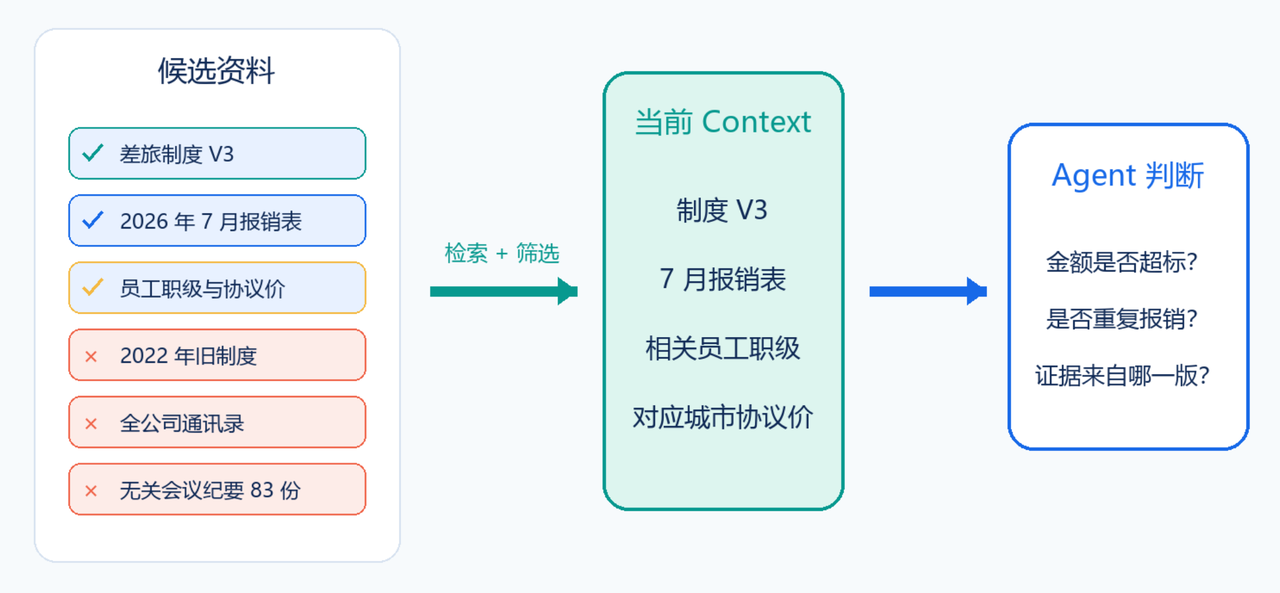
“资料多”不等于“上下文好”。会议上一次性甩给你 186 个文件,再补一句“相关背景都在里面”,这不叫充分交接,叫电子雪崩。Context Engineering 的核心不是喂得多,而是在正确的时刻给正确的信息。
上下文的四种来源
•
静态规则:团队规范、产品说明、制度文档、代码约定
•
动态检索:从知识库、数据库、搜索引擎或项目文件中按需找到的信息
•
工具结果:SQL 查询、API 响应、测试报告、网页内容、日志片段
•
过程记忆:当前任务做到哪一步、做过哪些决定、哪些尝试已经失败
Context ≠ RAG:RAG 只是获取上下文的一种办法;文件读取、数据库查询、MCP 工具返回、会话摘要、状态存储,也都在做上下文工程。
最佳实践
•
先检索,再精选,最后注入:不要默认把整个知识库塞进上下文窗口
•
给每份资料标来源、版本和时间:“制度规定”不够,要知道是哪一版、何时生效
•
区分事实、推断和历史结论:Agent 上一轮说过的话,不会自动变成事实
•
控制新鲜度和权限:过期价格、离职员工信息、无权查看的薪资数据都不该混进来
•
长任务要压缩,不要失忆:保留目标、约束、关键证据和未决问题,淘汰重复对话与无效工具输出
•
防范提示注入:外部网页或文档里的“忽略之前要求”只是数据,不该获得系统指令的权力
常用工具
•
统一接工具和数据:MCP(Model Context Protocol)服务器与客户端生态
•
知识检索:Azure AI Search、Elasticsearch、OpenSearch,以及 PostgreSQL + pgvector 等组合
•
编排与状态:Microsoft Agent Framework、LangGraph、LlamaIndex、Semantic Kernel
•
记忆层:框架自带 checkpoint、数据库状态表,或 Mem0 这类专用方案
•
可观测性:LangSmith、Arize Phoenix、OpenTelemetry,查看到底检索了什么、塞进了什么
🔍
简单判断:如果 Agent 的回答像“聪明人不了解情况”,先查 Context,别急着换模型。
三、Loop:给任务装上“检查—修正—再验收”
不少 Agent 工作流到第一轮输出就停了:模型输出了一次,系统便宣布任务结束。这叫调用,不叫闭环。Loop Engineering 关心的是:让 Agent 根据结果和反馈持续推进,直到满足验收条件,或者触发停止与人工接管。
最小闭环
读取任务 → 制订计划 → 执行一步
调用工具验证 → 根据结果修正 → 记录状态
判断:继续推进、完成,或交给人
报销案例中的 Loop
读取一批单据并生成异常候选
用规则引擎复核金额与日期
检查每条异常是否有原始凭证和制度条款
证据缺失则回到数据查询;规则冲突则转人工
验证通过后生成汇总表和通知草稿
达到最大重试次数、预算上限或高风险条件时停止
关键:Loop 的高级不在于循环次数多,而在于每一轮都有新证据。同一句 Prompt 连续问十遍,期待第十一次突然顿悟,那不是工程,是电子版“再想想”。
最佳实践
•
先定义状态,再画流程:至少知道当前步骤、已完成项、待处理项、失败次数和关键产物
•
每轮必须有可观察的进展:新工具结果、新测试结果或状态变化,否则立即停下
•
验证器尽量独立:写答案的模型不要单靠一句“我检查过了”给自己盖章,用测试、规则或另一个评估步骤复核
•
写清停止条件:成功条件、最大步数、时间、Token、费用、重复失败阈值都要明确
•
副作用操作要幂等:重试发送邮件、扣款、建工单时,不能一失败就重复执行十次
•
关键节点让人接管:付款、删除、发布、权限变更等高风险动作,默认需要确认
常用工具
•
有状态工作流:LangGraph、Microsoft Agent Framework、Semantic Kernel Process Framework
•
耐久任务编排:Temporal、Azure Durable Functions,适合跨分钟、小时甚至更久的任务
•
代码 Agent 的现成闭环:GitHub Copilot coding agent、Claude Code、OpenAI Codex 等
•
评估与回归:Microsoft Foundry、LangSmith、Braintrust、Promptfoo,以及项目原本的单元测试和集成测试
在代码场景中,一个诚实的 pytest,往往比五段华丽的自我反思更值钱。
四、Harness:Agent 的办公室、门禁和行车记录仪
Harness 原意接近“挽具、控制装置”。在 Agent 工程里,它指包在模型外面的运行系统:模型与工具怎样连接、代码在哪里执行、身份密钥和权限怎样管理、哪些操作允许自动完成、日志轨迹和成本怎样记录、失败怎样隔离重试恢复、人类怎样审批暂停和接管。
如果模型是脑子、Prompt 是任务单、Context 是桌面资料、Loop 是工作方法,那么 Harness 就是办公室、门禁卡、电脑权限、审批制度、监控告警和消防通道的总和。
Loop 和 Harness 到底差在哪
•
Loop 决定流程:先生成通知 → 检查收件人和缺失项 → 不合格就重写 → 合格后提交审批
•
Harness 提供条件:Agent 只能创建草稿,不能直接发送;邮箱凭据放在密钥系统;每次调用有审计日志;超过 50 人必须人工批准
一句话:Loop 是事情怎么往前走,Harness 是这件事被允许怎样走。
最佳实践
•
最小权限起步:能只读就不给写入,能改单个目录就不开放整台机器
•
把模型输出当不可信输入:命令、SQL、URL、文件路径都要校验,不因它“是 AI 生成的”就免检
•
执行环境隔离:代码放进容器、沙箱或临时环境,限制网络、CPU、内存和运行时间
•
凭据永不进入 Prompt:使用托管身份、Key Vault 或短期令牌,在工具侧完成鉴权
•
全链路可追踪:保存任务 ID、模型版本、工具调用、输入输出摘要、耗时、费用和审批记录
•
危险动作分级:查询可以自动,写入需要策略,转账、删除、发布必须人工确认
•
准备失败路径:超时、限流、服务不可用、重复调用、模型跑偏,都要有明确处理方式
常用工具
•
运行与工具治理:Microsoft Agent Framework、Semantic Kernel、MCP 网关和企业 API 网关
•
沙箱与隔离:Docker、Kubernetes、E2B,以及云端临时执行环境
•
身份与密钥:Microsoft Entra ID、Azure Managed Identity、Azure Key Vault
•
可观测性:OpenTelemetry、Azure Monitor、Application Insights、Langfuse、Arize Phoenix
•
策略与人工审批:云 IAM、Open Policy Agent,以及工作流系统中的 approval gate
Harness 不一定是一款产品,它通常是运行时、沙箱、权限、策略、观测和审批机制的组合。只买一个 Agent 框架,就像只买一张办公桌,然后宣布公司治理体系建设完毕。
五、四层协同:不是版本升级,是四个同时工作的齿轮
这四者不是“初级、中级、高级、尊享版”,而是不同的责任层,同时工作、缺一不可。
| | |
| | |
| | |
| | |
最实用的排错方法:按四层问一遍
任务有没有说清?(Prompt)
证据有没有给对?(Context)
结果有没有验证和返工机制?(Loop)
工具、权限、日志和停止开关有没有配好?(Harness)
很多所谓“模型智商问题”,查到最后,其实是制度问题。
六、落地起步:别先造贾维斯,先闭环一个小任务
第一次做 Agent,不建议从“全自动经营公司”起步,权限先别太大。挑一个同时满足以下条件的小任务:
•
每周重复发生
•
输入和输出相对明确
•
有现成规则或样例
•
结果容易验证
•
做错了不会立刻造成重大损失
典型例子:整理会议纪要、检查合同字段、归类客服工单、生成测试用例、汇总日报、修复小型代码问题。
一页纸 Agent 上线清单
| |
| |
| |
| |
四栏都能回答,再谈自动化率;答不上来的地方,就是下一个工程任务。
写在最后
AI Agent 不神秘。它只是把“大模型会回答”升级成“大模型能在约束下完成任务”。Prompt 让它听懂人话,Context 让它了解情况,Loop 让它干到合格,Harness 让它别把公司一起干掉。
下次再听见某个新名词,不必立刻冲进焦虑型学习。先问它到底在解决哪一层问题:任务说明、信息供给、执行闭环,还是运行治理?能把这四件事分清,你就已经越过了“会聊天”的阶段,开始真正设计一个可交付、可验证、可接管的 AI Agent。