构建游戏运营自动化 Agent
一、什么是游戏运营自动化Agent?
在讲解决思路之前,我们先明确一下"什么是游戏运营自动化Agent"——因为现在"Agent"这个词太火了,很多人都在说,但每个人的理解可能都不一样。
我查阅了AI领域的经典文献(比如Russell & Norvig的《人工智能:一种现代的方法》第4版),结合游戏运营的实际场景,给游戏运营自动化Agent下了一个定义:
📌
游戏运营自动化 Agent 定义
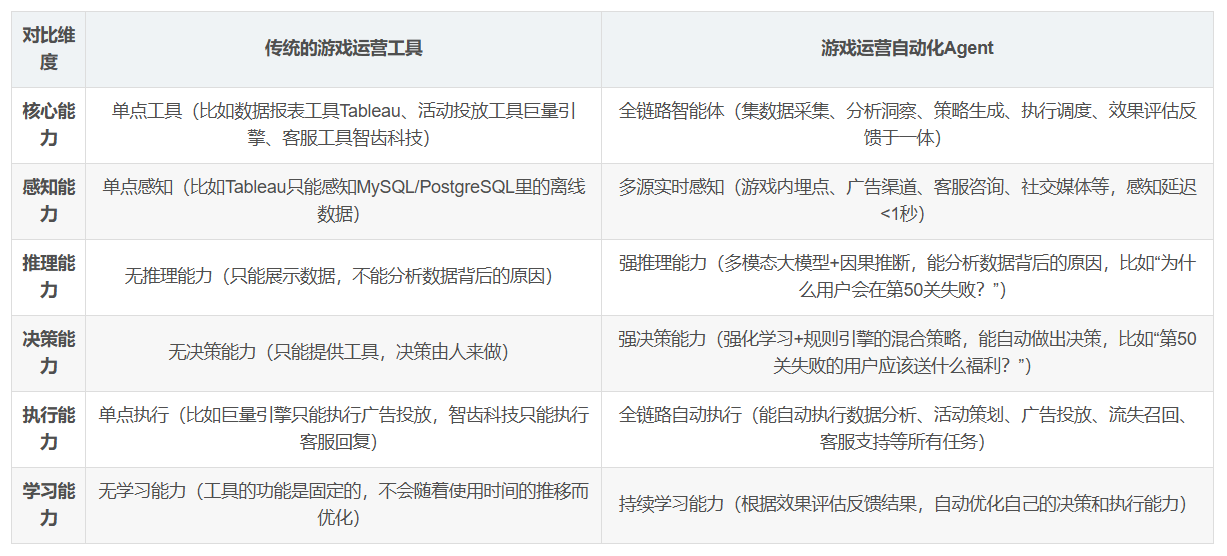
游戏运营自动化Agent是一个具有感知能力、推理能力、决策能力、执行能力、学习能力的智能体,它可以实时感知游戏内埋点数据、广告渠道数据、客服咨询数据、社交媒体数据等多源数据,基于多模态大模型、强化学习、时序分析、因果推断等技术进行推理和决策,自动执行数据分析、活动策划、广告投放、流失召回、客服支持等游戏运营任务,根据效果评估反馈结果持续学习和优化自己的决策和执行能力,最终实现"全链路AI驱动的游戏运营增长"。
为了让你更直观地理解这个定义,我把游戏运营自动化Agent和"传统的游戏运营工具"做了一个对比:
1.1 核心解决思路:全链路闭环的Agent协同系统
了解了传统游戏运营的"三座大山"和游戏运营自动化Agent的定义之后,我们来聊聊核心解决思路——我认为,解决传统游戏运营问题的核心思路是:构建一个全链路闭环的Agent协同系统,由多个专门化的Agent共同协作完成游戏运营的所有任务。
为什么要用"多个专门化的Agent协同"而不是"一个通用的Agent"?原因有两个:
•
游戏运营的任务复杂度太高:游戏运营涉及到数据分析、活动策划、广告投放、流失召回、客服支持等多个不同的领域,每个领域都需要专门的知识和技能——一个通用的大模型(比如GPT-4o)虽然可以处理很多不同的任务,但它在处理某个专门领域的任务时,效果往往不如一个"经过专门领域数据微调的大模型+专门领域的算法(比如强化学习、时序分析)"的组合;
•
系统的可扩展性和可维护性更好:如果用"一个通用的Agent",当我们需要添加一个新的游戏运营任务(比如"自主创新玩法生成")时,我们需要修改整个Agent的代码——这会导致系统的可扩展性和可维护性很差;但如果用"多个专门化的Agent协同",当我们需要添加一个新的游戏运营任务时,我们只需要添加一个新的专门化Agent,并修改一下Agent之间的交互规则即可——这会大大提高系统的可扩展性和可维护性。
我设计的GameOps-Genie全链路闭环Agent协同系统一共包括5个专门化的Agent:
•
数据采集Agent(Data Collection Agent):负责实时采集游戏内埋点数据、广告渠道数据、客服咨询数据、社交媒体数据等多源数据,并进行清洗、ETL转换、标准化处理;
•
分析洞察Agent(Analysis Insight Agent):负责接收数据采集Agent处理后的数据,基于多模态大模型、时序分析、因果推断等技术进行分析和洞察,生成"异常数据报告"、"用户画像报告"、"市场趋势报告"等;
•
策略生成Agent(Strategy Generation Agent):负责接收分析洞察Agent生成的报告,基于强化学习(PPO)+规则引擎(Drools)的混合策略,生成"数据分析策略"、"活动策划策略"、"广告投放策略"、"流失召回策略"、"客服支持策略"等;
•
执行调度Agent(Execution Scheduling Agent):负责接收策略生成Agent生成的策略,基于Celery Beat+Kubernetes的弹性调度,自动分配给对应的执行工具(比如数据报表工具Tableau、活动投放工具巨量引擎、客服工具智齿科技)执行;
•
效果评估反馈Agent(Effect Evaluation Feedback Agent):负责接收执行调度Agent执行后的数据,基于多维度指标监控、归因分析等技术进行效果评估,并把评估结果反馈给策略生成Agent和分析洞察Agent,让它们持续学习和优化自己的能力。
🔄
全链路闭环
这5个专门化的Agent会形成一个全链路的闭环:数据采集→分析洞察→策略生成→执行调度→效果评估反馈→再数据采集→再分析洞察→……——这个闭环会"24小时不间断运行",永远不会休息,永远不会出错(只要数据质量好、算法设计合理)。
二、GameOps-Genie系统架构设计
2.1 系统整体架构图
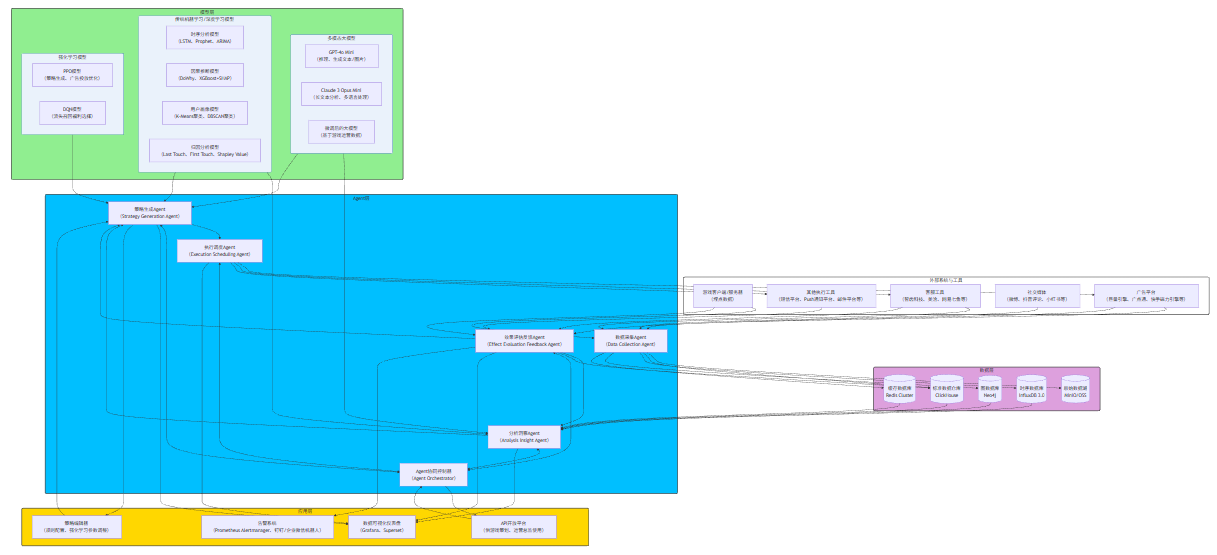
为了让你更直观地理解GameOps-Genie的系统架构,我画了一张Mermaid架构图:
2.2 核心要素组成(数据层、模型层、Agent层、应用层)
从上面的Mermaid架构图可以看出,GameOps-Genie的核心要素组成可以分为4层:数据层、模型层、Agent层、应用层——下面我会逐一详细讲解每一层的功能和工具选型。
2.2.1 数据层
数据层是GameOps-Genie的"基础"——如果没有高质量的数据,后面的分析洞察、策略生成、执行调度、效果评估反馈都是"空中楼阁"。
GameOps-Genie的数据层一共包括5个不同类型的数据库,每个数据库都有自己的"专门用途":
| | | |
| | | |
| | | |
| | | |
| | | |
2.2.2 模型层
模型层是GameOps-Genie的"大脑"——它负责为分析洞察Agent和策略生成Agent提供"智能支持"。
GameOps-Genie的模型层一共包括3个子层:多模态大模型子层、传统机器学习/深度学习模型子层、强化学习模型子层——下面我会逐一详细讲解每一个子层的功能和工具选型:
(1)多模态大模型子层
多模态大模型子层是GameOps-Genie的"核心大脑"——它负责处理文本、图片、音频、视频等多模态数据,进行推理、生成文本/图片等任务。
GameOps-Genie的多模态大模型子层一共包括3个不同的大模型,每个大模型都有自己的"专门用途":
| | |
| | |
| | |
(2)传统机器学习/深度学习模型子层
传统机器学习/深度学习模型子层是GameOps-Genie的"辅助大脑"——它负责处理结构化数据、时间序列数据、图数据等,进行时序分析、因果推断、用户画像、归因分析等任务。
GameOps-Genie的传统机器学习/深度学习模型子层一共包括4个不同的模型,每个模型都有自己的"专门用途":
| | | |
| | | |
| | | |
| | | |
(3)强化学习模型子层
强化学习模型子层是GameOps-Genie的"决策大脑"——它负责通过"试错"的方式,自动优化游戏运营的策略(比如自动优化广告投放的素材、时间、人群,自动优化流失召回的福利内容、发送时间)。
GameOps-Genie的强化学习模型子层一共包括2个不同的模型,每个模型都有自己的"专门用途":
| | | |
| | | |
2.2.3 Agent层
Agent层是GameOps-Genie的"执行主体"——它由多个专门化的Agent和一个Agent协同控制器组成,负责完成游戏运营的所有任务。
前面我已经在"核心解决思路"里介绍过了GameOps-Genie的5个专门化的Agent,下面我会逐一详细讲解每一个Agent的功能,以及Agent协同控制器的功能:
(1)数据采集Agent(Data Collection Agent)
📥
核心功能:实时采集多源数据,并进行清洗、ETL转换、标准化处理。
数据采集Agent的工作流程大概是:
数据采集:通过API接口、Webhook、SDK等方式,实时采集游戏内埋点数据、广告渠道数据、客服咨询数据、社交媒体数据等多源数据;
数据清洗:对采集到的原始数据进行清洗(比如去除重复数据、去除无效数据、填充缺失数据);
ETL转换:对清洗后的数据进行ETL转换(比如把游戏内埋点的JSON格式数据转换成ClickHouse的列式存储格式、把广告渠道的CSV格式数据转换成ClickHouse的列式存储格式);
标准化处理:对ETL转换后的数据进行标准化处理(比如统一日期格式、统一货币格式、统一用户ID格式);
数据存储:把标准化处理后的数据分别存储到原始数据湖、标准数据仓库、时序数据库、图数据库、缓存数据库里。
以下是数据采集Agent中使用 Flink SQL 进行实时埋点数据清洗与ETL的示例代码:
Flink SQL 实时数据清洗与ETL
SQL
-- 实时埋点数据清洗与ETL(Flink SQL)
CREATE TABLE raw_events (
event_time TIMESTAMP(3),
user_id STRING,
event_type STRING,
level INT,
revenue DECIMAL(10,2),
WATERMARK FOR event_time AS event_time - INTERVAL '5' SECOND
) WITH (
'connector' = 'kafka',
'topic' = 'game-events',
'properties.bootstrap.servers' = 'kafka:9092',
数据采集Agent的工具选型是:Apache Flink——Apache Flink是开源的、分布式的流处理引擎,性能非常高(处理速度可以达到每秒百万+条数据)、延迟非常低(处理延迟通常<1秒)、支持批流一体(既可以处理实时流数据,也可以处理离线批数据),非常适合游戏运营这种"数据量大、实时性要求高"的场景。
(2)分析洞察Agent(Analysis Insight Agent)
🔍
核心功能:接收数据采集Agent处理后的数据,基于多模态大模型、时序分析、因果推断等技术进行分析和洞察,生成各种报告。
分析洞察Agent的工作流程大概是:
数据获取:从标准数据仓库、时序数据库、图数据库、缓存数据库里获取需要分析的数据;
实时监控与异常检测:基于时序分析模型(Prophet、LSTM、ARIMA),实时监控时间序列数据,检测异常数据点(比如"突然飙升的流失率"、"突然下降的充值金额");
异常数据原因分析:如果检测到异常数据点,基于多模态大模型(GPT-4o Mini)和因果推断模型(DoWhy、XGBoost+SHAP),分析异常数据背后的原因;
用户画像更新:基于用户画像模型(K-Means聚类、DBSCAN聚类、RFM模型),每天更新一次用户画像;
市场趋势分析:基于多模态大模型(Claude 3 Opus Mini),分析社交媒体数据(比如微博、抖音评论、小红书),了解市场趋势和用户的反馈;
报告生成:生成"异常数据报告"、"用户画像报告"、"市场趋势报告"、"日报/周报/月报"等各种报告。
(3)策略生成Agent(Strategy Generation Agent)
🧠
核心功能:接收分析洞察Agent生成的报告,基于强化学习(PPO、DQN)+规则引擎(Drools)的混合策略,生成各种游戏运营策略。
为什么要用"强化学习+规则引擎的混合策略"而不是"只用强化学习"或者"只用规则引擎"?原因有两个:
•
只用规则引擎的缺点:规则引擎是"基于经验"的,经验难以复制,新人成长周期长,而且规则引擎的灵活性很差,不能处理"规则没有覆盖到的场景";
•
只用强化学习的缺点:强化学习是"基于试错"的,在"冷启动"阶段(也就是没有足够的历史数据的时候),效果很差,而且强化学习的"可解释性"很差,很难知道"为什么强化学习会做出这个决策"——这对于游戏运营来说是一个很大的问题,因为游戏运营的决策往往涉及到"钱"和"用户体验",如果决策出了问题,后果会很严重。
💡
混合策略的设计理念
规则引擎负责处理"常见的、规则明确的场景",保证决策的"可解释性"和"冷启动阶段的效果";强化学习负责处理"规则没有覆盖到的、复杂的场景",保证决策的"灵活性"和"最优性"。
以下是策略生成Agent中使用 Drools 规则引擎编写的流失用户自动召回策略示例:
Drools 规则引擎:流失用户自动召回策略
Java
// Drools 规则引擎:流失用户自动召回策略
rule "高价值流失用户召回"
salience 100
when
$user : User(
lastLoginTime > 30min,
totalRecharge > 1000,
lastFailedLevel == 50
)
then
Strategy.sendRecallPush(
$user.getUserId(),
"亲爱的玩家,您在第50关失败了,送您一张通关券,快来继续挑战吧!",
"level_50_pass_ticket"
);
end
策略生成Agent的工具选型是:Drools(规则引擎) + Stable Baselines3(强化学习框架)——Drools是开源的、最流行的规则引擎之一,非常容易上手,支持Drools Rule Language(DRL)编写规则;Stable Baselines3是OpenAI开源的强化学习框架,基于PyTorch,非常容易上手,内置了PPO、DQN、SAC等多种常用的强化学习模型。
(4)执行调度Agent(Execution Scheduling Agent)
💡
核心功能:接收策略生成Agent生成的策略,基于Celery Beat+Kubernetes的弹性调度,自动分配给对应的执行工具执行。
执行调度Agent的工作流程大概是:
策略接收:接收策略生成Agent生成的策略;
策略分解:把策略分解成多个"可执行的子任务"(比如"把广告素材A投放到抖音的18-25岁女性用户群体,投放时间是今天晚上8-10点,出价是0.5/点击"就是一个策略,执行调度Agent会把它分解成"上传广告素材A到抖音"、"设置投放人群为18-25岁女性用户"、"设置投放时间为今天晚上8-10点"、"设置出价为0.5/点击"、"启动广告投放"这5个可执行的子任务);
任务调度:基于Celery Beat(定时任务调度器)+Kubernetes(容器编排引擎)的弹性调度,把可执行的子任务分配给对应的执行工具(比如巨量引擎、智齿科技、短信平台)执行;
任务监控:实时监控子任务的执行情况,如果子任务执行失败,会自动重试(最多重试3次),如果重试3次还是失败,会通过告警系统(Prometheus Alertmanager、钉钉/企业微信机器人)通知相关人员。
以下是执行调度Agent中 Celery Beat 定时任务调度的配置示例:
Celery Beat 定时任务调度配置
Python
# Celery Beat 定时任务调度配置
from celery.schedules import crontab
CELERY_BEAT_SCHEDULE = {
# 每天早上8点生成日报
'daily-report': {
'task': 'gameops.tasks.generate_daily_report',
'schedule': crontab(hour=8, minute=0),
},
# 每30分钟检查一次流失用户并发送召回
'churn-recall': {
'task': 'gameops.tasks.send_churn_recall',
'schedule': crontab(minute='*/30'),
},
# 每小时调整一次广告投放策略
'ad-optimization': {
'task': 'gameops.tasks.optimize_ad_campaign',
'schedule': crontab(minute=0),
执行调度Agent的工具选型是:Celery Beat + Kubernetes + RabbitMQ(消息队列)——Celery Beat是Celery的定时任务调度器,非常容易上手;Kubernetes是开源的、最流行的容器编排引擎之一,支持弹性伸缩(可以根据任务的数量自动增加/减少容器的数量);RabbitMQ是开源的、最流行的消息队列之一,非常可靠,支持多种消息协议。
(5)效果评估反馈Agent(Effect Evaluation Feedback Agent)
📊
核心功能:接收执行调度Agent执行后的数据,基于多维度指标监控、归因分析等技术进行效果评估,并把评估结果反馈给策略生成Agent和分析洞察Agent,让它们持续学习和优化自己的能力。
效果评估反馈Agent的工作流程大概是:
执行数据获取:从游戏客户端/服务器、广告平台、客服工具、其他执行工具里获取执行后的数据;
多维度指标监控:基于多维度指标(比如留存率、流失率、充值金额、广告CTR、CPC、ROI、客服回复率、客服满意度),评估策略的执行效果;
归因分析:基于归因分析模型(Last Touch、First Touch、Shapley Value、Markov Chain),分析广告投放的效果;
反馈生成:生成"效果评估报告",并把评估结果反馈给策略生成Agent和分析洞察Agent;
持续学习:策略生成Agent会根据评估结果,更新强化学习模型的参数;分析洞察Agent会根据评估结果,优化数据分析和洞察的方法。
以下是效果评估反馈Agent中多维度效果指标监控的 SQL 查询示例:
多维度效果指标监控查询
SQL
-- 多维度效果指标监控查询
SELECT
DATE(exec_time) AS dt,
strategy_type,
channel,
COUNT(DISTINCT user_id) AS target_users,
SUM(CASE WHEN converted THEN 1 ELSE 0 END) AS converted_users,
ROUND(SUM(CASE WHEN converted THEN 1 ELSE 0 END) * 100.0
/ COUNT(DISTINCT user_id), 2) AS conversion_rate,
SUM(revenue) AS total_revenue,
(6)Agent协同控制器(Agent Orchestrator)
🎯
核心功能:协调和管理5个专门化的Agent,保证它们之间的交互是"有序的、高效的、可靠的"。
Agent协同控制器的工作流程大概是:
任务分配:根据当前的游戏运营需求,把任务分配给对应的专门化的Agent;
交互协调:协调5个专门化的Agent之间的交互(比如当分析洞察Agent检测到异常数据点时,Agent协同控制器会立即通知策略生成Agent,让它生成对应的处理策略);
状态监控:实时监控5个专门化的Agent的状态(比如是否正常运行、是否有任务积压、是否有错误);
故障恢复:如果某个专门化的Agent出现故障,Agent协同控制器会立即重启它,并把积压的任务重新分配给它。