从多智能体协作到 AutoGPT 核心复现
前言:为什么要深入 AI Agent 的 “内核”?
一、LangGraph 进阶:构建多 Agent 协作的复杂工作流
🌐
LangChain 解决了 Agent 的 “从 0 到 1”,而 LangGraph 则实现了 “从 1 到 N”—— 它基于状态机设计,让开发者能精确控制 Agent 的每一步决策,尤其适合构建多 Agent 协作系统。
1.1 核心概念:状态(State)与节点(Node)的舞蹈
LangGraph 的本质是 “可控的状态流转”,核心组件包括:
🌐
•
State:全局状态容器,存储所有 Agent 共享的数据(如任务进度、历史记录、工具结果)
•
Node:执行具体逻辑的单元(如 “研究员 Agent 分析问题”“审查员 Agent 检查结果”)
•
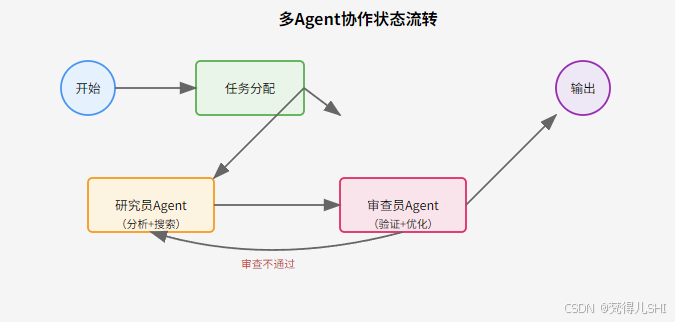
Edge:节点间的连接规则(如 “若结果通过审查则输出,否则返回修改”)
•
Conditional Edge:条件分支,根据状态决定下一个节点(类似 “if-else”)
多 Agent 系统状态流转图
1.2 实战:多 Agent 论文分析系统
场景:让 “研究员” Agent 分析论文摘要并生成解读,“审查员” Agent 检查解读的准确性,若不通过则返回修改。
步骤 1:定义全局状态
代码块
Python
from langgraph.graph import StateGraph, START, END
from pydantic import BaseModel, Field
from typing import List, Optional
# 全局状态:存储任务数据和流程状态
class PaperAnalysisState(BaseModel):
paper_title: str = Field(description="论文标题")
abstract: str = Field(description="论文摘要")
analysis: Optional[str] = Field(None, description="研究员生成的分析")
review: Optional[str] = Field(None, description="审查员的反馈")
is_approved: bool = Field(False, description="分析是否通过审查")
步骤 2:实现节点逻辑(多 Agent 角色)
代码块
Python
from langchain_openai import ChatOpenAI
# 初始化大模型
llm = ChatOpenAI(model_name="gpt-4", temperature=0.3)
# 研究员Agent:分析论文摘要
def researcher_node(state: PaperAnalysisState) -> PaperAnalysisState:
prompt = f"""
请分析以下论文摘要,总结核心贡献和创新点:
标题:{state.paper_title}
摘要:{state.abstract}
"""
state.analysis = llm.predict(prompt)return state
# 审查员Agent:检查分析准确性
def reviewer_node(state: PaperAnalysisState) -> PaperAnalysisState:
prompt = f"""
步骤 3:构建状态机并运行
代码块
Python
1. 初始化工作流
workflow = StateGraph(PaperAnalysisState)
# 2. 添加节点
workflow.add_node("researcher", researcher_node) # 研究员节点
workflow.add_node("reviewer", reviewer_node) # 审查员节点# 3. 定义流转规则
workflow.add_edge(START, "researcher") # 开始→研究员
workflow.add_edge("researcher", "reviewer") # 研究员→审查员# 4. 条件分支:审查通过则结束,否则返回研究员修改
关键优势:相比单 Agent,多 Agent 系统通过分工协作提升结果质量,且状态全程可追溯,便于调试和优化。
二、实战项目:拥有长期记忆的 AI 研究助手
2.1 项目架构:让 Agent 既有 “脑子” 又有 “笔记”
这个研究助手需要具备:
•
短期记忆:记住当前对话上下文
•
长期记忆:通过向量数据库存储知识库(如论文、书籍)
•
联网能力:查询最新研究进展(如 arXiv 新论文)
•
工具调用:自主决定何时检索记忆、何时联网搜索
系统架构图
2.2 分步实现
步骤 1:环境准备
pip install langchain langchain-openai chromadb langchain-community python-dotenv
步骤 2:初始化核心组件
代码块
Python
import os
from dotenv import load_dotenv
from langchain_openai import ChatOpenAI, OpenAIEmbeddings
from langchain.vectorstores import Chroma
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.document_loaders import TextLoader
# 加载环境变量
load_dotenv() # 从.env文件读取OPENAI_API_KEY
# 1. 初始化LLM(核心大脑)
llm = ChatOpenAI(model_name="gpt-3.5-turbo", temperature=0)
# 2. 初始化长期记忆(向量数据库)
embeddings = OpenAIEmbeddings()
persist_directory = "./research_assistant_memory"# 若记忆库不存在则初始化,存在则直接加载if not os.path.exists(persist_directory):
步骤 3:定义工具(记忆检索 + 联网搜索)
代码块
Python
步骤 4:构建带记忆的 Agent
代码块
Python
from langchain.agents import initialize_agent, AgentType
from langchain.memory import ConversationBufferMemory
# 初始化短期记忆(对话历史)
memory = ConversationBufferMemory(memory_key="chat_history",return_messages=True # 以消息列表形式返回
)
# 初始化Agent
research_agent = initialize_agent(
tools,
llm,agent=AgentType.CHAT_CONVERSATIONAL_REACT_DESCRIPTION, # 带对话记忆的React模式memory=memory,verbose=True,handle_parsing_errors=True # 处理解析错误
步骤 5:测试研究助手
代码块
Python
测试1:查询历史知识(应调用MemoryRetrieval)print(research_agent.run("Transformer架构有哪些创新点?"))
# 测试2:查询最新进展(应调用WebSearch)print(research_agent.run("2024年大语言模型领域有哪些重要突破?"))
# 测试3:结合上下文(短期记忆)print(research_agent.run("刚才提到的那个2024年的突破,有论文链接吗?"))
关键技术点:
•
向量数据库通过语义相似度检索实现 “长期记忆”
三、AutoGPT / AgentGPT 深度解析与复现
AutoGPT 作为 “AI 自主代理” 的代表,其核心魅力在于无需人工干预,能自主分解目标、执行计划、反思优化。但它的实现逻辑并不神秘,我们可以拆解为 “目标循环 + 自我批判” 两大模块。
3.1 核心架构:AutoGPT 的 “思考 - 行动” 循环
AutoGPT 的工作流程可简化为:
目标输入:用户设定初始目标(如 “制定 Python 三天学习计划”)
计划分解:将大目标拆分为可执行的子任务
行动执行:调用工具(搜索、文件操作等)完成子任务
结果反思:评估当前结果是否接近目标,生成下一步计划
循环迭代:重复 “行动 - 反思”,直到目标完成或达到限制条件
AutoGPT 核心循环图
3.2 关键技能:控制 Agent 循环的 “安全闸”
AutoGPT 最容易出现的问题是无限循环(如反复搜索相同内容)和成本失控(API 调用量激增)。解决办法是设置多重限制:
最大迭代次数:强制终止循环(如最多执行 10 步)
成本上限:监控 token 消耗,超过阈值则停止
超时机制:单个任务执行超时后终止
自我检测:让 Agent 定期判断 “是否在做无用功”
代码块
Python
循环控制示例代码class AgentLoopController:def init(self, max_iterations=10, max_cost=0.1):
self.max_iterations = max_iterations # 最大迭代次数
self.max_cost = max_cost # 最大成本(美元)
self.iteration_count = 0
self.total_cost = 0.0 # 累计成本def can_continue(self, current_step_cost=0.0) -> bool:"""判断是否可以继续循环"""
self.iteration_count += 1
self.total_cost += current_step_cost
# 检查是否超过最大次数if self.iteration_count >= self.max_iterations:print(f"已达到最大迭代次数({self.max_iterations}),终止循环")return False# 检查是否超过成本上限if self.total_cost >= self.max_cost:print(f"已超过成本上限(${self.max_cost}),当前花费:${self.total_cost:.4f}")return Falsereturn True
3.3 实战:简化版 AutoGPT 复现(制定 Python 三天学习计划)
我们来复现 AutoGPT 的核心逻辑,实现一个能自主制定学习计划的 Agent。
步骤 1:定义循环核心组件
代码块
Python
from langchain_openai import ChatOpenAI
from langchain.prompts import ChatPromptTemplate
# 初始化LLM
llm = ChatOpenAI(model_name="gpt-3.5-turbo", temperature=0.7)
# 1. 计划分解提示词
plan_prompt = ChatPromptTemplate.from_template("""
你需要帮用户制定一个"{goal}"的计划。
当前进度:{progress}
已完成步骤:{history}
请分解出下一步具体要做的任务(用一句话描述),并说明需要调用什么工具(搜索/思考)。
输出格式:
任务:[具体任务]
工具:[搜索/思考]
""")
步骤 2:实现 AutoGPT 循环逻辑
代码块
Python
def simplified_autogpt(goal: str):# 初始化循环控制器(最多8步,成本上限$0.05)
输出示例(简化版):
[思考] 正在处理:确定三天学习的核心模块,包括基础语法、简单项目
[搜索] 正在查询:Python零基础三天学习大纲
[思考] 正在处理:根据搜索结果细化每天的学习内容和时间分配
最终计划:
第一天:Python环境搭建(1小时)、变量与数据类型(2小时)、条件语句(1小时)
第二天:循环结构(2小时)、函数定义(2小时)、列表与字典(1小时)
第三天:文件操作(1小时)、简易爬虫实战(3小时)、总结与答疑(1小时)
核心逻辑提炼:通过 “计划 - 行动 - 反思”