2026年必须要掌握的20个AI概念
🏆
当下人工智能应用已十分普及,但多数使用者并未真正掌握其底层运行原理。大家常会随口提及Transformer、检索增强生成(RAG)、智能体、基于人类反馈的强化学习(RLHF)等专业术语,却未必理解其内涵。
第一部分:人工智能的实际运作方式
神经网络
💪
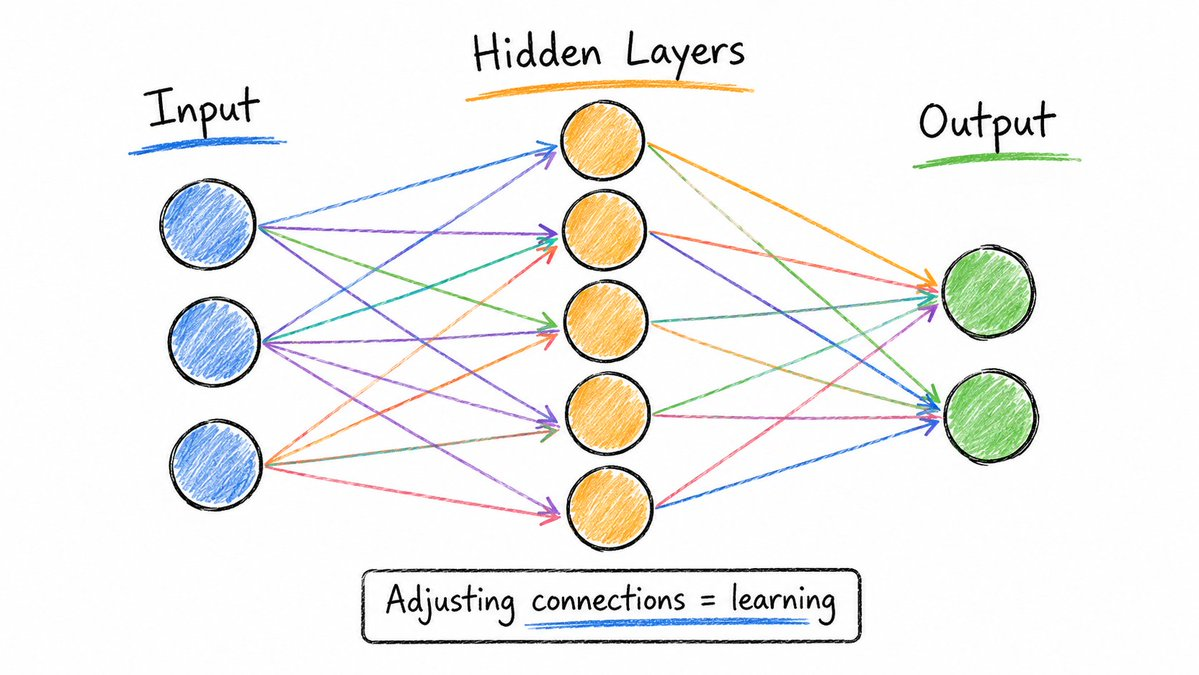
神经网络是一种模拟生物神经元结构与信号传递机制的机器学习计算模型,由大量可学习参数的神经元节点按层级结构互联组成,是深度学习的基础模型。
网络整体分为输入层、若干隐藏层、输出层:
输入层:接收原始数据(文本、图像、数值、特征向量),完成数据接入与前向传递。
隐藏层:通过线性变换与非线性激活函数,逐层自动提取、抽象、融合数据特征,将低级特征转化为高级语义特征。层数越多,模型抽象能力越强。
输出层:将高层特征映射为任务目标结果,用于分类、回归、生成、预测等任务。
神经网络通过前向传播计算预测值,再通过反向传播算法根据误差梯度迭代更新权重与偏置参数,不断缩小预测误差,从而自动学习数据的潜在分布与规律,无需人工设计特征,具备极强的自适应拟合与泛化能力。
Tokenization(分词)
💪
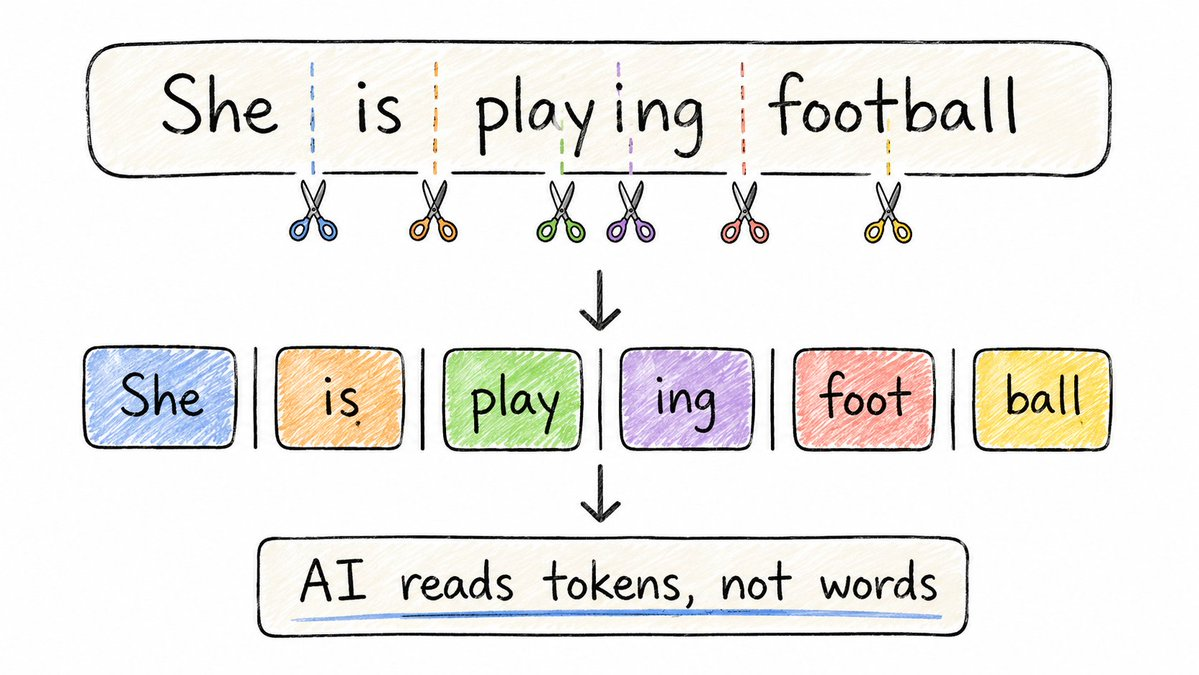
Tokenization是大模型文本处理的核心预处理技术,指将连续完整的自然语言文本,按照模型内置词典规则拆分、编码为最小可计算单元的过程,是连接人类语言与模型数值计算的核心桥梁。
整体处理流程分为文本拆分、ID映射、序列输出三个环节:
文本拆分:针对中英文、标点、符号等文本内容,拆分出子词、单词、字符等最小语义单元Token。
ID映射:依据模型词汇表,将每一个独立Token精准对应唯一的数字ID,完成文本的数值化转换。
Tokenization摒弃了传统全词拆分的局限性,可适配未登录词、异形词等复杂文本场景,有效控制模型词汇表规模,降低计算开销,是大模型文本理解、语义编码的前置基础,直接决定模型的文本解析效率与适配能力。
Embeddings(嵌入)
💪
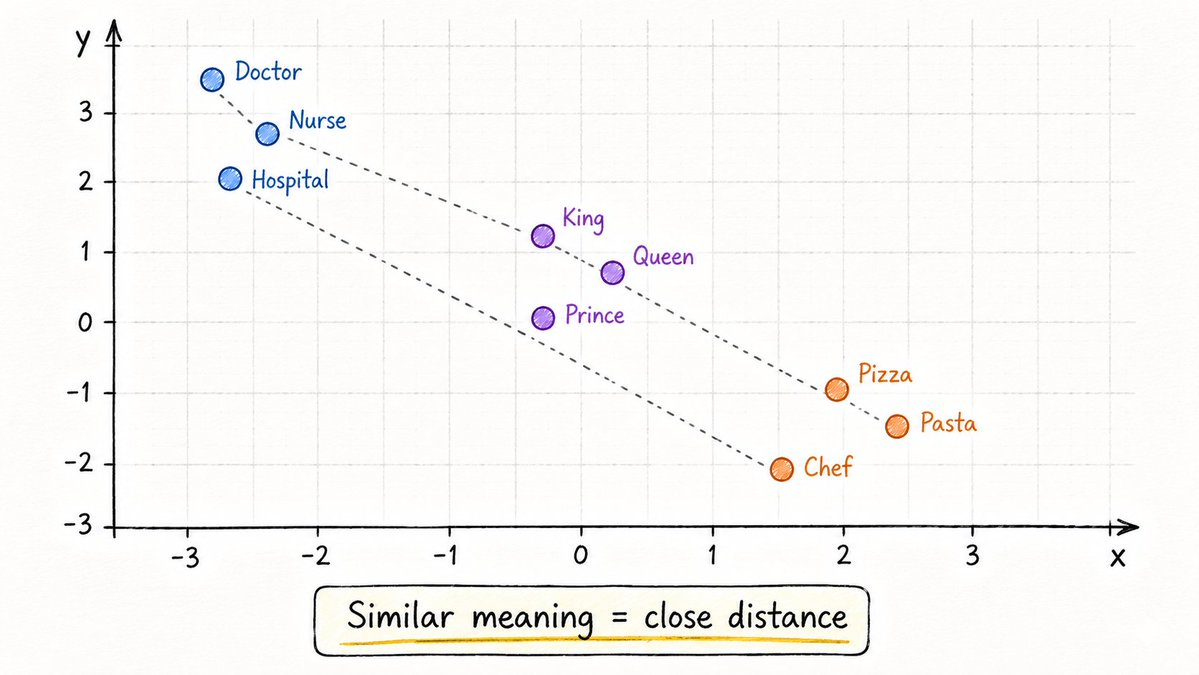
Embeddings是一种核心语义表征技术,指将文本、图像、知识片段等非结构化离散信息,转化为低维、稠密、连续的数值向量,是AI实现语义理解与匹配的核心载体。
整体实现逻辑分为特征提取、向量映射、空间归一化三个环节:
特征提取:依托预训练模型,挖掘文本、图像等数据的核心语义、语法、视觉特征,剔除无效冗余信息。
向量映射:将提取的抽象特征,转化为固定维度的浮点型数值向量,实现非结构化数据的结构化转化。
空间归一化:统一向量空间尺度,让语义、内容相似的数据,在向量空间中呈现更近的距离关系。
Embeddings通过语义与向量空间的绑定关系,将不可计算的语义关联转化为可量化的数学关系,无需人工标注特征,可高效支撑语义检索、知识匹配、文本分类、相似度比对等任务,是RAG、向量检索等技术的底层核心。
Attention(注意力)
💪
注意力机制是Transformer架构的核心算法,模拟人类视觉与语言认知的聚焦特性,能够让模型自主权衡输入信息的重要程度,是大模型实现长文本语义关联的关键技术。
整体运算逻辑分为权重计算、权重分配、特征聚合三个环节:
权重计算:通过Query、Key向量运算,计算输入序列中每个元素与当前任务的关联匹配度,生成初始注意力权重。
权重分配:通过Softmax函数归一化权重,强化关键信息权重、弱化无关、冗余信息权重。
特征聚合:依据最终权重对Value向量加权求和,筛选并融合核心有效特征,输出优化后的特征序列。
注意力机制彻底解决了传统循环模型长距离依赖捕捉薄弱的问题,可并行处理序列数据,精准关联上下文语义,大幅提升模型对复杂文本、长序列数据的理解与生成能力,是现代大模型的核心基石。
Transformer(变压器)
💪
Transformer是基于自注意力机制构建的深度学习基础架构,摒弃了传统循环网络的串行计算模式,凭借高效的并行计算与长序列建模能力,是当前所有大语言模型、多模态生成模型的底层核心框架。
整体结构分为编码器、解码器、前馈网络三大核心模块:
编码器:依托自注意力机制,对输入文本、图像等序列数据进行全局语义编码,挖掘上下文双向关联特征,多用于理解类任务。
解码器:结合掩码自注意力与编码信息,逐词生成序列内容,规避未来信息泄露,多用于文本、图像等生成类任务。
前馈网络:对注意力输出的特征进行非线性变换,进一步抽象、融合特征,提升模型的拟合与泛化能力。
Transformer具备并行训练效率高、长距离语义捕捉能力强、泛化性优异的特点,打破了传统模型的性能瓶颈,支撑了千亿、万亿级大模型的训练落地,是生成式AI技术的核心基座。
第二部分:大语言模型的工作原理
LLM(大语言模型)
💪
大语言模型是基于Transformer架构,依托海量通用文本语料预训练而成的大规模生成式人工智能模型,具备通用自然语言理解与生成能力,是生成式AI的核心应用载体。
整体能力体系分为语义理解、逻辑推理、内容生成三个核心维度:
语义理解:通过海量语料学习人类语言语法、语义、语境规则,精准识别用户指令、文本含义、隐含意图。
逻辑推理:依托预训练习得的知识与逻辑体系,完成常识推理、数理运算、因果推演、复杂问题拆解。
内容生成:基于上下文语义与概率分布,自主生成连贯、通顺、符合逻辑的文本内容,适配多类语言任务。
大语言模型通过海量数据学习人类通用知识与语言逻辑,无需针对单任务单独建模,可自适应对话、创作、翻译、问答、代码生成等多元场景,具备极强的通用人工智能能力
Context Window(上下文窗口)
💪
上下文窗口是大模型单次推理计算可识别、记忆、关联的文本总长度上限,是衡量大模型长文本处理能力的核心指标,直接决定模型的上下文联动与记忆范围。
整体作用范围分为有效窗口、临界窗口、无效区域三个层级:
有效窗口:窗口阈值内的所有文本内容,可被模型完整编码、记忆,实现语义关联、逻辑联动与上下文问答。
临界窗口:接近窗口上限的文本内容,可能出现特征稀释、语义遗忘、关联精度下降等问题。
无效区域:超出窗口阈值的文本内容,无法被模型读取与计算,完全脱离本次推理的上下文体系。
上下文窗口限定了模型单次交互的信息承载上限,窗口越大,模型可处理的长文档、多轮对话、长逻辑推理场景越丰富,是大模型落地长文本知识库、长文案创作等场景的核心约束条件。
Temperature(温度)
💪
温度是大模型文本生成阶段的核心超参数,用于调节词汇采样的概率分布,精准控制模型输出内容的随机性、确定性与创造性。
整体参数调控分为低温度、中温度、高温度三种区间:
低温度(0-0.3):模型优先选择高概率合规词汇,输出内容严谨、规整、重复度低,逻辑确定性极强,适配问答、科普、公文场景。
中温度(0.3-0.7):平衡随机性与确定性,输出内容通顺自然、适度灵活,适配日常对话、通用创作等常规场景。
高温度(0.7-1.0):扩大低概率词汇采样范围,输出内容发散性、创造性更强,适配文案创作、诗歌编写、创意构思场景。
温度参数仅作用于模型推理生成阶段,不修改模型底层参数,可根据业务场景灵活调试,是优化大模型输出风格、适配场景需求的核心轻量化调控手段。
Hallucination(幻觉)
💪
幻觉是生成式大模型的固有现象,指模型基于概率拟合生成的文本内容逻辑通顺、格式规范,但与客观事实、真实知识、给定上下文完全不符的虚假生成问题。
整体表现形式分为事实错误、内容虚构、逻辑偏差三类:
事实错误:混淆人物、时间、数据、专业知识等既定客观事实,输出错误结论。
内容虚构:凭空编造不存在的文献、案例、数据、事件、专业理论等虚假内容。
逻辑偏差:上下文逻辑矛盾、因果倒置、推理断层,出现不符合常规认知的推导结果。
幻觉产生的核心原因是模型仅基于文本概率分布生成内容,无法精准区分知识真伪,存在知识滞后、知识遗忘、上下文特征稀释等问题,可通过RAG检索、模型微调、提示词约束等方式有效缓解。
Prompt Engineering(提示词工程)
💪
提示词工程是一套不修改模型参数,通过人工设计、优化、规范输入指令,引导大模型精准匹配任务需求的工程化优化方法,是大模型落地应用的低成本核心手段。
整体设计维度分为指令定义、格式约束、逻辑引导、场景限定四个部分:
指令定义:清晰明确任务目标、用户需求、核心输出要求,消除意图模糊性。
格式约束:指定输出文本的结构、排版、长度、语气、专业格式等标准化要求。
逻辑引导:通过范例、分步要求、推理提示,引导模型规范思考与推导过程。
场景限定:明确使用场景、受众、专业标准,约束模型输出边界,规避无效内容。
提示词工程依托精准的输入范式挖掘模型原生能力,低成本提升模型输出精度、规范性与适配性,广泛应用于各类大模型落地场景,是大模型应用开发的基础技能。
第三部分:人工智能模型如何进化
Transfer Learning(迁移学习)
💪
迁移学习是一种高效的AI模型训练范式,核心是将模型在大规模通用数据预训练阶段习得的基础特征与通用能力,迁移复用至细分垂直任务,避免从零初始化训练模型。
整体学习流程分为预训练习得、特征迁移、任务适配三个阶段:
预训练习得:模型在海量通用数据中学习语言、视觉、逻辑等基础通用特征与认知能力。
特征迁移:保留模型底层通用参数与特征提取能力,将基础能力迁移至新的细分任务。
任务适配:基于少量垂直数据,微调模型上层参数,适配专属场景的任务需求。
迁移学习大幅降低了模型训练的数据依赖、算力成本与训练周期,解决了小样本场景下模型拟合效果差、泛化能力弱的问题,是当前大模型预训练、微调落地的核心训练范式。
Fine-tuning(微调)
💪
微调是基于成熟预训练基座模型,使用垂直领域专属数据集,针对性优化模型参数的轻量化训练方式,核心目的是让通用模型适配细分业务与专业场景。
整体训练逻辑分为基座加载、参数迭代、偏好对齐三个环节:
基座加载:复用具备通用能力的预训练大模型,保留模型底层通用知识与特征能力。
参数迭代:使用高质量垂直数据集,小幅迭代更新模型权重参数,学习领域专属知识与输出偏好。
偏好对齐:矫正模型输出风格、回答逻辑、知识精度,适配行业规范与业务需求。
微调区别于从零预训练,无需海量数据与超大算力,仅针对特定场景优化模型能力,可有效解决通用模型专业知识不足、输出不贴合业务、风格不统一等问题,是模型定制化落地的核心方式。
RLHF(基于人类反馈的强化学习)
💪
RLHF是大模型价值观对齐的核心技术,依托人类主观反馈信号,通过强化学习优化模型生成策略,让模型输出贴合人类认知、偏好与安全规范。
整体优化流程分为人工打分、奖励模型训练、强化学习迭代三个阶段:
人工打分:由标注人员对模型多条输出结果进行优劣排序、评分,标注人类偏好信号。
奖励模型训练:基于人工标注数据,训练专属奖励模型,让模型自主判别输出内容的优劣等级。
强化学习迭代:以奖励模型输出为监督信号,迭代优化大模型参数,最大化奖励值,对齐人类偏好。
RLHF可有效优化模型输出的有用性、真实性、无害性,解决通用模型回答冗余、价值观偏差、安全风险等问题,大幅提升大模型的人机交互体验与落地安全性。
LoRA(低秩适应)
💪
LoRA是一种轻量化、低成本的大模型高效微调技术,核心原理为冻结基座模型全部原始参数,仅通过新增少量低秩矩阵实现模型场景适配,是小算力场景模型定制的主流方案。
整体运行逻辑分为参数冻结、低秩训练、权重合并三个环节:
参数冻结:完全锁定预训练基座模型的所有原始权重,保留模型全部通用能力,杜绝灾难性遗忘。
LoRA仅需原模型千分之一级别的参数量与显存资源,单卡即可完成大模型微调,兼顾训练成本与模型效果,完美适配个人、中小企业的轻量化模型定制需求。
Quantization(量化)
💪
量化是大模型部署阶段的核心优化技术,通过降低模型权重参数的数值精度,在可控精度损耗的前提下,实现模型体积压缩、推理加速与资源降本。
整体量化层级分为高精度、中精度、低精度三个档位:
高精度量化(FP16):保留模型原始精度,几乎无效果损耗,仅小幅压缩模型体积,适配高端算力设备。
中精度量化(INT8):适度降低参数精度,平衡模型效果与推理速度,适配绝大多数服务器部署场景。
低精度量化(INT4):大幅压缩模型体积、降低显存占用,存在轻微精度损耗,适配端侧、低算力设备部署。
量化不修改模型核心结构与推理逻辑,仅优化参数存储格式,可大幅降低大模型部署的硬件门槛,提升模型推理速度,是大模型端侧落地、规模化部署的必备技术。
第四部分:真实AI系统的构建方式
RAG(检索增强生成)
💪
检索增强生成是融合外部知识库检索与大模型生成能力的落地架构,通过实时调取外部真实知识辅助生成,从根源缓解大模型幻觉、知识滞后、私有知识缺失的问题。
整体运行流程分为文档向量化、实时检索、增强生成三个阶段:
文档向量化:将私有文档、实时资料、行业知识库切片并转化为向量,存入向量数据库完成索引构建。
实时检索:用户提问时,将问题向量化,在向量数据库中检索相似度最高的真实参考资料。
增强生成:将检索到的真实知识与用户问题拼接为上下文,输入大模型生成精准、真实的回答。
RAG无需微调模型参数,可实时更新知识库内容,有效弥补大模型预训练知识的局限性,大幅提升生成内容的真实性、专业性与时效性,是企业知识库问答的核心架构。
Vector Database(向量数据库)
💪
向量数据库是专门面向高维Embedding向量数据的专用存储与检索数据库,针对向量相似度计算做了深度优化,是RAG系统、语义检索场景的核心底层基座。
整体核心能力分为向量存储、索引构建、相似度检索三个模块:
向量存储:高效存储海量文本、图像对应的高维稠密向量,支持批量导入、更新与删除管理。
相较于传统数据库,向量数据库可高效识别语义相似度,而非仅匹配关键词,完美适配AI语义检索、知识匹配、推荐系统等智能场景,是生成式AI落地的核心存储基础设施。
AI Agent(人工智能体)
💪
AI Agent是具备自主感知、规划、决策、执行能力的智能AI程序,突破了传统大模型单轮对话的局限,可自主拆解复杂任务并完成全流程闭环作业。
整体运行链路分为任务感知、规划拆解、工具调用、迭代执行四个环节:
任务感知:接收用户复杂目标,识别任务核心需求、约束条件与执行目标。
规划拆解:将复杂整体任务拆解为多条可分步执行的简单子任务,梳理执行顺序与逻辑链路。
工具调用:自主调用搜索、计算、文档处理、接口服务等外部工具,弥补模型能力短板。
迭代执行:根据子任务执行结果动态调整规划,循环迭代,直至完成整体目标。
AI Agent具备自主思考、动态纠错、多工具协同的能力,可实现自动化办公、智能调研、复杂问题求解等高阶场景应用,是下一代人工智能交互的核心形态。
思维链(CoT)
💪
思维链是一种引导大模型分步推理的提示范式与能力机制,通过模拟人类循序渐进的思考方式,拆解复杂问题、分步推导结论,大幅提升模型复杂推理任务的准确率。
整体推理流程分为问题拆解、分步推导、结论汇总三个阶段:
问题拆解:将复杂的数理、逻辑、推理类问题,拆分為多个简单可求解的子问题。
分步推导:基于已知条件,逐步骤运算、推理、验证,记录每一步的逻辑与计算过程。
结论汇总:整合所有分步推导结果,校验逻辑完整性,输出最终标准答案。
思维链无需修改模型参数,仅通过提示引导模型开启推理逻辑,有效解决大模型复杂数学计算、逻辑推理、因果分析等任务准确率低的问题,是提升模型高阶推理能力的轻量化核心手段。
Diffusion Model(扩散模型)
💪
思维链是一种引导大模型分步推理的提示范式与能力机制,通过模拟人类循序渐进的思考方式,拆解复杂问题、分步推导结论,大幅提升模型复杂推理任务的准确率。
整体推理流程分为问题拆解、分步推导、结论汇总三个阶段:
问题拆解:将复杂的数理、逻辑、推理类问题,拆分為多个简单可求解的子问题。
分步推导:基于已知条件,逐步骤运算、推理、验证,记录每一步的逻辑与计算过程。
结论汇总:整合所有分步推导结果,校验逻辑完整性,输出最终标准答案。
思维链无需修改模型参数,仅通过提示引导模型开启推理逻辑,有效解决大模型复杂数学计算、逻辑推理、因果分析等任务准确率低的问题,是提升模型高阶推理能力的轻量化核心手段。
人工智能的工作原理:
神经网络 —— 分层模式学习
分词 —— 将文本拆分成片段
嵌入 —— 将含义转化为数字
注意力 —— 上下文决定意义
变压器 —— 一切背后的架构
大语言模型的工作原理:
大语言模型 —— 大规模的下一个标记预测
上下文窗口 —— 内存限制与中间问题
温度 —— 创造力调节旋钮
幻觉 —— 自信却错误
提示词工程 —— 你如何进行沟通
模型如何改进:
迁移学习 —— 借鉴已有成果
微调 —— 让模型更专业
RLHF —— 教它变得有用
LoRA —— 无需高昂成本的微调
量化 —— 在小型设备上运行大型模型
真实系统的构建方式:
RAG —— 先查一查,再作答
向量数据库 —— 按含义搜索
AI智能体 —— 从回答到执行
思维链 —— 给它思考的空间
扩散模型 —— 从噪声到图像