AI Agent 从原理到应用,技术解析+实战拆解
关于Agent记忆系统的一些基础知识
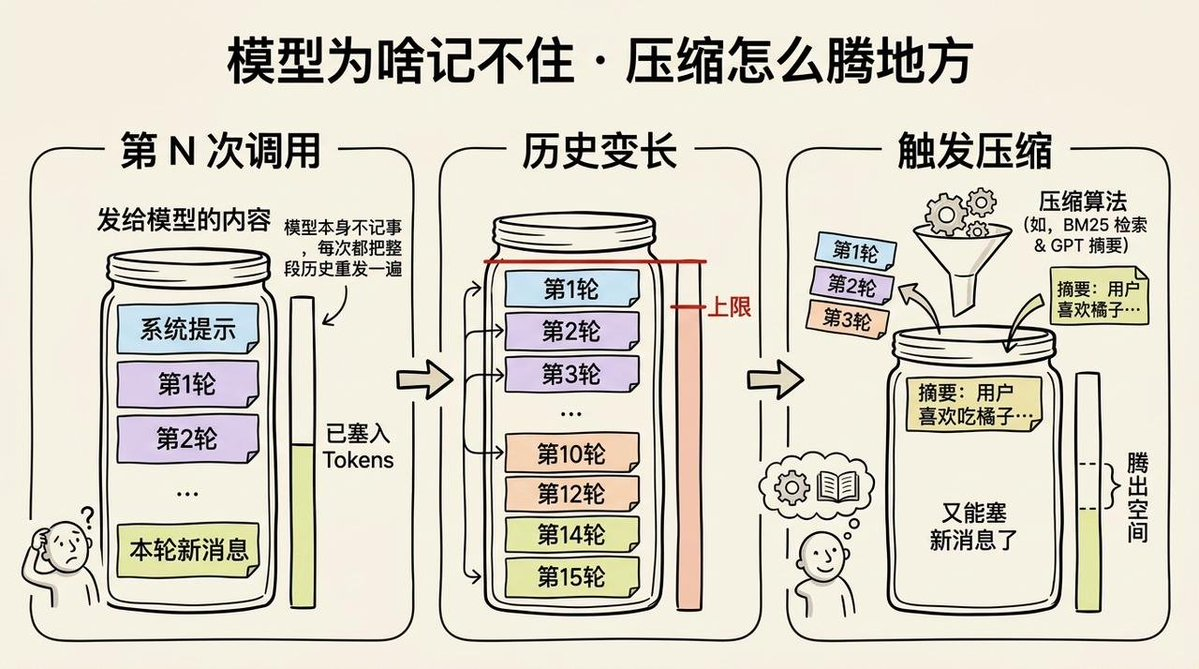
大模型单次独立API调用之间本身不具备记忆能力。
举例说明:首次调用告知模型偏好橘子,若第二次调用未将该内容拼接至提示词中,模型便无法知晓此前的对话信息。
💡
智能体(Agent)实现对话记忆的原理如下:
用户每发起一轮交互,系统都会将完整历史对话随请求一同传入提示词,以此保留近期对话内容。当对话总量超出模型上下文长度上限时,系统会对历史记录进行总结压缩,再将精简后的内容重新写入提示词,从而释放空间、延续对话。
以上即为大模型在长对话场景下维持记忆的完整逻辑,若理解存在困惑,可结合图示进一步参考。
50%
50%
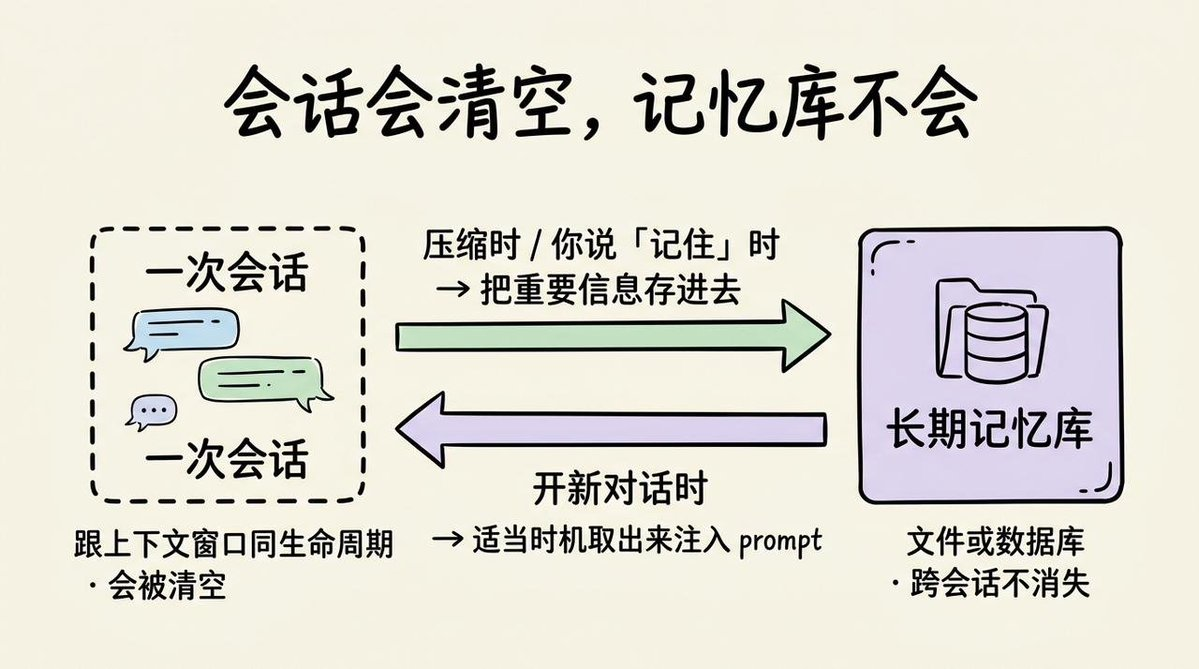
掌握单一会话的记忆机制后,再来了解跨会话的记忆实现方式,这就需要依托长期记忆系统。
💡
该系统会在上下文压缩或收到记忆指令时,将关键信息持久存储;开启新对话后,再按需提取相关内容并并入提示词。通过这种信息流转的方式,让智能体具备长期记忆能力,原理与人脑的工作记忆、长期记忆机制相近。
记忆系统
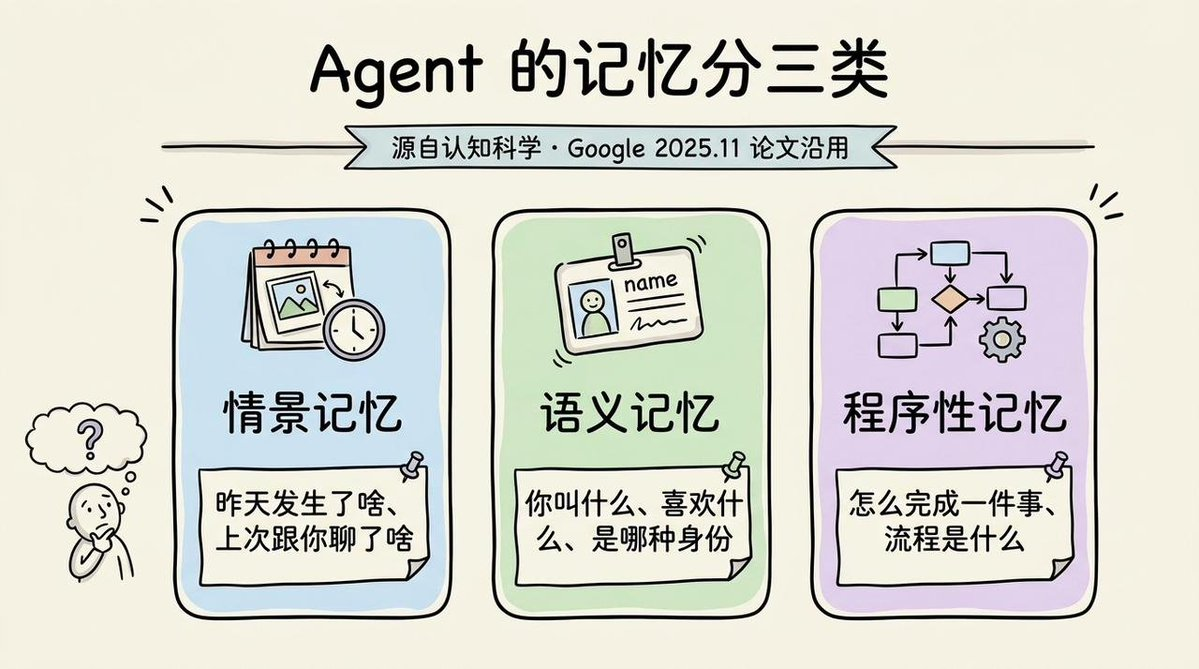
智能体的完整记忆体系划分为三大核心类别:
💡
•
情景记忆,用于记录过往交互与事件数据;
•
语义记忆,用于储存固定的客观事实与用户属性偏好;
•
程序性记忆,用于沉淀任务执行方法与标准化操作流程。
三大记忆模块相辅相成,共同构成智能体完整的记忆系统。
第一,记忆的分类:每种存什么?
按时间和抽象程度,通常分为三类:
•
短期记忆:当前对话或任务中的上下文,如用户刚说的“我想订明天去北京的机票”。它随着对话结束而清空。
•
长期记忆:跨越多次会话的信息,如用户的偏好(“喜欢靠窗座位”)、背景(“住在成都”)、历史行为(“上个月投诉过客服”)。它又可分为:
💡
•
事实记忆:客观事实,如“用户在成都”。
•
经验记忆:智能体自身学习到的教训,如“上次调用API超时,下次应先检查网络”。
第二,记忆的操作流程:如何抽取、更新、检索?
抽取:从对话或执行日志中提炼出值得长期保存的信息,而非机械存储全部历史。常用方法包括:用LLM判断哪句话包含新事实或重要结论;用规则(如“用户提到‘我是……’”);或用差异对比(比较当前陈述与已有记忆是否冲突或新增)。
更新:解决信息冲突与过时问题。核心是合并逻辑:例如三个月前记录“用户在大理”,现在用户说“我搬到成都了”,系统应自动将地址更新为“成都”,而非同时保留两条矛盾记录。更新策略可以是:
💡
•
覆盖式:新信息明确否定旧信息(如搬家)。
•
追加式:新信息是补充(如“用户也喜欢喝咖啡”)。
•
时间戳优先:以最新的为准。
•
置信度合并:当信息来源可靠度不同时,采用高分值信息。
检索:在需要时快速、准确地召回相关记忆。方法包括:
💡
•
关键词检索:匹配精确词汇,适合查找地名、人名、订单号。
•
语义检索:基于向量相似度,适合模糊查询(如“用户上次不开心的事情”)。
•
融合检索:结合关键词与语义,平衡精确与泛化。
•
LLM辅助检索:将记忆当作文档,让LLM分析上下文后主动决定召回哪些记忆(如“用户问‘我的包裹到了吗’,LLM意识到需要查询‘最近的订单号’和‘物流偏好’两条记忆”)。
OpenClaw的记忆有多少种分类,分为下面三类:
💡
memory.md(记忆):
属于语义记忆,存储,你的身份、偏好、稳定事实。
daily logs(每日日志):
属于情景记忆,记录每天发生了啥,按天组织,只会添加新的条目,不会删除。
抽取发生在三种情况下:
💡
对话即将被压缩的时候:这个时候会讲有价值的信息写入每日日志中。
你用 /new 或 /reset 命令开启一个新会话:会将有价值的信息保存到会话快照中。
检索会发生在下面两种情况:
💡
开启一个新的对话,就会将memory.md 都会被自动注入到 prompt,而且还会去读今天和昨天的每日日志,以获取最近的上下文。
当OpenClaw觉得有必要看记忆时,会先调用memory search,通过融合搜索(关键词+向量)找到记忆所在地点,再通过 memory get读取文件内容。
假如还是不太理解,可以看下图:
OpenClaw 的记忆系统问题不少:
很费Token
Markdown 没了记忆就消失
经常遗忘东西
企业级 Agent 记忆系统
之所以说“每一个程序员都该搞懂企业级Agent记忆系统”,原因在于:
从“编写逻辑”到“编排上下文”:传统编程的核心是流程控制与数据结构的逻辑。而Agent编程的核心是上下文工程——如何高效地注入、检索、更新和淘汰信息。记忆系统就是Agent的“数据库+缓存+知识库”三位一体。
企业级应用的刚需:一个只有“对话窗口”的聊天机器人毫无商业价值。企业需要的是能记住三个月前的项目决策、能学习用户偏好、能在长流程任务中保持一致性的智能体。没有记忆,Agent每轮对话都是“失忆患者”。
差异化竞争点:所有主流模型(GPT-4、Claude、Gemini)的基座能力正快速趋同。真正让一个客服Agent优于另一个的,不是模型本身,而是它背后的记忆抽取质量、更新策略的智能程度和检索的精准度。
第一问:记忆怎么分类?
通用框架是 3 类,具体如下图:
语义记忆
💡
•
稳定特质:你是夜猫子、是程序员、住北京,这种长期不变的
•
临时状态:你今天熬了夜、这周特别忙、上周感冒了
情景记忆
💡
•
Episode(剧情记忆):把一段对话或任务梳理成的浓缩概要,不是按天的流水账 例:用户问怎么部署模型,卡在环境变量,折腾了 30 分钟
•
EventLog(事件日志):把对话里的关键事实拆出来,每条带时间戳 例:2026-05-10 用户买了 Mac mini,2026-05-12 用户绑了 GitHub
•
Foresight(未来记):跟时间有关的"接下来"——你说过要做的、它推断你之后会涉及的,带有效时间,到点能提醒 例:下周五前把方案发出来
程序性记忆
💡
•
Agent Case(任务档案):干完一次任务,把"想干什么 + 一步步怎么做的 + 一个质量分"记下来
例:发邮件,它先查通讯录、起草、让你确认、再发出去——这一套连同质量分一起存档
•
Agent Skill(蒸馏技能):同类任务做过几次后,自动从这些档案里蒸馏出通用打法,还带个成熟度分,做得越多越靠谱
第二问:抽取、更新、检索怎么做?
如何抽取记忆?
记忆单元,每个单元里装 4 样东西:
💡
•
剧情:这一段聊了什么、做了什么:一段浓缩的概要,不是原话照搬
•
关键事实:里面有哪些值得单独拎出来记的事
•
未来记:你说过要做的、它推断你之后会涉及的,带上有效时间,到点能提醒
•
上下文标签:什么时候、在哪、可信度多高、当时什么情绪
如何更新记忆呢?
举个例子:
一个月之前,你跟 AI 助手聊天时先说:我最近准备健身。两周后,你又说:最近忙,没去健身房。今天你说:算了,不健身了。
普通方案是三条都堆进日志,到时候大模型检索出来哪条,就认为哪条是事实。但事实上,答案应该是最新的一条。
•
自动判断哪条是最新的(健身已经停了)
•
重复的、说的是同一件事的,合到一起
•
维护一份你的用户画像,把稳定偏好和临时状态分开存(这一步官方叫 Profile Evolution)
具体如下图所示:
如何检索记忆呢?
4 种检索方式,按场景选:
💡
•
关键词:精确匹配词,适合查具体的名字、ID
EverOS 在长程记忆评测 LoCoMo 上拿了 93.05% 的总体准确率(用 GPT-4.1-mini),把对比方案 Zep 的 85.22% 甩开了将近 8 个百分点。
代码块
Python
from everos import EverOS
client = EverOS(api_key="your_key")
agent = client.v1.memories.agent
💡 两点要注意:
•
第一次喂轨迹只生成 case(单次任务的存档),跑过几次同类任务后端才聚类蒸馏出 skill
•
必须用 /memories/agent 这条端点,普通 /memories 抽不出 skill
如果你不理解Skill自进化功能,可以看看下图:
简单说一个代码上的用法,但这个项目作为Agent的基础设施,有着极为价值的真实使用案例。
•
MemoCare(阿尔茨海默记忆助手):给认知衰退的患者配一个永不遗忘的外部记忆——这是其中最有温度的一个公益项目
•
Claude Code Plugin:给 Claude Code 装上长期记忆,跨 session 不忘
•
Game of Thrones:给 AI 灌权游剧情演角色,长期记得自己是谁
•
OpenHer:AI 女友,情感陪伴 + 记忆演化
•
Computer-Use with Memory:让 Agent 操控电脑,记住每次操作的经验
•
Memory Graph Visualization:把记忆系统画成可视化图谱