Agent 搭建六大核心流程
🎁
很多人用 Agent,但很少人理解 Agent 内部机制。他们把 Agent 当成"框架API调用",而不是一个完整的系统。从底层原理讲清楚 Agent 的六大核心流程,让你不只是"会用框架",而是真正理解 Agent 是什么、为什么这样设计。
以上为智能体通用架构体系,属于具体落地实现方式,并非所有智能体的统一标准。
一、Agent Loop——Agent 的"心跳"
40%
60%
1.1 什么是 Agent Loop?
想象一个场景:你要让 AI 帮你"部署一个网站"。
一轮 LLM 调用通常会怎么做?它直接输出一堆部署步骤,然后你就得自己去执行。你执行到一半遇到问题,再回去问 AI,AI 再给你一个答案……
Agent 不一样。它会自己执行:
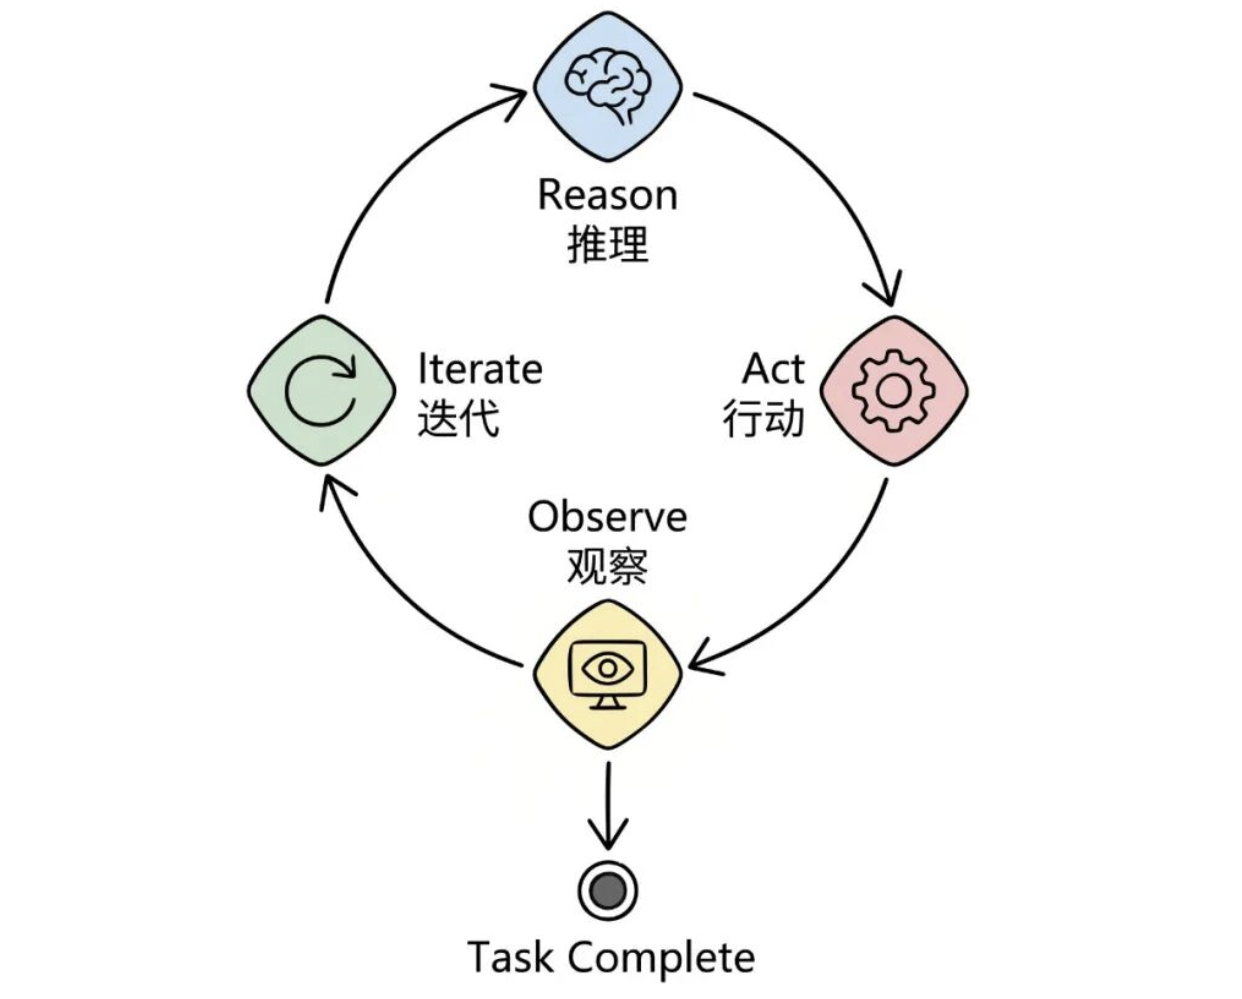
推理(Reason):分析任务,制定计划
行动(Act):调用工具,执行操作
观察(Observe):看执行结果,判断是否成功
迭代(Iterate):如果失败,调整策略,继续循环
这就是 Agent Loop——一个持续运行的"推理-行动-观察"闭环。
用伪代码表示:
代码块
Plain Text
def agent_loop(task, max_iterations=50):
context = {"task": task, "history": [], "state": "planning"}
for i in range(max_iterations):
# 1. 推理:分析当前状态,决定下一步
thought = model.reason(context)
# 2. 行动:调用工具或生成回复
if thought.action_type == "tool_call":
result = execute_tool(thought.tool_name, thought.tool_args)
else:
result = thought.response
# 3. 观察:记录结果,更新状态
context.history.append({"thought": thought, "result": result})
1.2 Agent Loop 的关键设计
迭代上限:防止无限循环(不同系统差异很大,常见做法是按任务类型设置 10-100 次不等)
状态管理:记录每次迭代的 thought + result
早停机制:任务完成或遇到不可恢复错误时提前退出
人机交互:高危操作需要用户确认(approval)
1.3 与普通 LLM 调用的本质差异
这里的"普通 LLM",指的是没有工具、没有循环控制、没有状态管理的一轮模型调用。现代 ChatGPT、Claude、Gemini 等产品本身也可能内置工具能力,所以更准确的对比是:
比喻:一轮 LLM 调用像"租来的顾问",给你方案但不动手;Agent 像"带工具的执行者",会边做边看结果,再调整下一步。
二、记忆系统——Agent 的"长期大脑"
2.1 记忆系统的三个组件
Agent 的记忆由三个组件构成:
下面用 Hermes 的记忆设计举例,它大致可以拆成三层:
代码块
Plain Text
┌────────────────────────────────────────────┐
│ 第一层:MEMORY.md + USER.md │ ← 长期记忆
│ - MEMORY.md:Agent 的笔记(2,200 chars) │
│ - USER.md:用户画像(1,375 chars) │
├────────────────────────────────────────────┤
│ 第二层:外部 Memory Provider │ ← 可选扩展
2.2 Frozen Snapshot 模式
有个问题:如果每一轮请求都把频繁变化的记忆混在 prompt 前缀里,就很难利用 LLM 的 prefix cache;如果完全实时读取,又会增加 token 成本和上下文噪音。
Hermes 的解决方案:Frozen Snapshot。
•
• Session 启动时,把 MEMORY.md + USER.md 注入 system prompt
•
• Session 运行期间,记忆修改即时持久化到文件
•
• 当前 session 继续使用启动时的快照,下一个 session 才读取新版本(保证缓存友好)
2.3 检索策略
表格加载中...
Hermes 更偏向本地 FTS5 + LLM 摘要;OpenClaw 这类系统通常会把本地记忆、会话搜索和更细粒度的检索能力结合起来,避免只依赖一种召回方式。
2.4 记忆管理实战
大小限制:例如 Hermes 默认 MEMORY.md 约 2,200 chars(避免长期记忆无限膨胀)
压缩策略:定期用 LLM 摘要,提炼精华
遗忘机制:低价值信息自动清理(flush_memories)
三、工具系统——Agent 的"手脚"
Agent Loop 解决执行循环,记忆系统解决持久化。但要真正"做事",Agent 还需要工具。
3.1 工具注册与发现
Agent 不是天然"知道"有什么工具可用。多数工程实现会把工具注册成结构化描述,让模型在推理时看到工具名、用途和参数约束:
代码块
Plain Text
# 工具注册
tool_registry.register({
"name": "execute_command",
"description": "在终端执行 shell 命令",
"parameters": {
"command": {"type": "string", "description": "要执行的命令"},
"timeout": {"type": "integer", "default": 30000}
},
"risk_level": "high", # 高危操作
3.2 MCP 协议:统一接口标准
有个痛点:如果每个 Agent 都要为每个工具写 custom integration,生态会很碎片化。
MCP(Model Context Protocol) 解决了这个问题:
•
• 类比:MCP = AI 界的 USB-C
•
• 好处:工具可以按统一协议暴露,Agent 侧只需对接 MCP Client
•
• 架构:数据源、API、开发工具等可以封装成 MCP Server,供支持 MCP 的 Agent 调用
代码块
Plain Text
┌──────────────┐ ┌──────────────┐
│ Agent │ │ MCP Server │
3.3 工具选择策略
LLM 怎么决定调用哪个工具?
核心机制:Tool Description + 参数 Schema + LLM 推理
代码块
Plain Text
{
"tools": [
{
"name": "execute_command",
"description": "在终端执行 shell 命令。适合文件操作、系统管理、脚本执行。",
LLM 根据任务语义 + 工具描述,选择最合适的工具。
3.4 如何设计一个好的 Tool
清晰描述:让 LLM 能理解工具用途
参数 Schema:明确输入类型和约束
风险评估:高危操作标记 requires_approval
错误处理:失败时返回清晰错误信息
四、Context Engine——Agent 的"调度中枢"
4.1 Prompt 组装流程
以 Hermes 为例,prompt_builder.py 负责把多类上下文组装成完整 prompt:
代码块
Plain Text
┌────────────────────────────────────────────┐
│ System Prompt 组装 │
├────────────────────────────────────────────┤
│ 1. SOUL.md — Agent 身份和风格 │
│ 2. USER.md — 用户偏好 │
│ 3. MEMORY.md — 长期记忆 │
│ 4. Skills — 按需加载的领域知识 │
│ 5. MCP Tools — 当前可用的工具声明 │
│ 6. Session History — 本次对话历史 │
│ 7. Dynamic Context — 任务相关的动态信息 │
└────────────────────────────────────────────┘
4.2 Frozen Snapshot vs 动态注入
为什么分两种?
•
Frozen 部分可以利用 Anthropic Prompt Caching(节省成本)
•
Dynamic 部分必须实时更新(否则 Agent 不知道发生了什么)
4.3 Context Budget 管理
有个现实问题:当模型支持 200K tokens 级别上下文时,应该怎么分配?
一个可参考的分配策略:
4.4 缓存策略
Anthropic 提供 Prompt Caching。它的核心价值是:当 prompt 前缀稳定、缓存命中时,可以减少重复处理长上下文的成本和延迟。
•
• Frozen 部分尽量放在稳定前缀中,提高缓存命中率
•
• 官方说法是长 prompt 场景下成本最高可降低约 90%,但前提是缓存命中、前缀稳定、缓存未过期
五、推理引擎——Agent 的"思考核心"
5.1 模型选择:不同任务用不同模型
不是所有任务都需要最强模型。很多 Agent 系统会采用 Auxiliary 模型 机制:主模型负责复杂推理,辅助模型负责图片理解、网页抽取、压缩、摘要等子任务。
以 Hermes 的配置思路为例:
省钱原理:主模型专注复杂决策,低成本模型处理可拆分的辅助任务。
5.2 DSPy + GEPA:自我进化实验
注意:这是 Hermes 的独立项目 hermes-agent-self-evolution,目前只有 Phase 1(Skill 文件优化)已实现,Phase 2-5 尚在规划中。
DSPy:把 LLM 当成可编程模块,自动优化 prompt
GEPA(Genetic-Pareto):一种反思式 prompt 优化方法,用演化搜索和 Pareto 选择改进文本组件
核心思路:读取执行轨迹来理解为什么失败,然后针对性改进 Skill 文件。
工作流程:
代码块
Plain Text
读取当前 skill ──► 生成 eval 数据集
│
▼
GEPA Optimizer
│
▼
Candidate variants ──► 评估
│
防护措施(测试、大小限制)
成本:每次优化运行 $2-10,不需要 GPU。
现状:Phase 1 已实现(Skill 文件),Phase 2-5(Tool description、System prompt、代码、持续循环)仍在规划。
5.3 推理链策略
六、上下文压缩——Agent 的"内存管家"
Context 不会无限增长,历史越长越接近 token limit。这时候需要压缩。
6.1 为什么需要压缩?
问题:
•
• 200K tokens 是上限,不是无限
•
• Session History 会持续增长
•
• 成本随 tokens 增加(Prompt Caching 只覆盖 Frozen 部分)
后果:
•
• 超过限制 → 早期信息被截断或必须被摘要
•
• 成本上涨 → 长任务的 API 调用费用明显增加
6.2 压缩策略
6.3 Hermes 的 context_compressor
核心逻辑:
代码块
Plain Text
def compress_context(history, max_tokens=10000):
# 1. 识别关键节点
key_nodes = identify_key_events(history) # 工具调用、重要决策
# 2. 有损摘要
summary = auxiliary_model.summarize(history, max_tokens)
# 3. 合并
6.4 实战建议
何时压缩:当 Session History 接近 budget 上限
压缩什么:低价值对话(闲聊)、冗余信息
保留什么:关键决策、工具调用结果、任务状态
总结:六大支柱协同运作
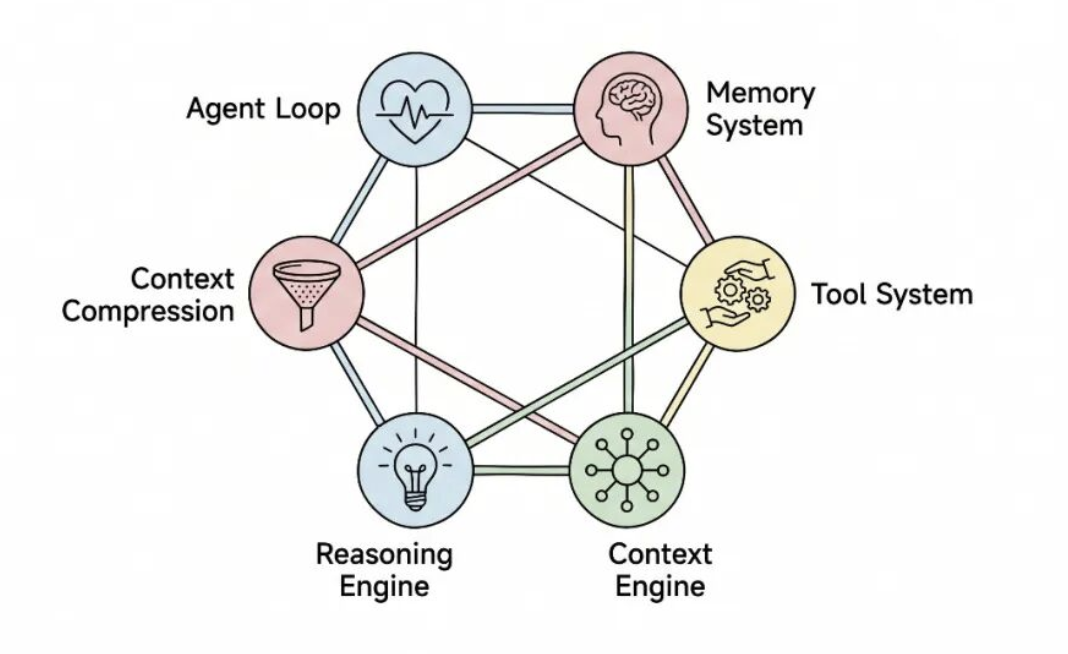
回顾一下 Agent 的完整架构。更准确地说,这不是一条严格的单向流水线,而是一组相互协作的模块:
代码块
Plain Text
核心洞察:
•
Agent Loop 是骨架——持续循环是 Agent 的本质
•
记忆系统 是大脑——持久化让 Agent"越用越懂你"
•
工具系统 是手脚——真正做事的能力
•
Context Engine 是调度——统筹所有信息
•
推理引擎 是思考——决定策略和模型
•
上下文压缩 是管家——管理有限资源
架构演进趋势
Agent 还在快速演进。几个值得关注的趋势:
MCP 标准化:MCP 已进入 Linux Foundation 旗下 AAIF,主流 Agent 生态会越来越多兼容
自我进化:DSPy + GEPA 自动优化 Skill 和 Prompt(仍在实验阶段)
多 Agent 协作:Subagent 隔离上下文,分工协作
持续压缩:Context Budget 管理越来越智能
行动建议
如果你想深入理解 Agent:
理解 Agent Loop:这是 Agent 的核心,抓住这个就抓住了本质
观察 Context Budget:看看不同任务消耗多少 tokens
配置一个 MCP Server:连接 PostgreSQL 或 GitHub,体验统一接口
体验记忆系统:跨会话对话,感受持久化的威力
理解原理,才能设计出真正有用的 Agent。