第十章 DBSCAN聚类
🌐
首先简单来说,DBSCAN 是一种用来在数据集中发现密集区域的算法,它 stands for Density-Based Spatial Clustering of Applications with Noise(基于密度的空间聚类算法)。
这个算法的核心思想是根据数据点周围的密度来进行聚类,而不是像传统的聚类算法那样事先假设聚类的数量。
具体来说,DBSCAN 可以帮助我们找出数据中那些被称为“核心点”的密集区域,以及那些在这些核心点周围、但不足以形成新的核心点的“边界点”。同时,它还能识别那些与任何聚类都不相关的“噪声点”。
在使用 DBSCAN 时,我们需要设置两个关键参数:ε(epsilon)和 MinPts。ε 确定了我们在空间中搜索密集区域的距离阈值,而 MinPts 指定了一个被认为是核心点的最小邻居数目。
总体来说,DBSCAN 通过将数据点分为核心点、边界点和噪声点,以及将核心点连接在一起形成聚类的方式,是一种非常实用的聚类算法,特别适合处理具有不规则形状和大小不一的聚类的数据集。
理论基础
DBSCAN 是基于密度的聚类算法,核心思想是通过分析数据点的局部密度来识别聚类。
数学原理与公式推理
1. 定义关键概念:
•
核心点(Core Point):一个数据点是核心点,当且仅当其 ε-邻域内至少包含 MinPts 个点(包括它自己)。
•
边界点(Border Point):一个数据点是边界点,如果它不满足核心点的条件,但是在某个核心点的 ε-邻域内。
•
噪声点(Noise Point):一个数据点是噪声点,如果它既不是核心点,也不是边界点,即它不在任何核心点的 ε-邻域内。
2. ε-邻域:
对于给定的数据点 ,其 ε-邻域定义为:
其中 是数据点 和 之间的距离,通常是欧几里得距离。
3. 核心点的条件:
一个数据点 是核心点,当且仅当:
其中 是数据点 的 ε-邻域内点的数量。
算法流程
1. 初始化:
•
设定参数:ε(距离阈值)和 MinPts(最小邻居点数)。
2. 遍历每个数据点:
•
对每个数据点 ,判断其是否为核心点:
◦
计算 的 ε-邻域 。
◦
如果 ,则 是核心点。
3. 创建新聚类:
•
如果数据点 是核心点:
◦
创建一个新聚类,并将 添加到这个聚类中。
◦
对于 的每一个 ε-邻域中的点 :
◦
如果 是边界点(即不是核心点,但在核心点的 ε-邻域内),则将 添加到当前聚类中。
◦
如果 是核心点,则将 以及其 ε-邻域中的所有点添加到当前聚类中。
◦
对于 的 ε-邻域中的每一个点重复这个过程,直到所有密集区域的点都被纳入聚类中。
4. 标记噪声点:
•
对于那些既不属于任何聚类也不在任何核心点的 ε-邻域内的点,将其标记为噪声点。
公式推理
1. 计算 ε-邻域:
对于点 和 ,假设我们使用欧几里得距离:
其中 和 是点 和 在第 个维度上的坐标。
2. 确定核心点:
对于数据点 ,其 ε-邻域的点集 中的点 满足:
如果:
则 是核心点。
3. 聚类扩展:
如果数据点 是核心点,则对 的每个 ε-邻域点 执行递归扩展:
•
检查 是否为核心点。
•
将 以及 的 ε-邻域中的点加入当前聚类。
通过这种方式,DBSCAN 可以有效地处理具有不同形状和大小的聚类,同时能够识别噪声点。
Python案例
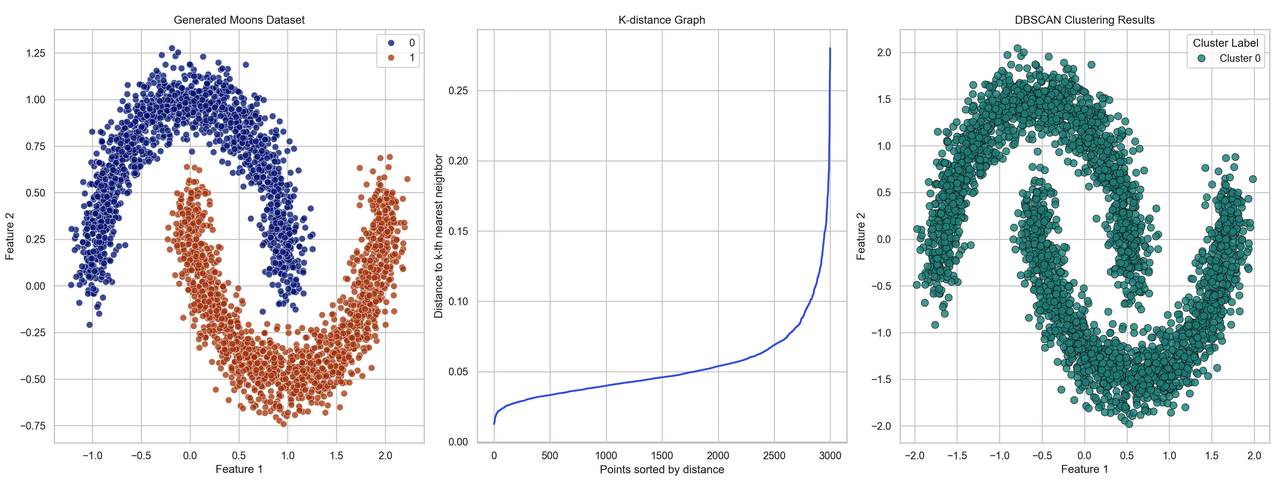
现在,我们可以使用 make_moons 生成一个月亮形状的数据集,并应用 DBSCAN 进行聚类。
整个代码可以很清楚的看到,使用 DBSCAN 对生成的虚拟数据集进行聚类,包括数据生成、参数选择、聚类、结果可视化和算法优化。
1. 导入库和生成数据
首先,我们需要导入必要的库并生成月亮形状的数据集。
代码块
Python
import numpy as np
2. 数据预处理
对数据进行标准化处理,以适应 DBSCAN 的要求。
代码块
Python
3. 确定 DBSCAN 的参数
使用 K-距离图来选择 ε(邻域距离阈值)参数,并选择合适的 MinPts(最小邻居数)。
代码块
Python
# 设置 MinPts(邻居数)
min_samples = 5
# 使用 NearestNeighbors 计算 K 距离
neighbors = NearestNeighbors(n_neighbors=min_samples)
neighbors_fit = neighbors.fit(X_scaled)
distances, _ = neighbors_fit.kneighbors(X_scaled)
# 计算第 min_samples 个最近邻的距离
distances = np.sort(distances[:, -1], axis=0)
4. 应用 DBSCAN 聚类
选择 ε 值和 MinPts,应用 DBSCAN 聚类,并分析结果。
代码块
Python
6. 评估聚类效果
使用轮廓系数(Silhouette Score)来评估聚类效果。
代码块
Python
# 计算轮廓系数
if n_clusters > 1:
silhouette_avg = silhouette_score(X_scaled, labels)
print(f"Silhouette Score: {silhouette_avg:.3f}")
else:
print("Silhouette Score cannot be computed, only one cluster found or all points are noise.")
7. 优化
DBSCAN 的参数选择对于聚类效果至关重要。
2 点优化方式:
1. 网格搜索:尝试不同的 ε 和 MinPts 值组合,通过评估聚类效果来选择最佳参数。
2. 自动选择 ε:除了 K-距离图,还可以使用密度图等方法来自动选择 ε 值。
代码块
Python
from sklearn.model_selection import ParameterGrid
# 网格搜索参数优化
param_grid = {'eps': [0.2, 0.3, 0.4, 0.5], 'min_samples': [3, 5, 7, 10]}
best_score = -1
best_params = None
for params in ParameterGrid(param_grid):
dbscan = DBSCAN(eps=params['eps'], min_samples=params['min_samples'])
labels = dbscan.fit_predict(X_scaled)
if len(set(labels)) > 1: # 仅当找到多个簇时计算轮廓系数
score = silhouette_score(X_scaled, labels)
if score > best_score:
best_score = score
best_params = params
print(f"Best Parameters: {best_params}")
咱们总结一下这个案例,我们使用 DBSCAN 对生成的月亮形状数据集进行了聚类。
DBSCAN 可以有效地处理具有复杂形状的聚类,并识别噪声,但参数选择对于聚类效果至关重要。
通过 K-距离图和网格搜索等方法,我们可以优化 DBSCAN 的性能。在大家实际实验中,根据数据的特性和需求选择合适的参数和算法是关键。
模型分析
在使用 DBSCAN 算法时,我们可以评估其优缺点,并将其与其他相似的聚类算法进行对比,以确定在何种情况下 DBSCAN 是优选算法,何时可能需要考虑其他算法。
DBSCAN 算法的优缺点
优点
1. 处理噪声点:DBSCAN 可以识别噪声点(孤立点),将它们分离出来,而不是将它们误分到某个聚类中。这在处理现实世界中的数据时尤其重要,因为数据中常常包含噪声和异常值。
2. 无需事先指定聚类数:与 K-Means 不同,DBSCAN 不需要用户事先指定聚类的数量,而是通过密度来自动识别聚类的数量。
缺点
1. 对参数设置敏感:DBSCAN 的效果高度依赖于 ε(邻域距离阈值)和 MinPts(最小邻居数)这两个参数的设置。如果参数选择不当,可能导致聚类效果不佳。例如,选择的 ε 值过大或过小都会影响聚类结果。
2. 对密度变化敏感:DBSCAN 在处理数据密度变化较大的情况时可能会遇到困难。在数据集存在不同密度区域时,DBSCAN 可能难以找到合适的参数来处理所有区域。
3. 计算复杂度:在大规模数据集上,DBSCAN 的计算复杂度可能较高。尽管 DBSCAN 的时间复杂度为
O(nlogn)
(通常基于使用 KD-Tree 或 Ball-Tree),但在处理大规模数据集时,计算和内存消耗可能会显著增加。
与其他相似算法的对比
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
| | | |
何时选择 DBSCAN
•
数据具有复杂形状:当数据集中的聚类具有非球形结构或不均匀密度时,DBSCAN 是一个较好的选择。
•
存在噪声点:如果数据集中包含噪声或离群点,并且需要将这些点与主要的聚类分开,DBSCAN 能有效处理这些噪声点。
•
不确定聚类数量:如果不清楚数据集的聚类数量,DBSCAN 可以通过其密度特性自动识别聚类的数量。
何时考虑其他算法
•
数据集较大且密度均匀:如果数据集规模很大且数据密度相对均匀,K-Means 可能会更有效,因为它计算复杂度较低。
•
需要确定聚类数:如果聚类数是已知的或可以合理估计,K-Means 或其他需要指定聚类数量的算法(如 Gaussian Mixture Models)可能更适用。
•
数据集具有层次结构:如果数据具有明显的层次结构,并且需要分析这种层次结构,可以考虑使用层次聚类算法。
最后
DBSCAN 是一个强大的聚类工具,特别适用于处理复杂形状的聚类和数据中存在噪声的情况。
然而,它的性能高度依赖于参数的选择,并且在密度变化大或数据集非常大的情况下可能表现不佳。在选择聚类算法时,需要根据数据的特性和具体需求来综合考虑,选择最合适的算法。