第二章 Logistic 回归(逻辑回归)
Logistic 回归「概述」
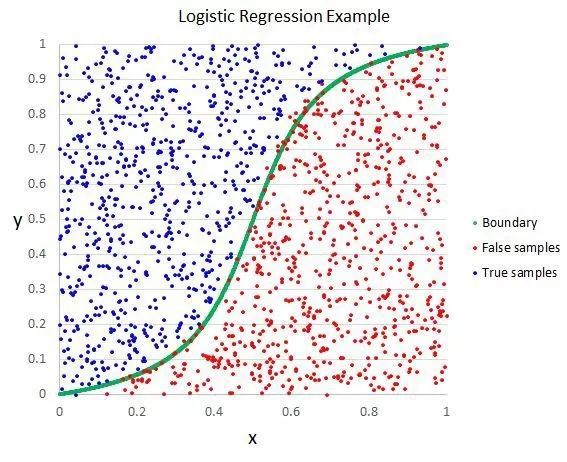
Logistic 回归 或者叫逻辑回归 虽然名字有回归,但是它是用来做分类的。其主要思想是: 根据现有数据对分类边界线(Decision Boundary)建立回归公式,以此进行分类
Sigmoid 函数
回归「概念」
假设现在有一些数据点,我们用一条直线对这些点进行拟合(这条直线称为最佳拟合直线),这个拟合的过程就叫做回归。进而可以得到对这些点的拟合直线方程,那么我们根据这个回归方程,怎么进行分类呢?请看下面
二值型输出分类函数
我们想要的函数应该是: 能接受所有的输入然后预测出类别
🥖
例如,在两个类的情况下,上述函数输出 0 或 1.或许你之前接触过具有这种性质的函数,该函数称为 海维塞得阶跃函数(Heaviside step function),或者直接称为 单位阶跃函数
然而,海维塞得阶跃函数的问题在于: 该函数在跳跃点上从 0 瞬间跳跃到 1,这个瞬间跳跃过程有时很难处理
幸好,另一个函数也有类似的性质(可以输出 0 或者 1 的性质),且数学上更易处理,这就是 Sigmoid 函数。 Sigmoid 函数具体的计算公式如下:
下图给出了 Sigmoid 函数在不同坐标尺度下的两条曲线图。当 x 为 0 时,Sigmoid 函数值为 0.5 。随着 x 的增大,对应的 Sigmoid 值将逼近于 1 ; 而随着 x 的减小, Sigmoid 值将逼近于 0 。如果横坐标刻度足够大, Sigmoid 函数看起来很像一个阶跃函数
因此,为了实现 Logistic 回归分类器,我们可以在每个特征上都乘以一个回归系数(如下公式所示),然后把所有结果值相加,将这个总和代入 Sigmoid 函数中,进而得到一个范围在 0~1 之间的数值。任何大于 0.5 的数据被分入 1 类,小于 0.5 即被归入 0 类。所以,Logistic 回归也是一种概率估计,比如这里Sigmoid 函数得出的值为0.5,可以理解为给定数据和参数,数据被分入 1 类的概率为0.5。想对Sigmoid 函数有更多了解,可以点开此链接跟此函数互动
基于最优化方法的回归系数确定
Sigmoid 函数的输入记为 z ,由下面公式得到:
如果采用向量的写法,上述公式可以写成
它表示将这两个数值向量对应元素相乘然后全部加起来即得到 z 值。其中的向量 x 是分类器的输入数据,向量 w 也就是我们要找到的最佳参数(系数),从而使得分类器尽可能地精确。为了寻找该最佳参数,需要用到最优化理论的一些知识。我们这里使用的是——梯度上升法(Gradient Ascent)
梯度上升法
梯度的介绍
需要一点点向量方面的数学知识
代码块
Python
向量 = 值 + 方向
梯度 = 向量
梯度 = 梯度值 + 梯度方向
梯度上升法的思想
要找到某函数的最大值,最好的方法是沿着该函数的梯度方向探寻。如果梯度记为 ▽ ,则函数 f(x, y) 的梯度由下式表示:
这个梯度意味着要沿 x 的方向移动 ,沿 y 的方向移动
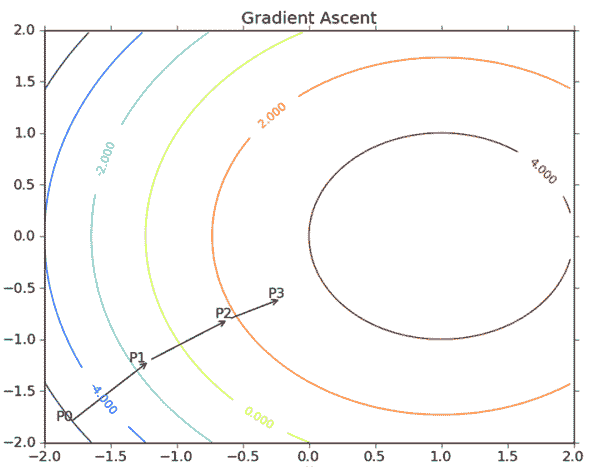
其中,函数f(x, y) 必须要在待计算的点上有定义并且可微。下图是一个具体的例子
上图展示的,梯度上升算法到达每个点后都会重新估计移动的方向。从 P0 开始,计算完该点的梯度,函数就根据梯度移动到下一点 P1。在 P1 点,梯度再次被重新计算,并沿着新的梯度方向移动到 P2 。如此循环迭代,直到满足停止条件。迭代过程中,梯度算子总是保证我们能选取到最佳的移动方向
上图中的梯度上升算法沿梯度方向移动了一步。可以看到,梯度算子总是指向函数值增长最快的方向。这里所说的是移动方向,而未提到移动量的大小。该量值称为步长,记作 α 。用向量来表示的话,梯度上升算法的迭代公式如下:
该公式将一直被迭代执行,直至达到某个停止条件为止,比如迭代次数达到某个指定值或者算法达到某个可以允许的误差范围
介绍一下几个相关的概念:
代码块
Python
例如: y = w0 + w1x1 + w2x2 + ... + wnxn
梯度: 参考上图的例子,二维图像,x方向代表第一个系数,也就是 w1,y方向代表第二个系数也就是 w2,这样的向量就是梯度。
α: 上面的梯度算法的迭代公式中的阿尔法,这个代表的是移动步长(step length)。移动步长会影响最终结果的拟合程度,最好的方法就是随着迭代次数更改移动步长。
步长通俗的理解,100米,如果我一步走10米,我需要走10步;如果一步走20米,我只需要走5步。这里的一步走多少米就是步长的意思。
▽f(w): 代表沿着梯度变化的方向。
问: 有人会好奇为什么有些书籍上说的是梯度下降法(Gradient Decent)?
答: 其实这个两个方法在此情况下本质上是相同的。关键在于代价函数(cost function)或者叫目标函数(objective function)。如果目标函数是损失函数,那就是最小化损失函数来求函数的最小值,就用梯度下降。 如果目标函数是似然函数(Likelihood function),就是要最大化似然函数来求函数的最大值,那就用梯度上升。在逻辑回归中, 损失函数和似然函数无非就是互为正负关系。
只需要在迭代公式中的加法变成减法。因此,对应的公式可以写成
局部最优现象 (Local Optima)
上图表示参数 θ 与误差函数 J(θ) 的关系图 (这里的误差函数是损失函数,所以我们要最小化损失函数),红色的部分是表示 J(θ) 有着比较高的取值,我们需要的是,能够让 J(θ) 的值尽量的低。也就是深蓝色的部分。θ0,θ1 表示 θ 向量的两个维度(此处的θ0,θ1是x0和x1的系数,也对应的是上文w0和w1)
可能梯度下降的最终点并非是全局最小点,可能是一个局部最小点,如我们上图中的右边的梯度下降曲线,描述的是最终到达一个局部最小点,这是我们重新选择了一个初始点得到的
看来我们这个算法将会在很大的程度上被初始点的选择影响而陷入局部最小点
Logistic 回归 原理
Logistic 回归 工作原理
代码块
Python
Logistic 回归 项目流程
代码块
Python
收集数据: 采用任意方法收集数据
准备数据: 由于需要进行距离计算,因此要求数据类型为数值型。另外,结构化数据格式则最佳。
分析数据: 采用任意方法对数据进行分析。
训练算法: 大部分时间将用于训练,训练的目的是为了找到最佳的分类回归系数。
测试算法: 一旦训练步骤完成,分类将会很快。
使用算法: 首先,我们需要输入一些数据,并将其转换成对应的结构化数值;接着,基于训练好的回归系数就可以对这些数值进行简单的回归计算,判定它们属于哪个类别;在这之后,我们就可以在输出的类别上做一些其他分析工作。
方向导数与梯度
Logistic 回归 项目案例
项目案例1: 使用 Logistic 回归在简单数据集上的分类
代码块
Python
#!/usr/bin/python
# coding: utf8
'''
Created on Oct 27, 2010
Update on 2017-05-18
Logistic Regression Working Module
Author: Peter Harrington/羊三/小瑶
GitHub: https://github.com/apachecn/AiLearning
'''
from __future__ import print_function
from numpy import *
import matplotlib.pyplot as plt
# ---------------------------------------------------------------------------
项目概述
在一个简单的数据集上,采用梯度上升法找到 Logistic 回归分类器在此数据集上的最佳回归系数
开发流程
代码块
Python
收集数据: 可以使用任何方法
收集数据: 可以使用任何方法
我们采用存储在 TestSet.txt 文本文件中的数据,存储格式如下:
代码块
Python
-0.017612 14.053064 0
-1.395634 4.662541 1
-0.752157 6.538620 0
-1.322371 7.152853 0
0.423363 11.054677 0
绘制在图中,如下图所示:
准备数据: 由于需要进行距离计算,因此要求数据类型为数值型。另外,结构化数据格式则最佳
代码块
Python
# 解析数据
def loadDataSet(file_name):
'''
Desc:
加载并解析数据
Args:
file_name -- 要解析的文件路径
Returns:
dataMat -- 原始数据的特征
labelMat -- 原始数据的标签,也就是每条样本对应的类别。即目标向量
'''
# dataMat为原始数据, labelMat为原始数据的标签
dataMat = []
分析数据: 采用任意方法对数据进行分析,此处不需要
训练算法: 使用梯度上升找到最佳参数
定义sigmoid阶跃函数
代码块
Python
# sigmoid阶跃函数
def sigmoid(inX):
# return 1.0 / (1 + exp(-inX))
Logistic 回归梯度上升优化算法
代码块
Python
# 正常的处理方案
# 两个参数: 第一个参数==> dataMatIn 是一个2维NumPy数组,每列分别代表每个不同的特征,每行则代表每个训练样本。
# 第二个参数==> classLabels 是类别标签,它是一个 1*100 的行向量。为了便于矩阵计算,需要将该行向量转换为列向量,做法是将原向量转置,再将它赋值给labelMat。
def gradAscent(dataMatIn, classLabels):
# 转化为矩阵[[1,1,2],[1,1,2]....]
dataMatrix = mat(dataMatIn) # 转换为 NumPy 矩阵
# 转化为矩阵[[0,1,0,1,0,1.....]],并转制[[0],[1],[0].....]
# transpose() 行列转置函数
# 将行向量转化为列向量 => 矩阵的转置
labelMat = mat(classLabels).transpose() # 首先将数组转换为 NumPy 矩阵,然后再将行向量转置为列向量
# m->数据量,样本数 n->特征数
m,n = shape(dataMatrix)
# print m, n, '__'*10, shape(dataMatrix.transpose()), '__'*100
# alpha代表向目标移动的步长
大家看到这儿可能会有一些疑惑,就是,我们在迭代中更新我们的回归系数,后边的部分是怎么计算出来的?
•
为什么会是 alpha * dataMatrix.transpose() * error ?
因为这就是我们所求的梯度,也就是对 f(w) 对 w 求一阶导数。具体推导如下:
可参考http://blog.csdn.net/achuo/article/details/51160101;画出数据集和 Logistic 回归最佳拟合直线的函数
代码块
Python
def plotBestFit(dataArr, labelMat, weights):
'''
Desc:
将我们得到的数据可视化展示出来
Args:
dataArr:样本数据的特征
labelMat:样本数据的类别标签,即目标变量
weights:回归系数
Returns:
None
'''
测试算法: 使用 Logistic 回归进行分类
代码块
Python
使用算法: 对简单数据集中数据进行分类
注意
梯度上升算法在每次更新回归系数时都需要遍历整个数据集,该方法在处理 100 个左右的数据集时尚可,但如果有数十亿样本和成千上万的特征,那么该方法的计算复杂度就太高了。一种改进方法是一次仅用一个样本点来更新回归系数,该方法称为 随机梯度上升算法。由于可以在新样本到来时对分类器进行增量式更新,因而随机梯度上升算法是一个在线学习(online learning)算法。与 “在线学习” 相对应,一次处理所有数据被称作是 “批处理” (batch) 。
随机梯度上升算法可以写成如下的伪代码:
代码块
Python
以下是随机梯度上升算法的实现代码:
代码块
Python
# 随机梯度上升
# 梯度上升优化算法在每次更新数据集时都需要遍历整个数据集,计算复杂都较高
# 随机梯度上升一次只用一个样本点来更新回归系数
def stocGradAscent0(dataMatrix, classLabels):
m,n = shape(dataMatrix)
alpha = 0.01
# n*1的矩阵
# 函数ones创建一个全1的数组
weights = ones(n) # 初始化长度为n的数组,元素全部为 1
for i in range(m):
# sum(dataMatrix[i]*weights)为了求 f(x)的值, f(x)=a1*x1+b2*x2+..+nn*xn,此处求出的 h 是一个具体的数值,而不是一个矩阵
可以看到,随机梯度上升算法与梯度上升算法在代码上很相似,但也有一些区别: 第一,后者的变量 h 和误差 error 都是向量,而前者则全是数值;第二,前者没有矩阵的转换过程,所有变量的数据类型都是 NumPy 数组
判断优化算法优劣的可靠方法是看它是否收敛,也就是说参数是否达到了稳定值,是否还会不断地变化?下图展示了随机梯度上升算法在 200 次迭代过程中回归系数的变化情况。其中的系数2,也就是 X2 只经过了 50 次迭代就达到了稳定值,但系数 1 和 0 则需要更多次的迭代
如下图所示:
针对这个问题,我们改进了之前的随机梯度上升算法,如下:
代码块
Python
# 随机梯度上升算法(随机化)
def stocGradAscent1(dataMatrix, classLabels, numIter=150):
m,n = shape(dataMatrix)
上面的改进版随机梯度上升算法,我们修改了两处代码:
第一处改进为 alpha 的值。alpha 在每次迭代的时候都会调整,这会缓解上面波动图的数据波动或者高频波动。另外,虽然 alpha 会随着迭代次数不断减少,但永远不会减小到 0,因为我们在计算公式中添加了一个常数项
第二处修改为 randIndex 更新,这里通过随机选取样本拉来更新回归系数。这种方法将减少周期性的波动。这种方法每次随机从列表中选出一个值,然后从列表中删掉该值(再进行下一次迭代)
程序运行之后能看到类似于下图的结果图
50%
50%
项目案例2: 从疝气病症预测病马的死亡率
代码块
Python
#!/usr/bin/python
项目概述
使用 Logistic 回归来预测患有疝病的马的存活问题。疝病是描述马胃肠痛的术语。然而,这种病不一定源自马的胃肠问题,其他问题也可能引发马疝病。这个数据集中包含了医院检测马疝病的一些指标,有的指标比较主观,有的指标难以测量,例如马的疼痛级别
开发流程
代码块
Python
收集数据: 给定数据文件
准备数据: 用 Python 解析文本文件并填充缺失值
分析数据: 可视化并观察数据
训练算法: 使用优化算法,找到最佳的系数
测试算法: 为了量化回归的效果,需要观察错误率。根据错误率决定是否回退到训练阶段,
通过改变迭代的次数和步长的参数来得到更好的回归系数
使用算法: 实现一个简单的命令行程序来收集马的症状并输出预测结果并非难事,
收集数据: 给定数据文件
病马的训练数据已经给出来了,如下形式存储在文本文件中:
代码块
Python
1.000000 1.000000 39.200000 88.000000 20.000000 0.000000 0.000000 4.000000 1.000000 3.000000 4.000000 2.000000 0.000000 0.000000 0.000000 4.000000 2.000000 50.000000 85.000000 2.000000 2.000000 0.000000
2.000000 1.000000 38.300000 40.000000 24.000000 1.000000 1.000000 3.000000 1.000000 3.000000 3.000000 1.000000 0.000000 0.000000 0.000000 1.000000 1.000000 33.000000 6.700000 0.000000 0.000000 1.000000
准备数据: 用 Python 解析文本文件并填充缺失值
处理数据中的缺失值
假设有100个样本和20个特征,这些数据都是机器收集回来的。若机器上的某个传感器损坏导致一个特征无效时该怎么办?此时是否要扔掉整个数据?这种情况下,另外19个特征怎么办? 它们是否还可以用?答案是肯定的。因为有时候数据相当昂贵,扔掉和重新获取都是不可取的,所以必须采用一些方法来解决这个问题
下面给出了一些可选的做法:
•
使用可用特征的均值来填补缺失值
•
使用特殊值来填补缺失值,如 -1
•
忽略有缺失值的样本
•
使用有相似样本的均值添补缺失值
•
使用另外的机器学习算法预测缺失值
现在,我们对下一节要用的数据集进行预处理,使其可以顺利地使用分类算法。在预处理需要做两件事:
•
所有的缺失值必须用一个实数值来替换,因为我们使用的 NumPy 数据类型不允许包含缺失值。我们这里选择实数 0 来替换所有缺失值,恰好能适用于 Logistic 回归。这样做的直觉在于,我们需要的是一个在更新时不会影响系数的值。回归系数的更新公式如下:
•
weights = weights + alpha * error * dataMatrix[dataIndex[randIndex]]
•
如果 dataMatrix 的某个特征对应值为 0,那么该特征的系数将不做更新,即:
•
weights = weights
•
另外,由于 Sigmoid(0) = 0.5 ,即它对结果的预测不具有任何倾向性,因此我们上述做法也不会对误差造成任何影响。基于上述原因,将缺失值用 0 代替既可以保留现有数据,也不需要对优化算法进行修改。此外,该数据集中的特征取值一般不为 0,因此在某种意义上说它也满足 “特殊值” 这个要求
•
如果在测试数据集中发现了一条数据的类别标签已经缺失,那么我们的简单做法是将该条数据丢弃。这是因为类别标签与特征不同,很难确定采用某个合适的值来替换。采用 Logistic 回归进行分类时这种做法是合理的,而如果采用类似 kNN 的方法,则保留该条数据显得更加合理
原始的数据集经过预处理后,保存成两个文件: horseColicTest.txt 和 horseColicTraining.txt
分析数据: 可视化并观察数据
将数据使用 MatPlotlib 打印出来,观察数据是否是我们想要的格式
训练算法: 使用优化算法,找到最佳的系数
下面给出 原始的梯度上升算法,随机梯度上升算法,改进版随机梯度上升算法 的代码:
代码块
Python
# 正常的处理方案
# 两个参数: 第一个参数==> dataMatIn 是一个2维NumPy数组,每列分别代表每个不同的特征,每行则代表每个训练样本。
# 第二个参数==> classLabels 是类别标签,它是一个 1*100 的行向量。为了便于矩阵计算,需要将该行向量转换为列向量,做法是将原向量转置,再将它赋值给labelMat。
def gradAscent(dataMatIn, classLabels):
# 转化为矩阵[[1,1,2],[1,1,2]....]
dataMatrix = mat(dataMatIn) # 转换为 NumPy 矩阵
测试算法: 为了量化回归的效果,需要观察错误率。根据错误率决定是否回退到训练阶段,通过改变迭代的次数和步长的参数来得到更好的回归系数
Logistic 回归分类函数
代码块
Python
# 分类函数,根据回归系数和特征向量来计算 Sigmoid的值
def classifyVector(inX, weights):
'''
Desc:
使用算法: 实现一个简单的命令行程序来收集马的症状并输出预测结果并非难事,这可以作为留给大家的一道习题
额外内容(可选读)
在上文中,当Sigmoid函数大于 0.5 的数据被分入 1 类,小于 0.5 即被归入 0 类。其实0.5也是可以改动的。 比如大于 0.9 的数据被分入 1 类,小于 0.9 即被归入 0 类
Logistic回归 和 最大熵模型
Logistic回归和最大熵模型 都属于对数线性模型 (log linear model)。 当类标签(class label)只有两个的时候,最大熵模型就是 logistic 回归模型。 学习它们的模型一般采用极大似然估计或者正则化的极大似然估计。Logistic 回归和最大熵模型学习可以形式化为无约束最优化问题。
其他算法
除了梯度下降,随机梯度下降,还有Conjugate Gradient,BFGS,L-BFGS,他们不需要指定alpha值(步长),而且比梯度下降更快,在现实中应用的也比较多。 当然这些算法相比随机梯度要复杂
综上这些算法都有一个共通的缺点就是他们都是不断去逼近真实值,永远只是一个真实值的近似值而已
多标签分类
逻辑回归也可以用作于多标签分类。思路如下:
假设我们标签A中有a0,a1,a2....an个标签,对于每个标签 ai (ai 是标签A之一),我们训练一个逻辑回归分类器
即,训练该标签的逻辑回归分类器的时候,将ai看作一类标签,非ai的所有标签看作一类标签。那么相当于整个数据集里面只有两类标签: Ai 和其他
剩下步骤就跟我们训练正常的逻辑回归分类器一样了
测试数据的时候,将查询点套用在每个逻辑回归分类器中的Sigmoid 函数,取值最高的对应标签为查询点的标签