AI Agent 架构:拆解智能体的九大核心模块
本文基于经典 AI Agent 架构清单,拆解九大核心模块,帮你从产品视角理解智能体的底层逻辑,无论是做 RAG 知识库、单 Agent 任务编排还是多 Agent 协作,这套框架都可以作为设计与评估的基准。
随着大模型应用从简单对话走向自主执行任务,AI Agent(人工智能智能体)已经成为 AI 产品落地的核心方向。很多人以为 Agent 只是一个会调用工具的大模型,实际上,一个能够稳定完成复杂业务任务的智能体,是一套由多个组件组合而成的完整系统。
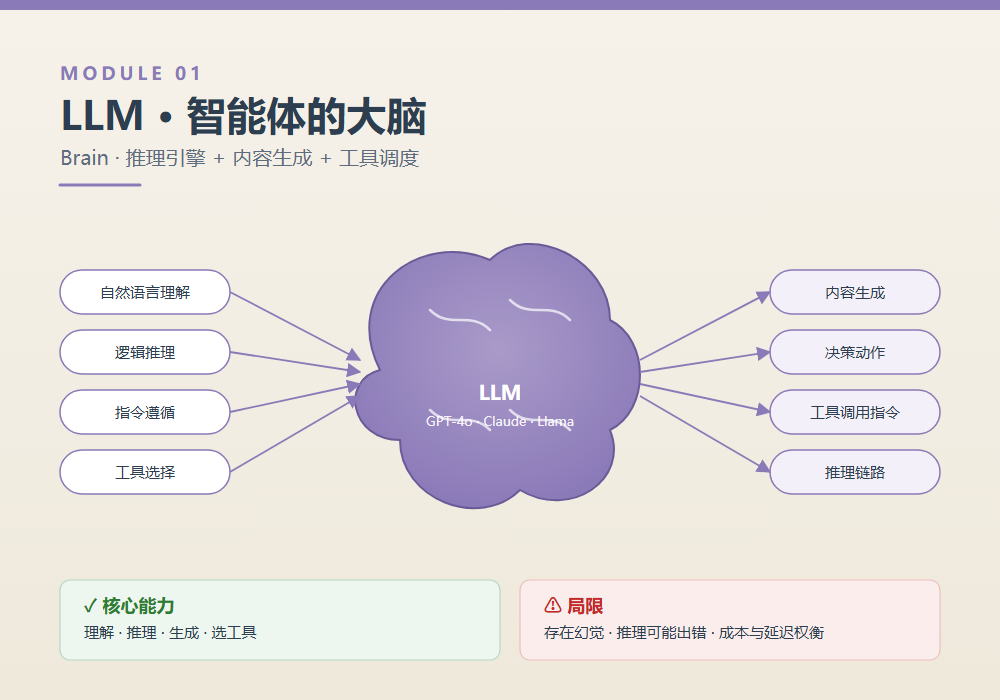
LLM:智能体的大脑(Brain)
大语言模型是 Agent 的推理引擎,负责理解指令、逻辑思考,并生成回复或动作指令。常见选型包括 GPT-4o、Claude、Llama 等大模型。
•
✅ 核心能力:理解自然语言、逻辑推理、内容生成、遵循指令并选择调用工具
•
⚠️ 局限:存在幻觉,推理过程中会产生错误判断
•
适用场景:产品需要自然语言理解、逻辑推理、内容生成能力时,LLM 是基础底座。
产品视角提示:LLM 决定了 Agent 的思考上限。模型越强,复杂任务拆解、工具选择的准确率越高;但同时推理成本、延迟也会上升,需要做成本与效果的权衡。
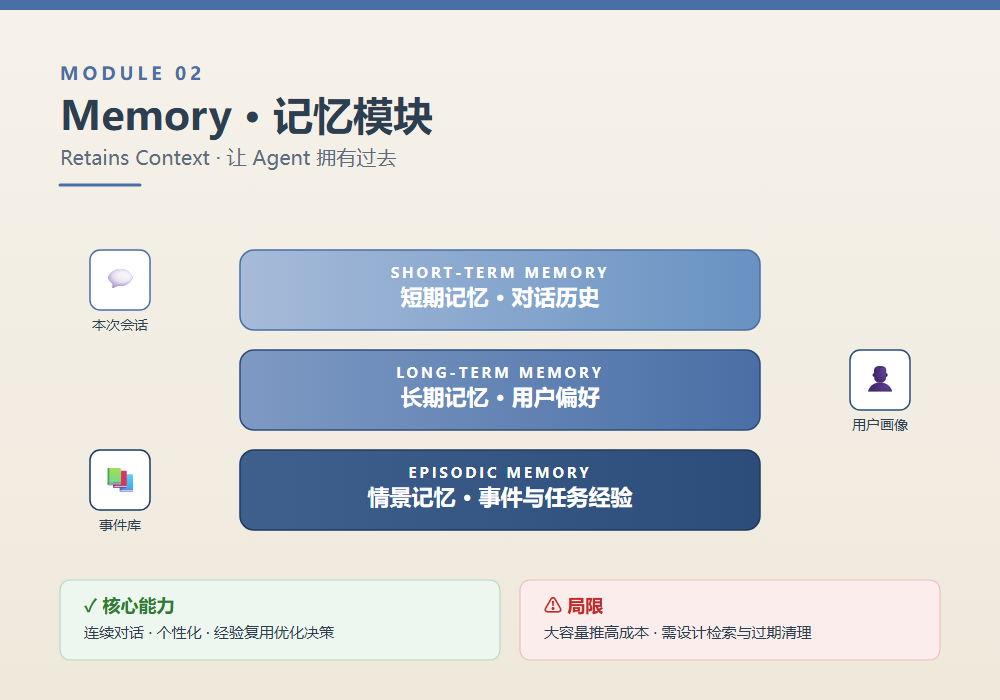
Memory:记忆模块,留存上下文(Retains Context)
记忆模块负责存储信息,让智能体能够记住过往信息并在后续任务中复用,分为三类:
•
短期记忆:对话历史,保存当前会话的上下文;
•
长期记忆:用户偏好、历史交互记录;
•
情景记忆:事件、过往任务经验。
•
✅ 核心能力:保证对话连续性,实现个性化交互,依托过往信息优化决策
•
⚠️ 局限:大容量记忆会带来额外成本
•
适用场景:智能体需要记住聊天记录、用户信息、历史事件,比如长期客户服务 Agent、个人助理。
产品视角提示:记忆不是无脑全量存储。AI 产品需要设计记忆检索策略、记忆过期清理机制,避免上下文窗口膨胀,拉高模型开销。
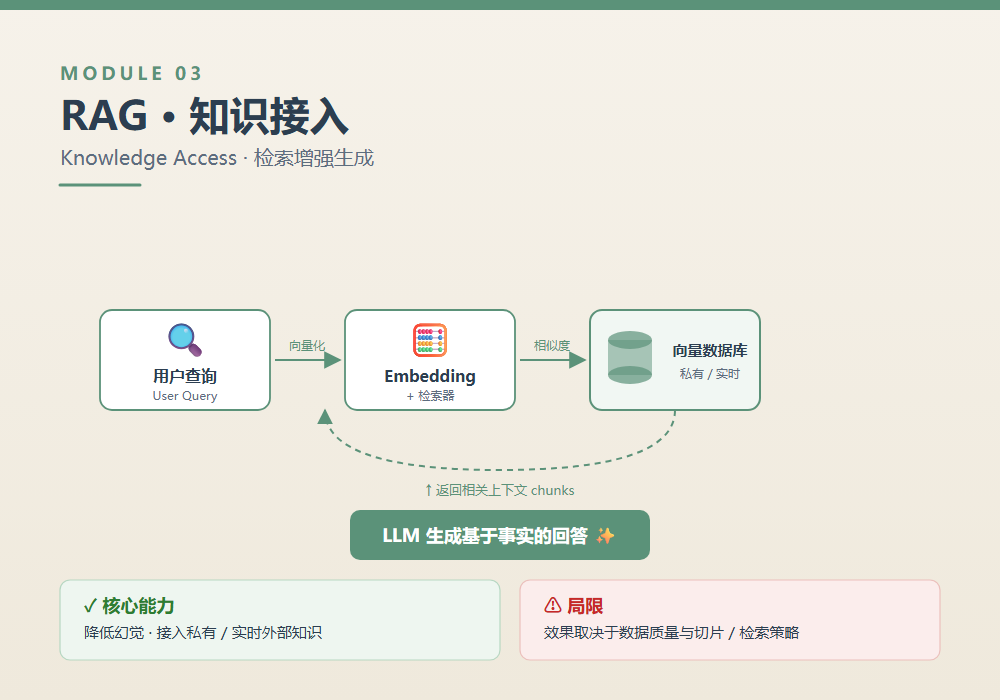
RAG:知识接入模块(Knowledge Access)
检索增强生成(RAG)负责检索最新、领域专属的外部知识,用来给大模型的回答提供事实依据。 工作流程:用户查询 → Embedding 向量化 + 检索器 → 查询向量数据库 → 返回相关上下文给大模型。
•
✅ 核心能力:显著降低大模型幻觉,可以接入私有、实时更新的外部资料
•
⚠️ 局限:最终效果高度依赖原始数据质量
•
适用场景:Agent 需要读取外部文档、私有知识库、实时业务数据。
产品视角提示:RAG 是企业 AI Agent 最常用模块。知识库的切片策略、检索召回规则,直接决定答案是否准确,是产品需求设计的重点。
Tools:动作执行器(Action Executor)
工具模块,让 Agent 能够和真实世界、外部系统交互。工具包含网页搜索、计算器、数据库查询、API 服务、邮件消息等。
•
✅ 核心能力:突破大模型本身知识局限,让 Agent 具备实操能力,让产品真正落地可用
•
⚠️ 局限:工具调用可能失败,返回错误结果
•
适用场景:智能体需要执行动作、拉取实时业务数据,例如查询订单、生成报表、联网搜索资料。
产品视角提示:工具定义、入参校验、异常重试策略,是 Agent 工程落地高频踩坑点,PRD 里必须明确工具的边界和失败兜底方案。
Planning:任务规划(Decide Steps)
规划模块负责把宏大复杂目标,拆解成一系列小型、可执行的步骤。 标准流程:理解目标 → 拆解步骤 → 确定下一步动作 → 执行并观察结果 → 循环直到任务完成。
•
✅ 核心能力:处理多步骤复杂任务,提升任务完成成功率
•
⚠️ 局限:过度规划会拖慢整体响应速度
•
适用场景:目标复杂,需要多轮思考 + 多次调用工具的场景,比如市场调研、代码开发、方案撰写。
Reflection:自省与迭代优化(Self-Improve)
自省模块,是 Agent 的自我纠错能力。Agent 评估执行结果、定位错误,并且优化后续决策。 流程:观察结果 → 评估效果 → 识别问题 → 优化重试。
•
✅ 核心能力:随着执行次数提升准确率,能够从错误中恢复
•
⚠️ 局限:多次自省将增加 token 消耗,提升成本
•
适用场景:任务结果准确度要求高,允许多次迭代优化。
产品视角提示:自省非常适合高准确率需求场景,但要设置最大重试次数,防止 Agent 无限循环、持续消耗 token。
Multi-Agent:多智能体协作(Collaboration)
多智能体系统,多个具备不同角色的 Agent 协同工作,每个智能体承担专门任务。常见架构:管理 Agent(编排器)统筹,搭配研究 Agent、代码 Agent、测试 QA Agent,共享记忆与知识库。
•
✅ 核心能力:处理大规模复杂问题,任务并行执行,提升整体效率
•
⚠️ 局限:架构设计、调试难度更高
•
适用场景:任务覆盖面广,适合拆分成多个专业化角色,比如软件研发、复杂项目分析。
产品视角提示:多 Agent 不要盲目上。简单业务场景,单 Agent 就足够;只有任务足够庞大、可以明确拆分专业角色时,多智能体才有收益。
Monitoring & Guardrails:监控与安全护栏
护栏模块保障 Agent 输出安全、可靠,行为符合预设规则。包含输入校验、输出过滤、安全检查、限流、日志与审计。
•
✅ 核心能力:阻止有害、不安全输出,保障合规性与稳定性
•
⚠️ 局限:过于严苛的规则会误拦截有效、正常的输出
•
适用场景:安全、合规、可靠性为第一优先级的业务。
产品视角提示:护栏不是简单的敏感词过滤,需要同时兼顾输入侧和输出侧。金融、政务等业务,审计日志是硬性要求。
Human-in-the-Loop:人在回路(HITL)
人在回路机制:人类可以审阅、指导、审批 Agent 的关键决策。流程:Agent 输出推荐结果 → 人工审阅 → 批准 / 编辑 / 驳回 → 继续执行任务。
•
✅ 核心能力:大幅提升结果准确性,建立业务信任
•
⚠️ 局限:执行速度变慢,需要投入人力
•
适用场景:决策关键、敏感、高风险场景,例如合同审核、医疗辅助、大额业务审批。
产品视角提示:HITL 是高风险 AI 产品的安全兜底。产品要区分哪些环节自动执行,哪些必须人工审核,做好人机分工。