10个Agent可标注评测类型:以火车票案例讲解
写在最前
01
PART
意图识别
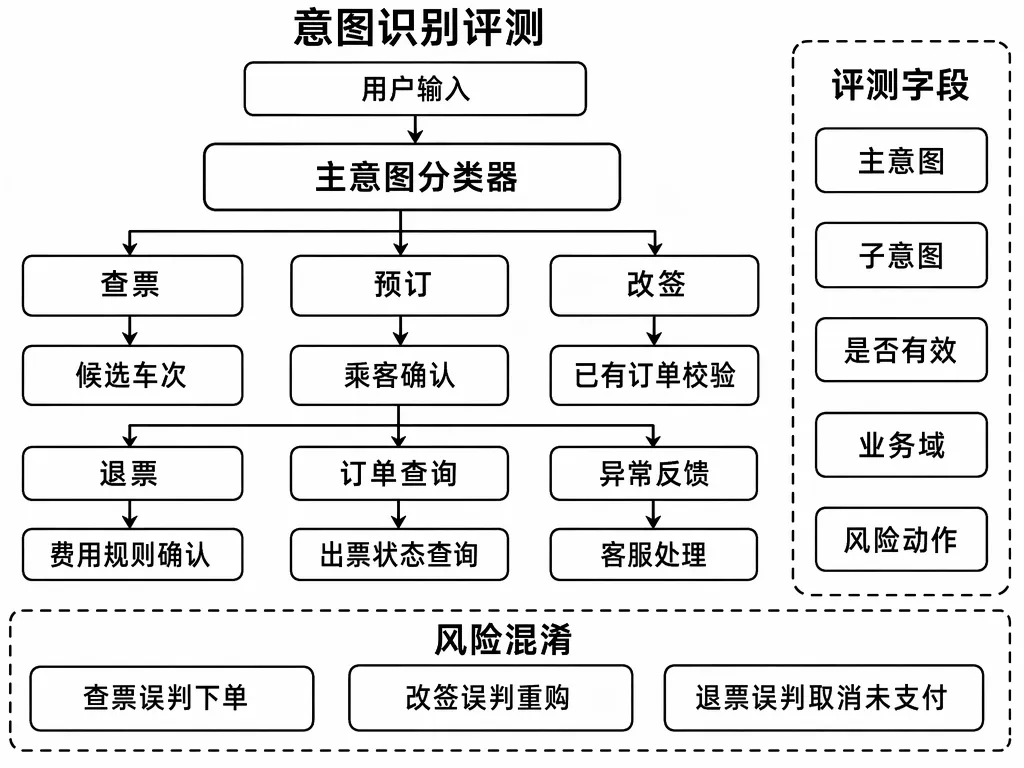
意图识别评测测的是主任务分类。
订票场景里,主意图至少不能只写一个订票。
同样是火车票相关输入,用户可能在做完全不同的事。
•
用户输入,明天下午杭州到上海还有票吗 → 查票
•
用户输入,选 G7315 二等座,给张三买一张 → 预订
•
用户输入,明天那张去上海的票改到晚上 → 改签
•
用户输入,把后天北京南到济南西那张退了 → 退票
•
用户输入,查一下订单有没有出票成功 → 订单查询
•
用户输入,这趟车晚点导致赶不上会议 → 异常反馈或客服投诉
这些任务如果都塞进订票大类,后续动作会完全混乱。查票不需要乘客身份,预订需要。改签依赖已有订单,退票涉及费用规则,投诉则进入客服或补偿流程。
意图识别评测的样本对象通常是单轮用户输入。
标准标注字段至少包括主意图、子意图、是否有效、业务域、风险动作。
判分方式可以用分类准确率和宏平均 F1。样本量不大时,老王更建议看混淆矩阵。
订票场景最要命的混淆不是查票和推荐混了,而是查票和下单混了,改签和重新购票混了,退票和取消未支付订单混了。
查票被误判成下单,会让系统提前进入乘客和支付流程。
改签被误判成重新购票,会造成用户持有两张票。
退票被误判成取消未支付订单,会漏掉手续费和确认风险。
所以意图识别不是越多标签越专业。标签的边界必须对应后续动作差异。
老王会把订票意图树拆到可执行层,而不是停在业务名词层。一个标签如果不能决定下一步动作,它就还不是产品可用标签。
02
PART
多意图拆分
多意图拆分评测测的是一句话里有多个任务时,Agent 能不能拆全,并保留合理顺序。
订票用户很少只说一件事。
用户输入,查一下明天下午杭州到上海的高铁,顺便看周日晚上上海回杭州还有没有票,去程优先二等座,返程能晚点。
这句话里至少有两个查询任务。
去程查票,杭州到上海,明天下午,高铁,二等座优先。
返程查票,上海到杭州,周日晚上,时间偏晚。
用户输入,查明天下午杭州到上海的票,有合适的就给张三预订一张二等座。
这不是两个并列任务,而是有依赖关系。
必须先查票,再根据候选车次进入预订。没有候选车次,就不能进入下单。
用户输入,把明天去上海那张改到晚上,如果没有合适车次就退掉。
这里又是条件分支。先查原订单,再查可改签车次。若有合适车次,走改签。若没有合适车次,再进入退票候选流程。退票还必须确认。
多意图拆分评测的标注字段包括子意图列表、任务顺序、依赖关系、条件分支、是否需要确认。
判分不能只看最终回答看起来有没有覆盖。要拆成三个指标。
子任务召回率,应该拆出的任务有没有漏。
冗余率,系统有没有补出用户没有表达的任务。
顺序准确率,有依赖关系的任务有没有排错。
订票场景里,多意图漏拆会直接导致用户少买返程、误改订单、漏掉退票确认。
过度拆分也有成本。用户只是问明天去上海几点有车,系统却拆出查票、订票、支付、出票四个任务,就是把查询误推进到交易。
老王看多意图拆分,会优先看动作边界。查票可以自动,预订要确认乘客,支付必须确认。拆分不是为了让流程变长,而是为了让每个动作的边界清楚。
03
PART
隐含意图
隐含意图评测测的是用户没有直接说目标时,Agent 能不能从业务语境里补出真实目标。
订火车票时,用户经常不说查票或订票。
用户输入,明天下午三点前能到上海虹桥吗。
表层看是一个能不能的问题。真实目标通常是查找到达时间早于三点的车次。
用户输入,别耽误四点的会。
这不是闲聊,背后是到达时间约束。系统应该把它转成到站时间需要早于会议时间,并预留出站和通勤缓冲。
用户输入,这趟太晚了。
如果当前页面已经展示了候选车次,这句话的隐含意图是调整筛选条件,换更早到达或更早出发的车次。
用户输入,还有便宜点的吗。
在车次候选列表里,它通常不是普通价格咨询,而是按票价重新排序,或者放宽席别和车次类型。
隐含意图不能靠模型自由发挥。它必须来自三个来源。
当前业务页面,比如正在看车次列表、订单确认页、改签页。
当前对话状态,比如前面已经确定杭州到上海。
订票业务规则,比如会议时间会影响到达时间窗口。
这类评测的标注字段包括表层表达、隐含意图、业务目标、触发依据、是否需要澄清。
判分不要只看模型输出像不像。要看隐含目标是否被标注员认可,以及后续动作是否落在这个目标上。
隐含意图的边界
这里最容易犯的错,是把所有模糊表达都自动扩展成执行动作。
用户说太贵了,可能是想换低价车次,也可能只是表达不满意。当前如果还在查询列表,可以继续筛选。当前如果已经进入支付页,系统就不能直接替用户改票。
老王更倾向于把隐含意图和澄清判断一起看。隐含意图能补出方向,但一旦涉及车次替换、乘客、支付和退票,就要进入确认机制。
04
PART
意图拒识
意图拒识评测测的是 Agent 知不知道哪些输入不能继续执行。
订票场景不是所有请求都能接。
•
用户输入,买一张不用身份证核验的票 → 越界或不合规请求
•
用户输入,订一张昨天去上海的票 → 无效请求
•
用户输入,订一张下个月三十五号的票 → 日期无效
•
用户输入,给没有实名信息的乘客出票 → 信息不满足和规则不支持
•
用户输入,帮用户抢一张内部预留票 → 如果系统没有这个合法能力,就应该拒识或转人工说明边界
拒识不是简单回复不能做。
在评测集里,拒识要标出原因。原因不同,后续产品动作不同。
无效输入,提示用户重新输入。
不清楚,进入澄清。
不支持,说明能力边界。
越界,拒绝执行。
高风险,进入确认或人工流程。
判分方式要同时看拒识准确率、误拒率和漏判率。
误拒会伤害体验。用户说订明天下午杭州东到上海虹桥的票,系统却误判成缺信息太多,就是误拒。
漏判会带来风险。用户要求绕过实名核验,系统还继续查票,就是漏判。
订票场景里,拒识评测比普通问答更重要。因为它守住的是交易规则、实名规则和支付边界。
老王不建议把拒识写成兜底话术。拒识是可标注标签,标签背后要能定位到能力边界、规则边界或风险边界。
05
PART
澄清判断
澄清判断评测测的是 Agent 什么时候该追问,追问什么字段。
订票场景里,用户输入经常不完整。
用户输入,订明天去上海的票。
这句话缺很多东西。出发城市不一定知道,出发站不一定知道,时间窗口不明确,乘客不明确,席别不明确。
但并不是所有缺口都要问。
如果当前定位在杭州,历史常用出发站是杭州东,系统可以把出发城市和出发站作为默认候选。用户没有说席别,可以默认先查二等座和无座,或者在候选列表里展示。用户没有说乘客,进入下单前必须确认。
用户输入,今晚到北京,越早越好。
这里的关键澄清点不是席别,而是出发城市。如果系统无法从上下文确定出发地,必须问。若已经知道用户在上海,系统可以直接查上海到北京今晚的车次。
用户输入,给张三买一张明天去上海的票。
如果系统里有多个张三,必须追问乘客。这个缺口不解决,后面会直接下错订单。
澄清判断评测的标注字段包括是否需要澄清、缺失字段、可默认字段、必须确认字段、建议追问问题。
判分方式可以看澄清必要性准确率和追问字段命中率。
这一层最难的是区分三类缺口。
不影响查票的缺口,可以默认或延后。
会改变候选结果的缺口,需要追问。
涉及交易和身份的缺口,必须确认。
订票 Agent 不能把所有缺口都一次性抛给用户。那不是智能,是把用户拖回传统表单。
也不能什么都默认。乘客、日期、到站、支付,这些不能靠猜。
老王看澄清策略,重点看它有没有降低任务成本。好的澄清不是问题少,而是只问当前阶段必须问的问题。
06
PART
输入鲁棒性
输入鲁棒性评测测的是用户输入不标准时,Agent 还能不能识别出同一个标准意图。
真实订票输入不会像表单字段一样整齐。
用户可能说,明儿下午杭洲到上海红桥有高铁没。
这里有口语表达、错别字和站名错误。标准化以后应该接近,明天下午杭州到上海虹桥查高铁票。
用户可能说,订后天回北京那趟,别太早,二等就行。
这句话省略了出发地,依赖上下文。若上一轮已经确定用户在上海,系统可以识别为查后天上海到北京二等座车次。
用户可能语音转写成,杭州东到上海红桥,三点有坐吗。
红桥要归到上海虹桥,三点有坐要理解为三点左右是否有座位。
鲁棒性评测不是让模型容忍所有混乱输入。它测的是在可恢复的噪声范围内,标准意图是否还能稳定命中。
标注字段通常包括原始输入、标准改写、标准意图、噪声类型、需要依赖的上下文。
判分方式可以看鲁棒意图准确率,也可以按噪声类型拆分。
错别字样本、站名别称样本、省略样本、语音转写样本,要分开看。
订票场景里,鲁棒性还要特别看站点容错。上海、上海站、上海虹桥、上海南不是一个东西。可以纠错,但不能乱归一。
老王建议产品经理单独收集真实线上口语样本。人工构造的脏数据太整齐,测不出真实用户输入里的省略、转写和站点混用。
07
PART
实体识别
实体识别评测测的是 Agent 能不能从输入中圈出关键业务对象。
订票场景里的实体非常具体。
用户输入,明天下午三点左右从杭州东到上海虹桥,两个人,二等座,尽量别超过二百。
里面至少有这些实体。
时间实体,明天下午三点左右。
出发站实体,杭州东。
到达站实体,上海虹桥。
人数实体,两个人。
席别实体,二等座。
价格约束实体,别超过二百。
如果用户输入,G7315 还有二等座吗,还要识别车次实体。
如果用户输入,给张三和李四买,还要识别乘客实体。
实体识别的标注字段通常包括实体类型、实体文本、起止边界。
判分方式看精确率、召回率和 F1。
订票场景里,边界很关键。
明天下午三点左右是一个时间窗口,不是明天和下午三点两个互不相关的实体。
上海虹桥是一个到达站,不是城市上海加普通名词虹桥。
别超过二百是价格上限,不是普通描述。
老王不建议只标实体文本。没有实体类型和边界,后续错误很难定位。模型漏掉两个人和模型把两个人识别成乘客姓名,是两种完全不同的问题。
08
PART
实体归一
实体归一化评测测的是 Agent 能不能把用户的自然表达转成系统可用的标准值。
订票系统不能直接拿明天、下午三点左右、上海虹桥附近、杭州东这些自然表达去执行。
它需要标准日期、标准时间窗口、标准车站、标准城市、标准乘客、标准席别。
当前日期是 2026 年 4 月 23 日。
用户说明天,标准日期应该是 2026 年 4 月 24 日。
用户说明天下午,标准时间窗口可以标成 12 点到 18 点。
用户说下午三点左右,标准时间窗口可以标成 14 点到 16 点,具体窗口宽度由产品规则定义。
用户说上海虹桥,标准车站应该是上海虹桥站,而不是上海站。
用户说高铁,标准车次类型应该是高速动车或动车优先,具体字段要看票务系统能力。
归一化评测的标注字段包括原始表达、标准类型、标准值、解析依据、是否需要人工复核。
判分方式可以用字段准确率和精确匹配。日期、车站、车次、订单号适合精确匹配。时间窗口和价格范围可以用范围匹配。
实体归一化比实体识别更接近业务系统。
识别出上海虹桥只是第一步。真正执行时,系统要知道它是到达站,不是目的城市,也不是虹桥机场。
识别和归一要分开
老王看 Agent 评测,会把实体识别和实体归一分开。前者测有没有圈出来,后者测能不能进入系统执行。混在一起,错误归因会乱。
09
PART
词槽填充
词槽填充评测测的是完成一个任务所需参数是否被填完整、填正确。
实体是用户说出的业务对象,词槽是任务执行需要的字段。
订票意图下,词槽至少可以拆成这些字段。
出发城市或出发站。
到达城市或到达站。
出发日期。
出发时间窗口或到达时间窗口。
乘车人。
席别。
车次类型。
是否接受候补、无座、中转。
是否进入订单确认和支付。
用户输入,订明天下午三点左右杭州东到上海虹桥的二等座,两个人。
这句话已经填了出发站、到达站、日期、时间窗口、席别和人数。
但乘车人还没确定。两个人不是两个具体乘客。系统不能直接下单。
如果用户当前账号常用乘车人只有张三和李四,系统可以把这两个作为候选,但仍然需要确认。
词槽填充的标注字段一般包括槽位名称、槽位值、是否必填、来源、是否允许默认。
判分方式看槽位准确率和槽位完整率。
这里不要把槽位表写成数据库字段表。
数据库字段是存储结构。词槽是任务执行条件。
同一个字段在不同任务里重要性不同。查票时乘车人不是必填。下单时乘车人就是必填。支付时订单确认又变成高风险槽位。
老王建议每个高频意图都单独做槽位表。查票、预订、改签、退票、订单查询,不要共用一张万能槽位表。
10
PART
词槽缺失
词槽缺失评测测的是 Agent 能不能发现执行任务还缺哪些必要字段。
词槽填充关注已经抽到什么。
词槽缺失关注还缺什么。
用户输入,订明天去上海的票。
对于查票,这句话可能缺出发地和时间窗口。
对于下单,它还缺乘车人、席别、具体车次和订单确认。
同一句话,在不同执行阶段,缺失槽位不一样。
用户输入,给张三订明天三点到上海的票。
这句话看起来信息很多,但仍可能缺出发站。三点到上海也要判断是三点到达,还是三点左右出发。如果系统不能确定,就要标缺失或歧义。
缺失槽位标注字段一般包括必填槽位清单、已填槽位、缺失槽位、是否可默认、是否影响当前阶段执行。
判分方式重点看缺失槽位召回率。
因为漏掉一个关键缺失槽位,后面就会错误执行。
这里有一个反常识点。缺槽不是越少越好。
很多模型为了显得能干,会把缺失字段用猜测补齐。用户没有说出发城市,系统按当前定位默认可以,但必须标记为默认来源。用户没有说乘车人,系统不能替用户猜。
老王更看重系统能不能诚实识别缺口。该缺就标缺,该默认再默认,该确认就确认。
11
PART
词槽冲突
词槽冲突评测测的是用户输入里的条件互相打架时,Agent 能不能识别出来。
订票场景里,冲突非常常见。
用户输入,明天早上八点从北京到上海,九点前到。
出发时间和到达时间约束冲突。
用户输入,只坐高铁,没票就买普快。
车次类型约束冲突。它可能不是绝对冲突,而是优先级冲突,先高铁,后普快。
用户输入,二等座就行,但必须商务座候补。
席别约束冲突。
用户输入,下午三点出发,但四点前到广州。
业务事实可能不支持。
词槽冲突的标注字段通常包括冲突槽位、冲突原因、冲突类型、处理建议。
判分方式看冲突识别准确率,也要看误报率。不能因为条件多,就全部判冲突。
冲突分两类。
显性冲突,用户自己说了互相排斥的要求。
业务冲突,用户要求和票务事实冲突。
显性冲突可以在输入理解阶段发现。业务冲突通常要查票后才能确认。
比如明天下午杭州东到上海虹桥,二等座,三点左右出发,这不冲突。系统查不到票,只能说明当前票务供给不满足,不能说用户输入矛盾。
老王认为词槽冲突评测很适合接线上失败归因。很多 Agent 不是没理解用户,而是没发现用户要求无法同时满足。
12
PART
词槽追问
词槽追问评测测的是缺槽以后,Agent 有没有问对问题。
发现缺槽只是第一步。更关键的是追问哪个槽位,怎么问,问完能不能继续执行。
用户输入,订一张去上海的票。
系统可能缺出发地、日期、时间、乘客、席别。
它不应该一次性抛出五个问题。
更合理的追问要按执行阻塞程度排序。
如果当前定位和历史订单可以确定用户常从杭州出发,出发地可以作为默认候选。日期完全缺失时,要先问日期。用户只是查票时,乘客可以延后。进入下单时,乘客必须确认。
用户输入,明天下午到上海的票。
这里优先追问出发地,还是询问三点前到还是下午到达,要看上下文。如果当前页面已经在杭州出发场景里,出发地不必问。若没有上下文,出发地优先级更高。
词槽追问的标注字段包括应该追问的槽位、追问问题、追问优先级、可默认槽位。
判分方式看追问槽位命中率和追问优先级准确率。
产品经理常见误区,是把追问写成文案能力。其实追问首先是决策能力。
文案再客气,如果问错字段,用户仍然会觉得系统不懂业务。
订票 Agent 的好追问应该满足三个条件。
好追问的三个条件
当前阶段必须问。
用户回答后能推进下一步。
不提前索要支付、乘客等非当前阶段必要信息。
老王会把词槽追问单独建评测,是因为它直接决定 Agent 是高效补齐信息,还是把用户拖回传统订票表单。
13
PART
最后说下
这 12 个概念写完,不代表每个订票 Agent 都要一次性建满 12 个评测集。
如果团队刚开始做 Agent 意图识别评测,老王建议按这个顺序落地。
先建意图识别和实体识别,解决听没听懂、抽没抽到。
再建实体归一和词槽填充,解决能不能查票。
接着建词槽缺失和澄清判断,解决什么时候问。
再补词槽追问和词槽冲突,解决怎么问、怎么处理矛盾。
最后补多意图拆分、隐含意图、意图拒识和输入鲁棒性,解决复杂真实输入。
最小可用评测集不要追求漂亮分类。
它应该先覆盖最高频、最高风险、最高返工成本的订票输入。
老王最后给一个标准。
评测集成熟度的判断标准
如果你的评测样本只能标出用户想订票,它还只是意图分类。
如果它能同时标出查票还是下单、去程还是返程、隐含到达时间、拒识边界、缺失字段、标准车站、乘客槽位、席别冲突和追问优先级,它才开始接近可落地的 Agent 意图识别评测集。