打造Skill:将书和视频蒸馏为可执行 Skill
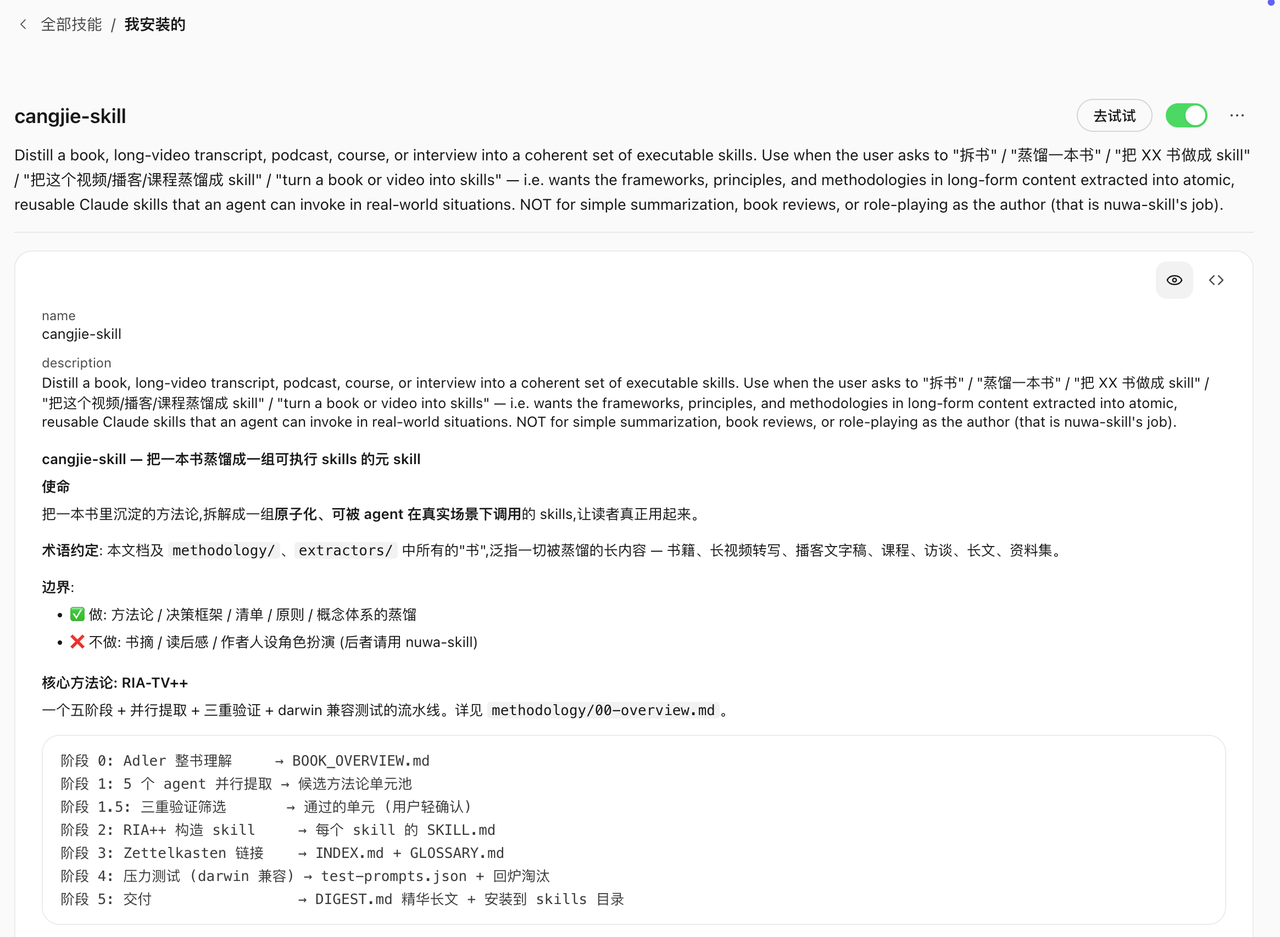
制作skill,除了把自己的SOP沉淀为skill外,给大家推荐一个更简单方便的办法。可以使用cangjie-skill把知识蒸馏成skill。
问题起点:知识读了但用不起来
AI 在训练时已经摄入了大量经典著作,但在实际问答中,它往往输出"正确的废话"——每个字都对,但缺乏针对特定问题的可落地步骤。这不是幻觉问题,而是调用机制问题:AI 知道书里有什么,但不知道该在什么场景下主动调出哪个框架。
50%
50%
人类读者面临同样的问题。读完一本书,笔记做了、金句划了,合上书以为升级了。两周后遇到真实问题,那些方法论却抓不住。知识在记忆里,但激活路径不清晰。
知识精馏要解决的,就是这个"学了用不上"的问题。
六阶段蒸馏 SOP
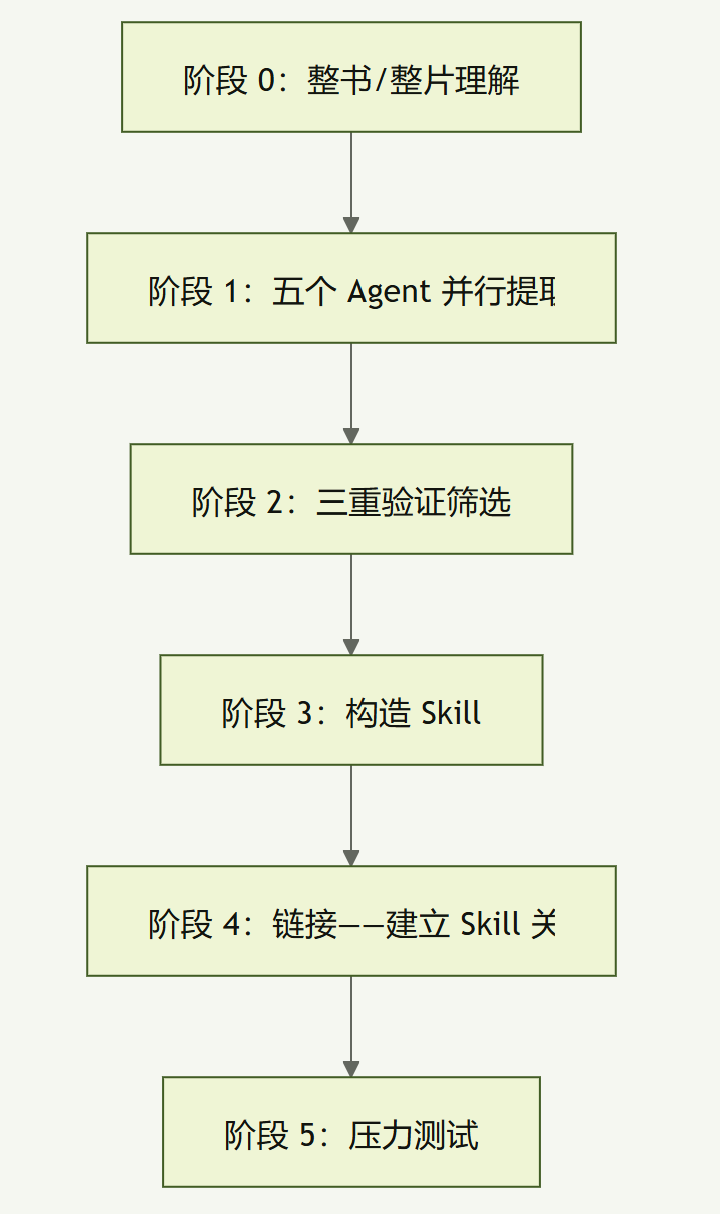
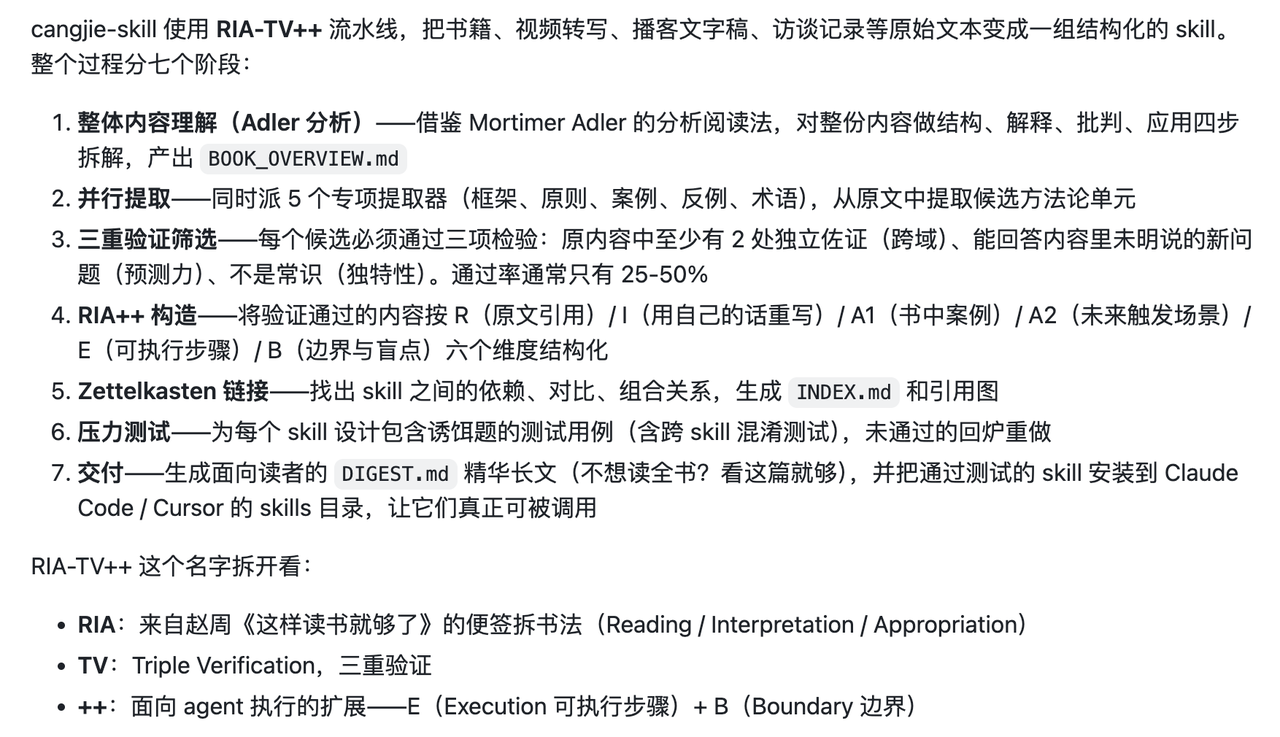
cangjie-skill 使用六个阶段将一本书或一组视频蒸馏成一套 Skill。
26%
74%
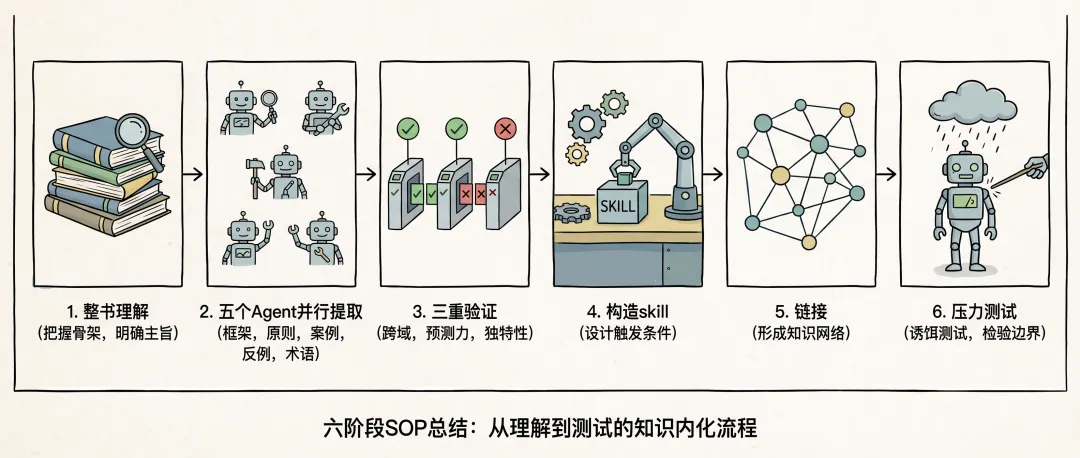
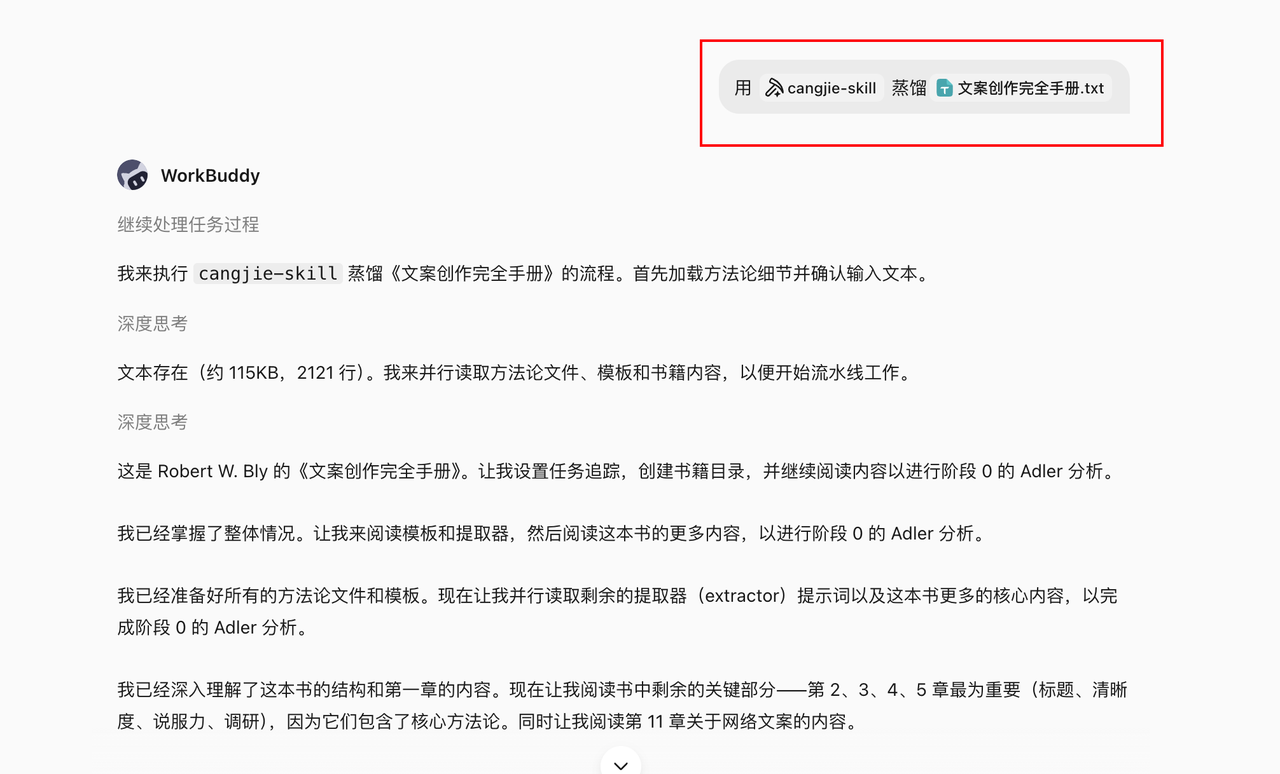
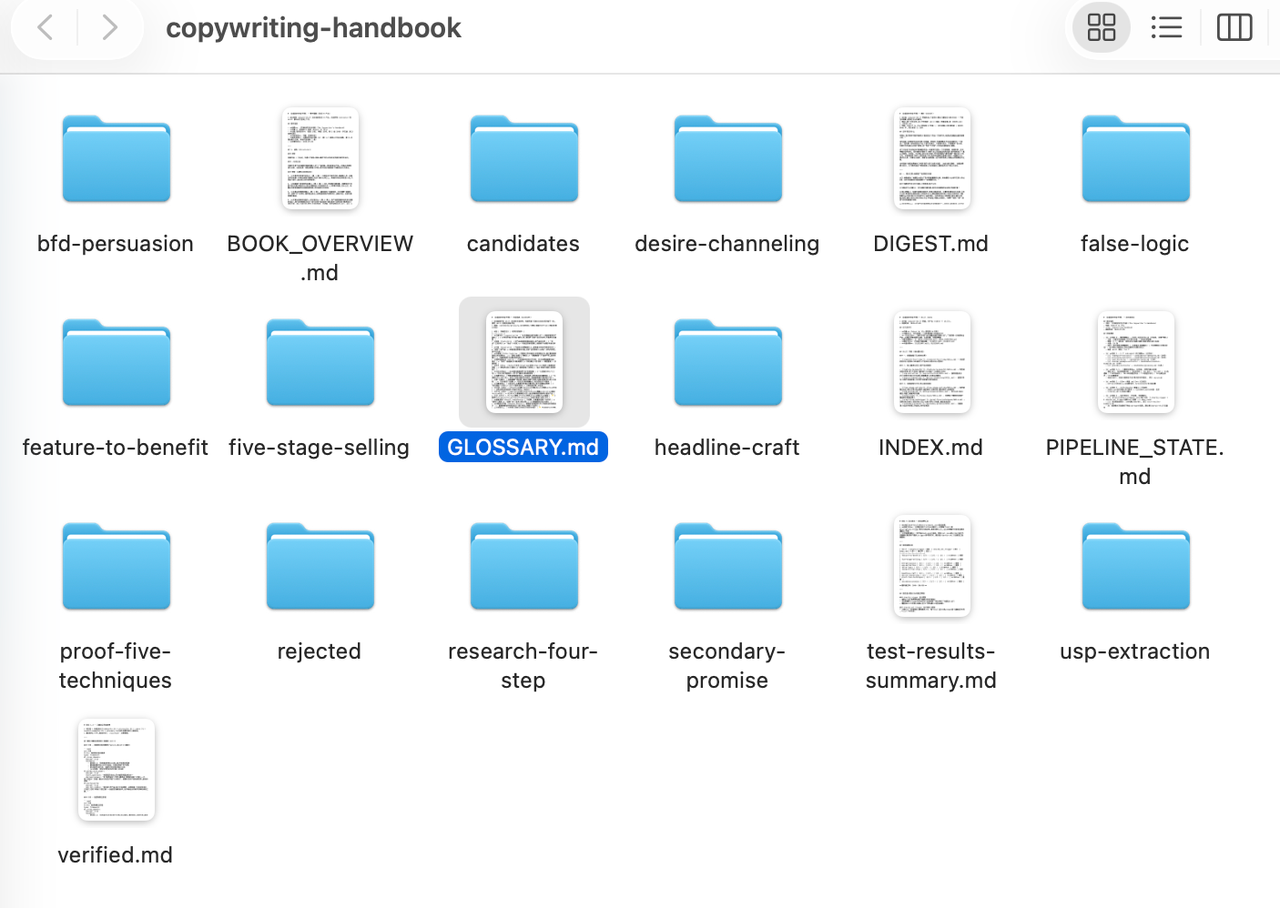
⭕
book-skill/
├── README.md # 书目信息、蒸馏说明、适用场景
├── skills/
│ ├── skill-01.md # 每个 Skill 独立文件
每个 Skill 文件包含:触发条件、执行步骤、输出格式、边界限制、测试用例。测试用例格式兼容 darwin-skill(自动 Skill 进化工具),蒸馏产物可以持续自动优化。
知识精馏 vs RAG
这是使用者最常问的问题。
RAG 解决"知识管理"问题——让你能查到书里有什么。知识精馏解决"知识运用"问题——让 Agent 在对的时刻主动拿出对的框架。
当你不知道该问什么时,RAG 帮不了你。Skill 不需要你记得书里有哪些方法论。
与 Karpathy LLM Wiki 思路的对比
Andrej Karpathy 提出 LLM 知识库(LLM Wiki)的思路:将原始资料索引到目录,让 LLM 编译成 Wiki,然后对 Wiki 做 Q&A,产出结果再回填,持续增强。
cangjie-skill 的阶段 0(整书理解)和阶段 1(并行提取)吸收了这一核心思想:先让 AI 深度阅读、结构化整理、建立索引、维护一致性。
两者的差别在于最后几步:
两种方案不互斥,但目标不同。
视频蒸馏工作流(v2 新增)
cangjie-skill v2 在书本蒸馏基础上增加了视频蒸馏能力(借助video-downloader skill)。视频与书的区别在于:需要先完成"视频 → 文字"的转换,再进入六阶段 SOP。
视频获取与转写
整体流程:
视频下载:使用 yt-dlp(开源工具)支持 YouTube、B 站等主流平台,只需输入视频链接即可自动下载。视频号因平台限制暂不支持自动化。
音频转写:本地 Whisper 模型可用,但长视频转写耗时显著(一小时视频约需 48 分钟本地转写)。推荐使用 ASR API 服务,速度快,适合批量处理。
多视频合并蒸馏
同一主题的多个视频可以合并蒸馏,产出统一的 Skill 集合。合并时 Agent 自动处理内容去重和知识单元合并,避免同一原则在不同视频中被重复提取为多个 Skill。
video-downloader skill 与 cangjie-skill 的分工
视频处理逻辑(下载、提取音频、转写)独立封装在 video-downloader skill 中,不集成到 cangjie-skill 内部。原因是职责分离:cangjie-skill 专注文本蒸馏,视频获取是前置准备步骤,两者可以独立演进。
适用与不适用场景
适合蒸馏的材料
表格加载中...
蒸馏的前置条件
蒸馏前最好读过或看过一遍原材料。原因:
•
需要判断哪些方法论是重点;
•
需要在蒸馏过程中的关键节点做判断(如三重验证的边界情况);
•
读过之后蒸馏,吸收率显著高于未读过直接蒸馏。
蒸馏不是替代阅读,而是阅读后的知识结构化工具。
蒸馏产物的持续优化
cangjie-skill 产出的每个 Skill 自带测试用例,格式兼容 darwin-skill(达尔文.Skill)。
darwin-skill 是自动 Skill 进化工具:将 Skill 喂给它,它会自动评估、改进、测试,且分数只升不降。
这意味着蒸馏产物不是静态的。随着 Agent 实际使用反馈的积累,Skill 可以持续自动优化,逐步接近书中方法论在真实场景下的最优表达。
资源消耗与模型选择
知识精馏是 Token 消耗密集型任务,主要来源于:
•
阶段 0 的全书上下文理解(长上下文);
•
阶段 1 的五个 Agent 并行调用;
•
阶段 2 的三重验证(多轮推理);
•
阶段 5 的压力测试(多组测试用例)。
模型选择建议:
•
任务拆解和蒸馏协调:使用推理能力强的模型负责 Agent 编排;
•
并行提取和验证:可使用性价比高的 Coding 模型执行;
•
长上下文场景:选择原生支持长上下文的模型,避免因上下文截断导致蒸馏不完整。
【图片占位:Token 消耗过程截图,展示蒸馏过程中 Token 使用量的增长曲线】
蒸馏产物的分享与复用
知识精馏的一个重要特点是:产物(Skill 集合)可以直接分享和复用。
使用已蒸馏的 Skill:将 GitHub 仓库地址提供给 Agent,让 Agent 自动安装对应 Skill 即可使用,无需重新蒸馏。
社区协作:同一本书不需要被每个人重复蒸馏。任何人蒸馏的成果都可以开源,其他人直接复用。
扩展应用:视频课程的蒸馏产物可以进一步构建课程 Agent,供学员问答和辅助实践,即课程内容的结构化知识服务化。
常见误区
误区 1:AI 训练过的书不需要再蒸馏
对于大众熟知的经典书籍,AI 确实有一定记忆。但对小众书籍、新出版书籍以及时效性强的视频内容,AI 大概率没有训练过。此外,即使 AI 训练过某本书,蒸馏的价值在于建立触发条件——让 AI 知道在什么场景下应该调出该书的哪个框架,而不只是"知道书里有什么"。
误区 2:蒸馏完就不需要看书了
蒸馏是阅读的补充,不是替代。没读过就蒸馏,会在关键判断节点上缺乏背景,导致蒸馏结果遗漏重点。阅读过一遍后再蒸馏,蒸馏产物的质量和完整度显著更高。
误区 3:AI 给了建议就能直接执行
即使 Skill 被正确激活并给出了可落地的步骤,方向对不对、能不能执行、效果好不好,仍然需要人来判断。AI 给出的是选项和分析,决策是人的责任。
误区 4:Skill 覆盖越多越好
覆盖太宽的触发条件会导致 Skill 在不适用的场景下被错误激活,反而产生误导。三重验证和诱饵测试的目的正是控制边界,宁可覆盖窄一点,也不要乱激活。
蒸馏结果示例
以吴恩达《给所有人的 AI 入门课》(2026 版,26 个视频,时长约 4 小时)为例:
•
蒸馏耗时:约 1 小时
•
产出:25 个 Skill
•
特点:全部为时效性内容,AI 未经训练,蒸馏后可直接在对应场景下被 Agent 调用