大模型5种主流参数高效微调技术
本文将深度拆解LoRA、LoRA-FA、VeRA、Delta-LoRA、LoRA+的原理、差异与选型指南
低秩适配的核心逻辑:所有变体的共同基础
随着大语言模型(LLM)参数规模从百亿级迈向万亿级,全参数微调的成本与门槛急剧攀升,参数高效微调(Parameter-Efficient Fine-Tuning, PEFT) 成为工业界落地的核心方案:冻结预训练基座的绝大部分权重,仅训练少量新增参数,即可让模型适配特定领域、任务风格与业务规则。
LoRA的核心假设来自一个关键发现:大语言模型在适配下游任务时,权重的更新量本质上具有低秩性——即权重变化矩阵可以被两个远小于原维度的小矩阵乘积近似拟合。
✍️
对于一个维度为的预训练权重矩阵,全量微调会更新整个矩阵的所有参数;而LoRA的做法是:
冻结原始权重,不参与梯度更新;
新增两个低秩矩阵和,其中秩(通常取8、16、64等);
训练时仅学习A、B的参数,用拟合权重更新量;
推理时将合并回原权重,得到有效权重,无任何额外计算开销。
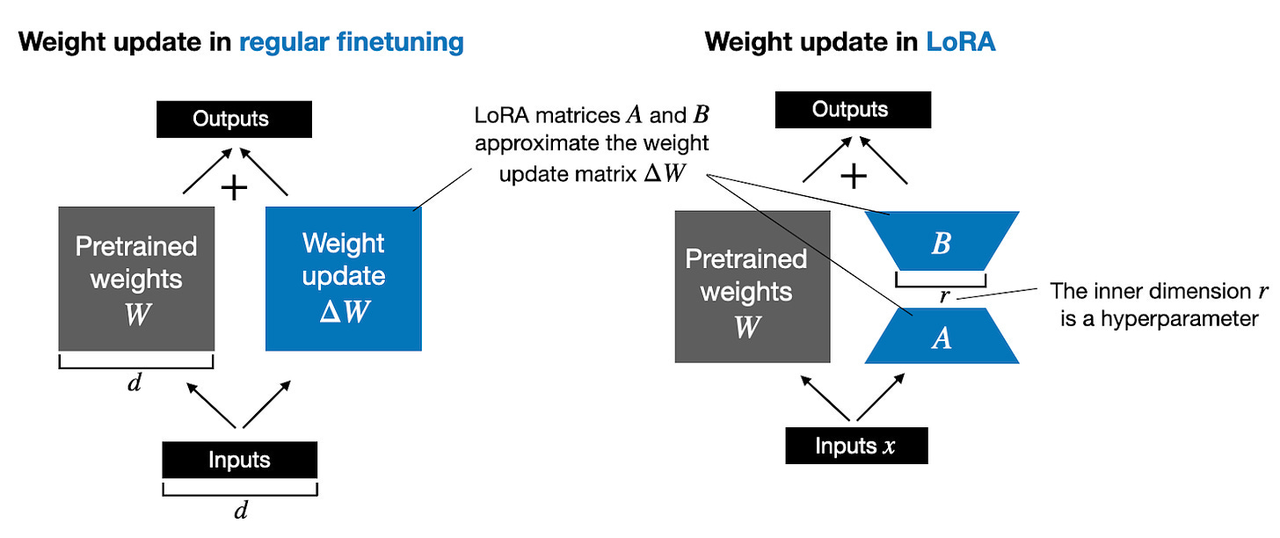
以7B模型的注意力层权重为例():
•
全量微调参数量:万
•
LoRA()参数量:万
参数量仅为全量微调的0.39%,却能达到接近全量微调的效果,这是LoRA体系得以广泛应用的根本。
五种微调技术深度拆解
1. LoRA:低秩适配的基准方案
✍️
LoRA是整个低秩微调体系的基石,由微软团队于2021年提出(Hu et al., 2021),后续所有变体均是在其结构基础上做的定向优化。
核心原理
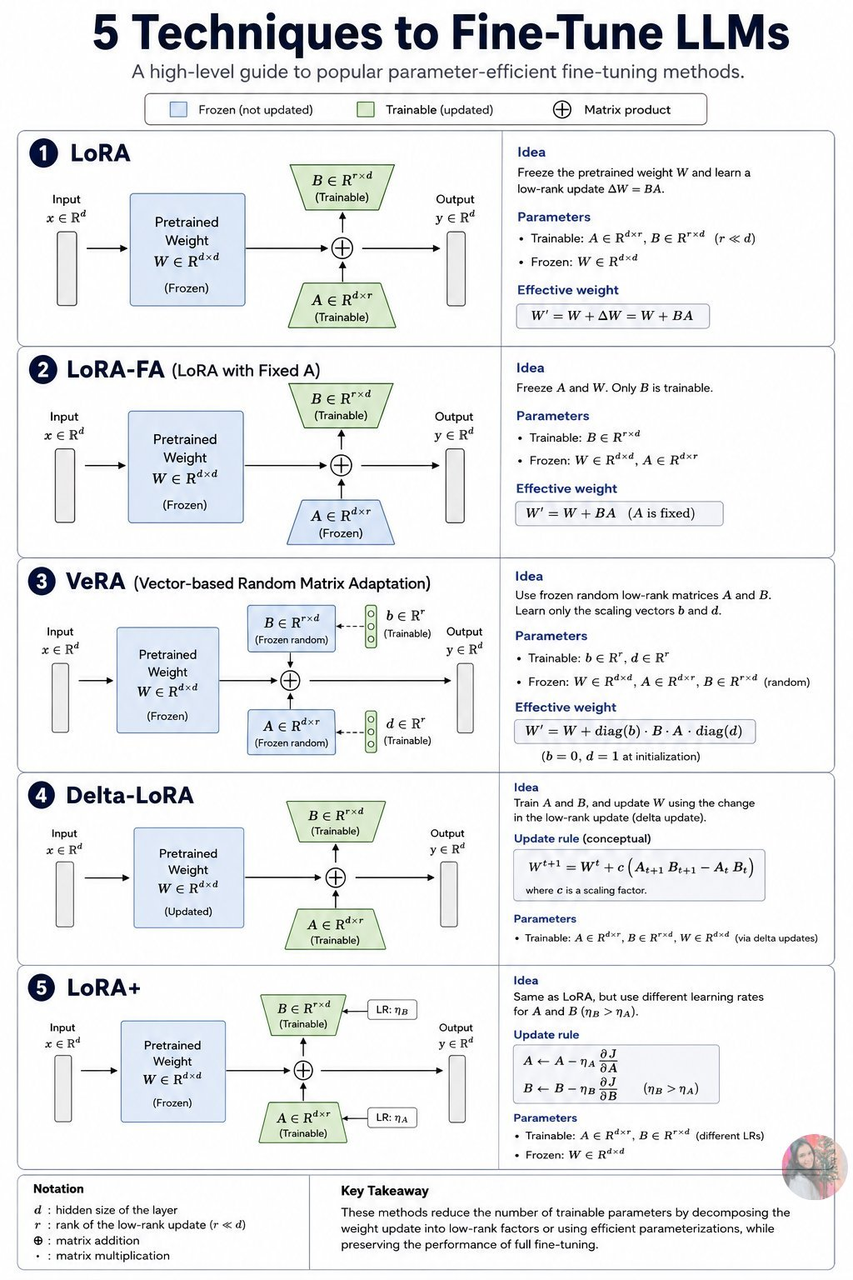
冻结全部预训练权重 ,在模型的线性层(通常是注意力的Q、K、V、投影层)旁并行插入低秩矩阵A、B。前向传播时,输入 分别经过原始权重路径和LoRA路径,结果相加后输出:
•
可训练参数:矩阵 、矩阵
•
冻结参数:预训练权重
•
有效权重公式:
(注:通常采用随机高斯初始化,初始化为零矩阵,保证训练开始时 LoRA 路径无影响)
技术特性
•
推理零损耗:训练完成后可将 合并进原权重,推理阶段与原模型结构完全一致,无延迟、无额外显存占用;
•
任务插拔灵活:不同任务对应不同的LoRA权重,切换时仅需替换低秩矩阵,无需改动基座模型;
•
适配性强:可叠加在任意线性层上,支持注意力层、MLP层等不同位置的适配。
适用场景
工业界通用微调场景,包括领域知识注入、指令跟随微调、风格对齐、多任务适配等,是目前落地最成熟、生态最完善的方案。
2. LoRA-FA(LoRA with Fixed A):固定A矩阵的内存优化版
✍️
LoRA-FA是针对训练显存进一步压缩的变体(Zhang et al., 2023),核心思路是在LoRA基础上再冻结一个矩阵,进一步减少可训练参数量。
核心原理
冻结预训练权重
W0
的同时,将A矩阵初始化后全程固定,仅训练B矩阵的参数。
•
可训练参数:仅矩阵
B∈Rr×d
•
冻结参数:预训练权重 、矩阵
•
有效权重公式:
技术特性
•
参数量减半:可训练参数相比原版LoRA减少50%,训练显存与计算量进一步降低;
•
效果有折损:由于A矩阵无法随任务优化,模型的拟合能力上限下降。在GLUE等复杂语义理解任务上,LoRA-FA的效果通常比原版LoRA低1-3个百分点(取决于具体任务和数据集规模);
•
落地简单:仅需修改训练代码中的冻结逻辑,无需改动模型结构。
适用场景
简单任务快速适配、边缘端低算力微调、参数量极度受限的场景,适合分类、摘要等复杂度不高的下游任务。
3. VeRA(Vector-based Random Matrix Adaptation):向量级极致压缩方案
✍️
VeRA将“参数量压缩”推向极致(Kopiczko et al., 2024),通过随机固定低秩矩阵、仅训练缩放向量,把可训练参数从“矩阵级”降到了“向量级”。
核心原理
A、B两个低秩矩阵采用随机初始化后全程冻结(不参与训练);不再训练完整矩阵,仅引入两个一维缩放向量
b
和
d
,通过对角矩阵对随机矩阵的输出做通道级缩放,实现适配。
•
可训练参数:缩放向量
b∈Rr
、缩放向量
d∈Rr
•
冻结参数:预训练权重
W0
、随机矩阵
A∈Rd×r
、随机矩阵
B∈Rr×d
•
有效权重公式:
(注:实际实现中缩放向量的位置和符号在不同框架下略有差异,上述为简化示意;关键是 A、B 均不参与训练,仅 、两个向量可学习)
初始化规则:初始化为零向量,初始化为全1向量,保证初始状态下LoRA路径无影响。
技术特性
•
参数量极致低:可训练参数仅为 个。以 为例,仅16个可训练参数,相比LoRA(6.55万参数)压缩了约 4000倍();
•
训练成本极低:几乎不增加显存占用,计算开销可忽略;
•
效果上限受限:由于A、B是随机固定的,适配能力高度依赖随机初始化的质量。原论文显示,在少样本场景下VeRA表现接近LoRA,但随着训练数据增加,LoRA的优势逐渐明显。
适用场景
超大规模模型的少样本微调(如数十B以上模型仅用几百条样本)、资源极度受限的边缘场景、快速验证性实验,以及多任务大量LoRA适配器的存储优化场景。
4. Delta-LoRA:增量回写的权重进化方案
✍️
Delta-LoRA打破了“基座权重必须冻结”的设定(Zi et al., 2023),通过低秩矩阵的增量差间接更新基座权重,兼顾训练效率与基座适配能力。
核心原理
训练过程中同时更新A、B低秩矩阵;每轮迭代后,计算当前轮与上一轮低秩更新的差值(Delta),乘以缩放系数后叠加到基座权重
W0
上,实现基座的缓慢迭代。
•
可训练参数:矩阵
A∈Rd×r
、矩阵
B∈Rr×d
(与LoRA参数量相同)
•
基座权重更新规则:
其中 为缩放系数(通常取较小值,如0.1~0.5),用于控制基座权重的更新幅度,防止灾难性遗忘。
技术特性
•
基座持续进化:任务知识逐步融入基座权重,摆脱对LoRA层的依赖,推理时可完全移除LoRA结构;
•
显存效率高于全量微调:不需要直接计算大权重的梯度,通过低秩差值间接更新,显存开销远低于全量微调(仍仅需存储A、B的梯度,与LoRA相当,但额外增加前向计算差值回写的开销);
•
适合持续学习:支持多轮增量训练,逐步向模型注入新知识,缓解灾难性遗忘。
适用场景
持续学习场景、基座模型的领域化迭代、需要将适配能力固化进基座的生产环境,以及多任务累积训练场景。
5. LoRA+:差异化学习率的无成本优化
✍️
LoRA+是对原版LoRA的训练策略优化(Hayou et al., 2024),不改动任何模型结构,仅通过为A、B矩阵设置不同的学习率,即可实现效果与收敛速度的提升。
核心原理
保持原版LoRA的结构完全不变,仅为A、B设置差异化的学习率,且B矩阵的学习率大于A矩阵。
•
可训练参数:矩阵
A
、矩阵
B
(与原版LoRA完全一致)
•
参数更新规则:
A←A−ηA∂A∂L
通常实践中,取 的2~10倍,即可带来明显的效果提升。原论文(Hayou et al., 2024)在WikiText-103等数据集上的实验显示,LoRA+相比原版LoRA可提升约1-4%的困惑度改善,同时收敛所需的迭代步数减少约15-30%。
技术特性
•
零额外成本:不增加任何参数量与计算量,仅修改超参数即可实现优化,落地成本为零;
•
收敛更快、效果更好:原论文实验显示,在多种任务上相比原版LoRA,收敛速度与最终效果均有提升;
•
完全兼容生态:与现有LoRA工具链、推理部署方案100%兼容,无需任何改造。
适用场景
所有使用LoRA的场景均可无缝替换,尤其适合追求效果上限的微调任务,是原版LoRA的“平价升级”方案。
三、技术演进脉络与横向对比
五种技术本质上是沿着两个方向对LoRA进行优化:
•
效率优化路线:LoRA → LoRA-FA → VeRA,逐步压缩可训练参数量,换取更低的训练显存与计算开销;
•
效果优化路线:LoRA → Delta-LoRA / LoRA+,分别从权重更新机制、训练策略两个维度提升适配效果。
| | | | | | | | |
| | | | | | | | |
| | | | | | | | |
| | | | | | | | |
| | | | | | | | |
| | | | | | | | |
注: VeRA的0.024%是相对于原版LoRA的参数量比例;若相对于全量微调(1677万参数),其比例约为0.000095%。Delta-LoRA的参数量与LoRA相同,但额外增加了基座权重的增量计算开销,不属于参数增加。
四、工业场景选型指南
通用业务微调、追求稳定落地:首选原版LoRA,生态完善、坑点少,适配绝大多数场景;
追求效果上限、不增加成本:直接升级LoRA+,仅调整学习率超参即可获得收益,性价比最高;
算力极度受限、简单任务快速适配:选择LoRA-FA或VeRA,牺牲部分效果换取极低的训练成本;
基座领域化、持续增量训练:采用Delta-LoRA,将任务知识逐步沉淀进基座模型,摆脱LoRA依赖;
超大规模模型、少样本适配:可探索VeRA,用极少量参数实现快速适配验证。
✍️
整体来看,参数高效微调的发展始终在“效果、效率、成本”三者之间做权衡,不存在绝对最优的方案,需要结合业务场景、算力资源、效果要求综合选择。而LoRA体系凭借灵活的结构与极强的扩展性,仍在不断衍生新的变体,持续推动大模型的低成本落地。
参考文献
Hu, E. J., Shen, Y., Wallis, P., et al. (2021). LoRA: Low-Rank Adaptation of Large Language Models. arXiv preprint arXiv:2106.09685.
Zhang, Q., Chen, M., et al. (2023). LoRA-FA: Memory-Efficient Low-Rank Adaptation with Fixed Matrix. arXiv preprint.
Kopiczko, D. J., Blankevoort, T., & Cohen, T. S. (2024). VeRA: Vector-based Random Matrix Adaptation. arXiv preprint arXiv:2402.05261.
Zi, B., Qi, X., et al. (2023). Delta-LoRA: Updating Pre-trained Weights via Low-Rank Increments. arXiv preprint.
Hayou, S., Ghosh, N., & Yu, B. (2024). LoRA+: Efficient Low-Rank Adaptation with Optimized Learning Rates. arXiv preprint arXiv:2402.12354.