一文读懂大语言模型中的KV缓存
🧩
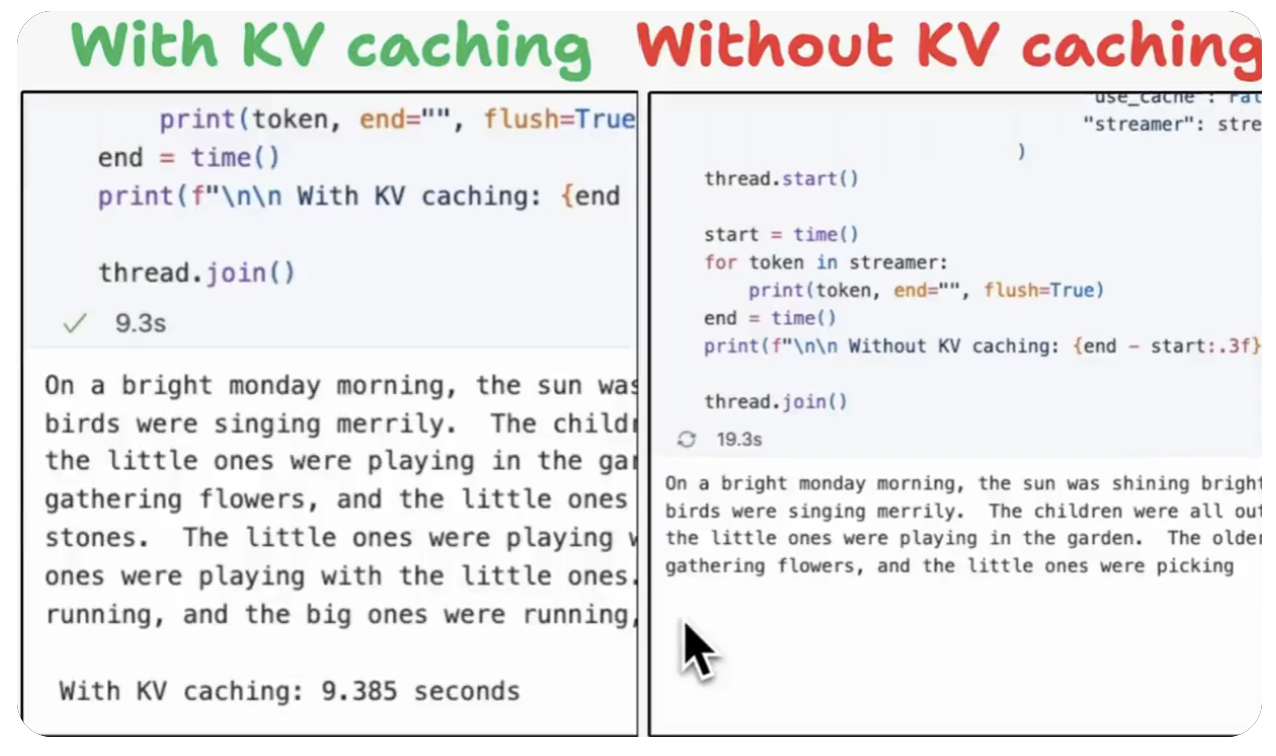
每当你使用 Codex 时,都会注意到:第一个标记的显示明显更慢,而后续的标记几乎会瞬间接连出现。那并不是界面上的小问题,而是一个名为KV缓存的刻意工程决策。它能让大语言模型的推理速度提升约5倍。
让我们从基本原理出发,来理解它的运作方式。
第一部分:大语言模型如何生成标记
变压器会处理所有输入标记,并为每个标记生成一个隐藏状态。这些隐藏状态会被映射到词汇空间,从而产生 logits(即词汇表中每个词的一个得分)。
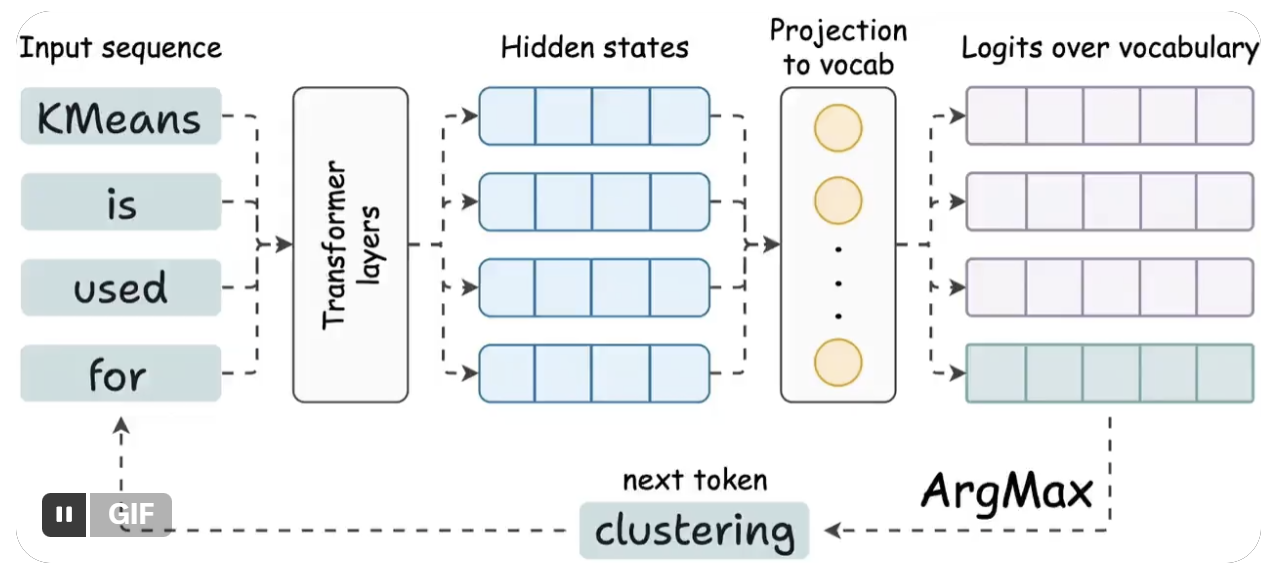
但只有来自最后一个标记的对数几率才重要。你从中采样,得到下一个标记,将其附加到输入中,然后重复。
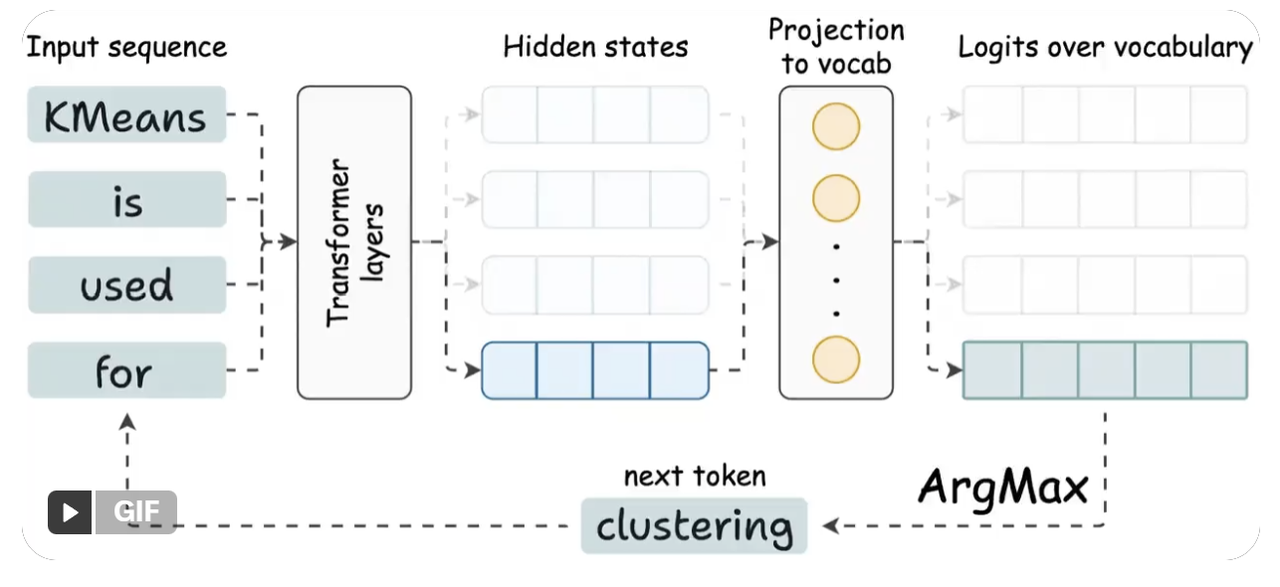
这是关键洞见:要生成下一个标记,你只需要最新一个标记的隐藏状态。其他所有隐藏状态都只是中间产物。
第二部分:注意力究竟计算什么
在每个变压器层中,每个标记都会生成三个向量:查询(Q)、键(K)和值(V)。注意力机制通过将查询与键相乘得到得分,再用这些得分对值进行加权。
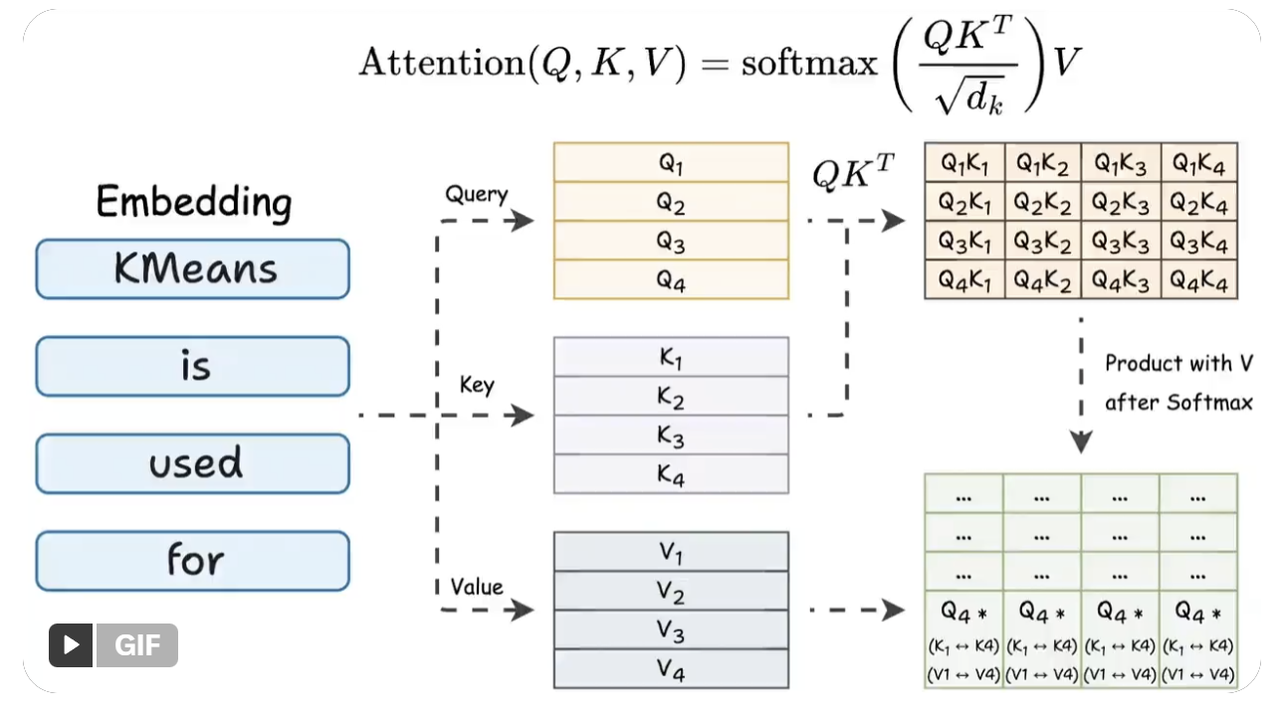
现在只关注最后一个标记。
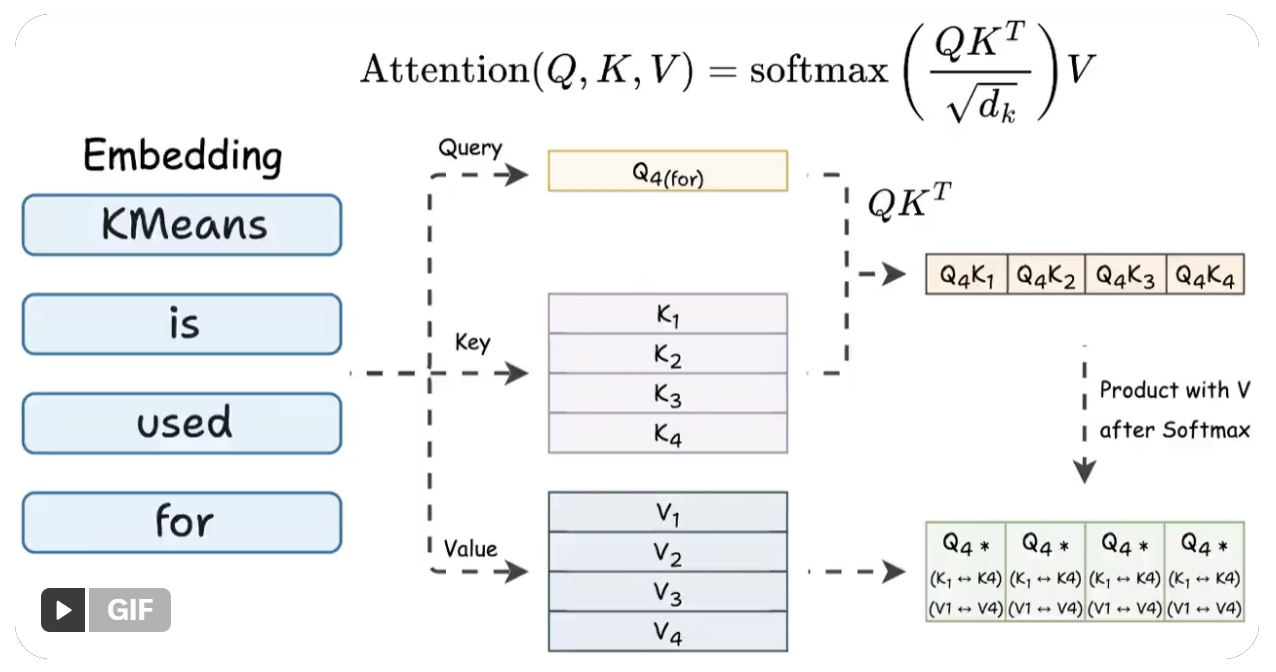
QK^T 的最后一行使用:
•
最后一个标记的查询向量
•
序列中的所有键向量
该行的最终注意力输出使用:
•
相同的查询向量
•
所有键向量和值向量
因此,为了计算我们所需的唯一隐藏状态,每一层注意力机制都需要来自最新标记的Q,以及来自所有标记的K和V。
第三部分:冗余
生成第50个标记需要第1至第50个标记的K和V向量。生成第51个标记则需要第1至第51个标记的K和V向量。
用于第1至第49个标记的K向量和V向量早已计算完毕,且未发生任何变化。输入相同,输出也相同,但模型却在每一步都从头重新计算它们。
这在每一步都造成了 O(n) 的冗余工作。在整个世代中,总共浪费了 O(n²) 的计算量。
第 4 部分:解决方案
与其在每一步都重新计算所有的K和V向量,不如将它们存储起来。对于每一个新 token:
仅针对最新的 token 计算 Q、K 和 V。
将新的K和V追加到缓存中。
从缓存中检索所有先前的K和V向量。
使用新的 Q 对完整的已缓存 K 和 V 进行注意力计算。
这就是KV缓存。每层每步新增一个K和一个V,其余一切均来自内存。
注意力计算仍然随序列长度线性扩展(因为你需要对所有键和值进行注意力计算)。但用于生成 K 和 V 的昂贵投影操作仅在每个 token 上执行一次,而非每一步都执行一次。
第5部分:首次标记时间
现在你明白为什么第一个标记会很慢了。
当您发送一条提示时,模型会在一次前向传播中处理整个输入,并为每个标记计算并缓存 K 和 V 向量。这就是 预填充阶段,也是该请求中计算量最大的部分。
一旦缓存预热完成,后续每个标记只需进行一次前向传播,且每次仅处理一个标记。速度极快。
这种初始延迟被称为首令牌响应时间(TTFT)。提示越长,预填充所需的时间就越久,等待也就越长。优化TTFT(分块预填充、推测解码、提示缓存)本身就是一个非常深入的话题,但其基本逻辑始终如一:构建缓存的成本很高,而从缓存中读取则成本很低。
第六部分:权衡
KV缓存以内存换取计算。每一层都会为每个token存储K和V向量。对于Qwen 2.5 72B(80层、32K上下文长度、隐藏层维度8192),单个请求的KV缓存就可能占用数GB的显存。在数百个并发请求的情况下,其占用的显存往往超过模型权重本身的大小。
这就是为什么会出现分组查询注意力(GQA)和多查询注意力(MQA):在各个查询头之间共享键值头,从而降低内存开销,同时仅带来极小的性能损失。这也解释了为何将上下文长度翻倍如此困难:窗口大小翻倍,每条请求对应的KV缓存也相应翻倍,导致并发用户数大幅减少。
简而言之
KV 缓存可在自回归生成过程中消除冗余计算。先前的标记总是生成相同的 K 和 V 向量,因此只需计算一次并将其存储起来。每个新标记仅需自己的 Q、K 和 V,随后注意力机制便基于完整的缓存进行计算。
在实际应用中可实现5倍的加速。代价是显存,而在大规模场景下,显存往往成为瓶颈。所有大语言模型推理栈(vLLM、TGI、TensorRT-LLM)均基于这一理念构建。