大模型推理加速六大核心技术:LLM 在线服务底层原理深度解析
大语言模型(LLM)自回归推理流程天然划分为Prefill(预填充)与Decode(解码)两个阶段。
•
Prefill 阶段对输入 Prompt 并行计算,一次性生成全部输入 token 对应的注意力 Key 与 Value(KV Cache);
•
Decode 阶段则以自回归方式逐 token 生成输出,每一步都需要读取、更新 KV 缓存。
🧠
在线业务场景下,GPU 显存带宽、算力、内存碎片、请求排队延迟、批调度策略共同决定服务吞吐量与首 token 延迟(TTFT)。
为了在有限硬件资源下提升并发能力、降低推理时延,工业界主流 LLM 推理引擎(vLLM、TensorRT-LLM、DeepSpeed-MII 等)普遍集成六项核心优化技术,各项技术可叠加协同,构成现代 LLM Serving 的技术底座。
前缀缓存 Prefix Caching
前缀缓存是针对重复 Prompt 前缀场景的 KV 缓存复用优化。在大量业务场景中,不同用户请求会共享相同的提示词前缀,例如固定的系统 Prompt、通用指令模板、重复知识库检索片段等。在兼容的模型上下文环境下,若两条请求拥有完全一致的前缀 token 序列,则该部分已经计算完成的 KV 缓存可以直接复用,无需重复执行 Prefill 计算。
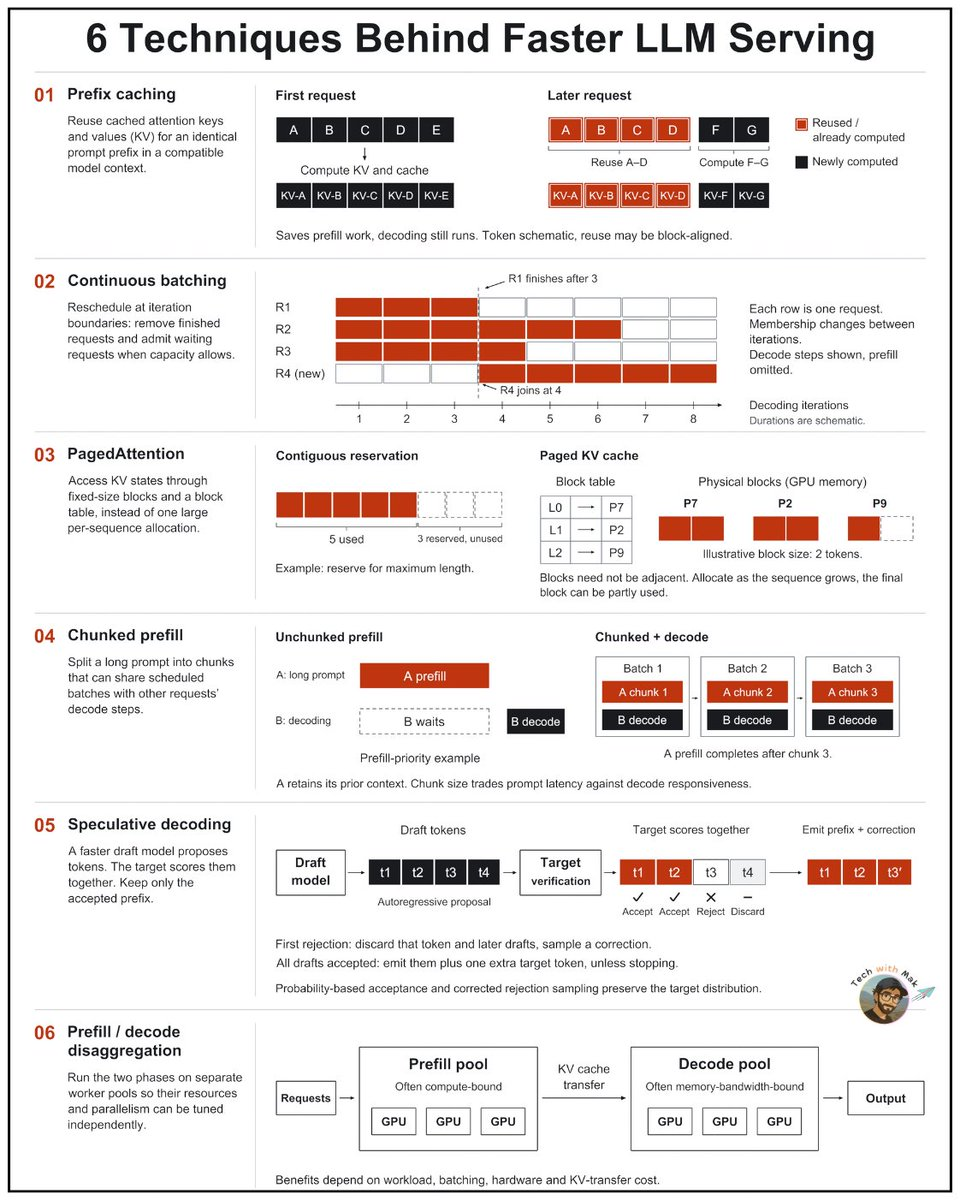
以示意图为例:第一条请求序列A B C D E执行 Prefill,完整计算全部 token 对应的 KV 张量并持久化缓存。后续新请求序列A B C D F G,其前 AD 的 token 序列与前者完全匹配,引擎直接读取已缓存的 KV-AKV-D,仅对新增的 F、G 执行 Prefill 计算,极大削减预填充阶段算力开销。
工程实现上,缓存复用一般按内存块对齐,并非任意 token 切片都可复用。该优化仅削减 Prefill 阶段开销,不会改变后续 Decode 阶段的执行逻辑。前缀缓存的收益高度依赖业务请求的前缀重合度:企业知识库、对话机器人、固定模板调用场景收益显著;用户提问完全随机的场景,缓存命中率低,提速效果有限。
连续批处理 Continuous Batching
传统静态批处理(Static Batching)的调度逻辑是收集一批请求,等待 batch 内所有请求全部推理结束之后,才释放资源并送入下一批新请求。该模式极易出现 “长尾阻塞”:batch 内部分短请求已经完成生成,但 GPU 资源被未结束的长请求占用,GPU 算力长期闲置,资源利用率偏低。
连续批处理,又称为迭代级批处理(Iteration-level Batching),在每一轮解码迭代边界动态重调度请求队列。在每一步 Decode 迭代结束后,引擎执行两个动作:移出已经生成结束的请求;在显存容量允许的前提下,将排队等待的新请求加入当前 Batch。
示意图中 R1 提前完成生成,引擎立刻将排队的新请求 R4 接入 batch,不需要等待 R2、R3 全部结束。该技术持续维持 GPU 的高负载,是现代 LLM 推理引擎的基础能力。示意图仅展示解码迭代调度逻辑,省略了 Prefill 阶段的调度细节。连续批处理可以显著提升 GPU 吞吐量,但对调度器、内存管理模块提出更高要求,需要实时监控显存占用,防止并发过载引发 OOM。
分页注意力 PagedAttention
原生 KV 缓存分配存在严重显存浪费问题:传统实现会为每一条推理序列,一次性分配该序列最大上下文长度对应的连续显存空间。而绝大多数实际请求的真实序列长度远小于预设上限,大量预分配的显存全程闲置,同时频繁创建销毁连续内存块会产生大量显存碎片,限制单卡可承载并发请求数量。
PagedAttention 借鉴操作系统虚拟内存分页机制,是 vLLM 引擎的核心创新。它将 KV 缓存切分为固定大小的独立内存块(Block/Page),使用一张块表(Block Table)维护逻辑块编号到 GPU 物理显存块的映射关系。逻辑上连续的上下文,在 GPU 物理显存中不需要连续存放。随着序列 token 不断增加,引擎按需分配物理块;序列末尾最后一个块可以仅使用部分空间,无需填满。
这套机制大幅减少显存碎片,显著提升显存利用率,让单张 GPU 能够承载更多并发会话。PagedAttention 同时兼容连续批处理、前缀缓存,是高并发 LLM 在线服务的基石技术。
分块预填充 Chunked Prefill
在未引入分块预填充的引擎中,超长 Prompt 的 Prefill 任务会独占 GPU 资源。当一个长 Prompt 请求执行 Prefill 时,其他正在进行 Decode 生成的请求必须等待 Prefill 完全结束,引发严重的请求阻塞,拉高在线服务的抖动与首 token 延迟。
分块预填充将长 Prompt 切分为多个独立片段(Chunk),把每个 Chunk 的 Prefill 任务穿插调度在其他请求的 Decode 迭代之间。如图示例:长 Prompt 请求 A 被切分为 Chunk1、Chunk2、Chunk3 分段执行;在 A 处理每一个分片的间隙,其他请求 B 可以继续执行解码生成,不会被完全阻塞。请求 A 会持续保留已完成分片的上下文 KV 信息,分段完成全部 Prompt 预填充。
Chunk 大小是关键调优参数,存在明确的权衡关系:Chunk 尺寸越大,单条 Prompt 整体 Prefill 延迟越低;Chunk 尺寸越小,对正在解码的请求的干扰越小,生成响应更平滑。工程上需要根据业务 Prompt 长度分布、TTFT 指标目标调整分片策略,在 Prompt 延迟与解码服务响应稳定性之间取舍。
推测解码 Speculative Decoding
传统自回归解码每一步仅生成 1 个 token,主模型需要反复执行前向计算,Decode 阶段延迟是 LLM 服务核心瓶颈。推测解码的核心思想是:使用参数量更小、推理更快的 Draft 草稿模型,一次性预生成一串候选 token;再由目标主模型并行校验整串候选序列。
完整流程:
轻量草稿模型自回归生成一串候选 token t1、t2、t3、t4;
将全部候选 token 送入主模型并行打分验证;
从序列起始位置依次校验,直到遇到第一个不满足接受条件的 token:
◦
所有通过校验的 token 直接输出;
◦
遇到第一个拒绝 token 时,丢弃该 token 及其后方全部草稿候选,由主模型采样生成修正 token;
◦
若全部草稿 token 都通过校验,则输出全部草稿 token,并额外再生成 1 个 token 继续推进推理。
该算法采用基于概率的接受策略与修正拒绝采样,严格保证最终输出 token 的概率分布,和直接使用主模型原生自回归生成的分布完全一致,不会损害输出文本质量。推测解码的主要开销来自草稿模型的维护与推理,适合对 token 生成时延敏感的场景,代价是系统架构复杂度上升,需要维护双模型链路。
预填充 / 解码分离 Prefill / Decode Disaggregation
Prefill 与 Decode 两个阶段的硬件资源特征完全不同:Prefill 是计算密集型任务,大量并行矩阵运算,算力是瓶颈;Decode 阶段逐 token 读写 KV 缓存,属于显存带宽密集型任务,GPU 显存带宽为主要瓶颈。二者最优硬件选型、并行策略差异巨大。
预填充 - 解码分离架构,将两类任务部署在相互独立的 GPU 资源池:
用户请求送入 Prefill 算力池,完成 Prompt 预填充,计算得到 KV 缓存;
通过高速互联链路将 KV 缓存传输至 Decode 显存带宽池;
Decode 池负责执行自回归解码,逐 token 生成输出并返回结果。
两个资源池可以独立选型 GPU、独立配置并行参数,分别优化算力与带宽资源。该方案收益取决于业务负载特征、批处理策略、硬件互联带宽,以及 KV 缓存跨机传输开销。当 KV 传输开销过高时,分离架构的收益会被抵消。因此该方案多用于超大模型分布式部署场景,小模型单卡推理场景一般不会采用。
总结
以上六项技术并非互斥,工业界 LLM 在线服务框架通常会进行组合部署。前缀缓存、PagedAttention、连续批处理构成基础优化组合,解决显存浪费、并发调度、重复 Prompt 开销三大基础问题;面对超长输入场景,叠加分块预填充缓解长 Prompt 阻塞;对生成延迟敏感业务引入推测解码降低 token 输出时延;千亿、万亿级大模型分布式部署场景,才考虑 Prefill 与 Decode 的资源池分离。
整套技术栈的核心目标,是打破自回归推理的性能瓶颈,在 GPU 硬件成本受限的前提下,同时提升服务吞吐量、降低首 token 延迟、优化显存利用率,支撑 LLM 大规模工业化落地。