agent-vision-toolkit
所想即所见——给任意纯文本 coding agent 装上眼睛
图片问答、长图OCR、前端UI还原、GUI自动化,一套视觉工具箱加一个 skill
并可选无缝接入 Codex、Claude Code、Pi、Oh My Pi、OpenCode
🪢
🎯 agent视觉能力不一定长在模型上,也可以长在harness上。
该Skill提供了一套工具、技能和代理方案,让纯文本模型也能对等地甚至更好地完成各类视觉任务,尽量让纯文本模型agent的交互体验和多模态模型的交互体验保持一致,最终做到在工具加持下,文本模型agent的多模态任务能力反超不使用该仓库工具和技能的原生多模态agent。
本仓库提供两类内容:
视觉工具CLIs:多个 CLI,外加一个 skill 告诉 agent 什么时候该用哪个。任何能调用 shell 的 agent 都能使用。
无缝接入(可选升级):透明本地代理与单文件原生插件,让我们粘贴的图片和 agent 内置的看图工具也能完美工作,不需要额外的工具安装,也不需要额外提示词。
所有代码均已在真实 Codex + DeepSeek 会话中验证过
同一套管线也在 Claude Code、Pi、Oh My Pi、OpenCode 中完成了真机端到端验证
实际效果
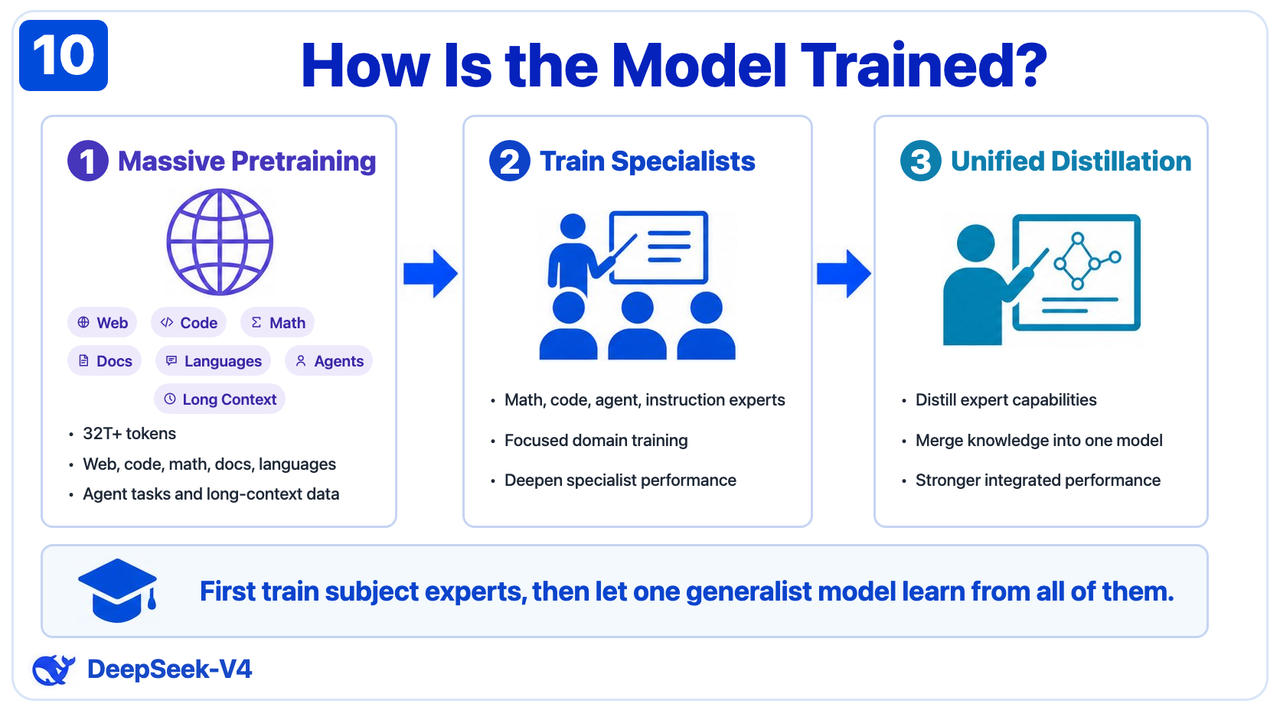
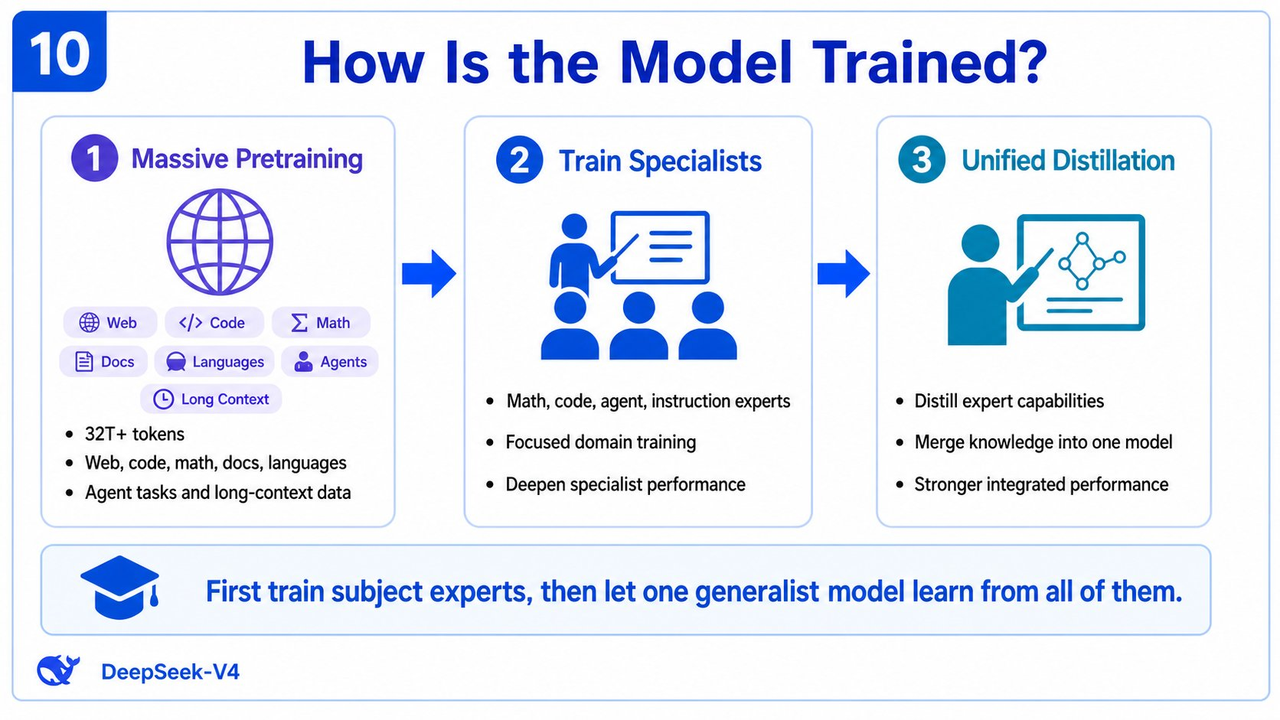
信息图还原:一句话从截图到 HTML
50%
50%
左:原始信息图截图;右:使用 HTML/CSS 复刻的可编辑结果。查看 HTML 源文件 →
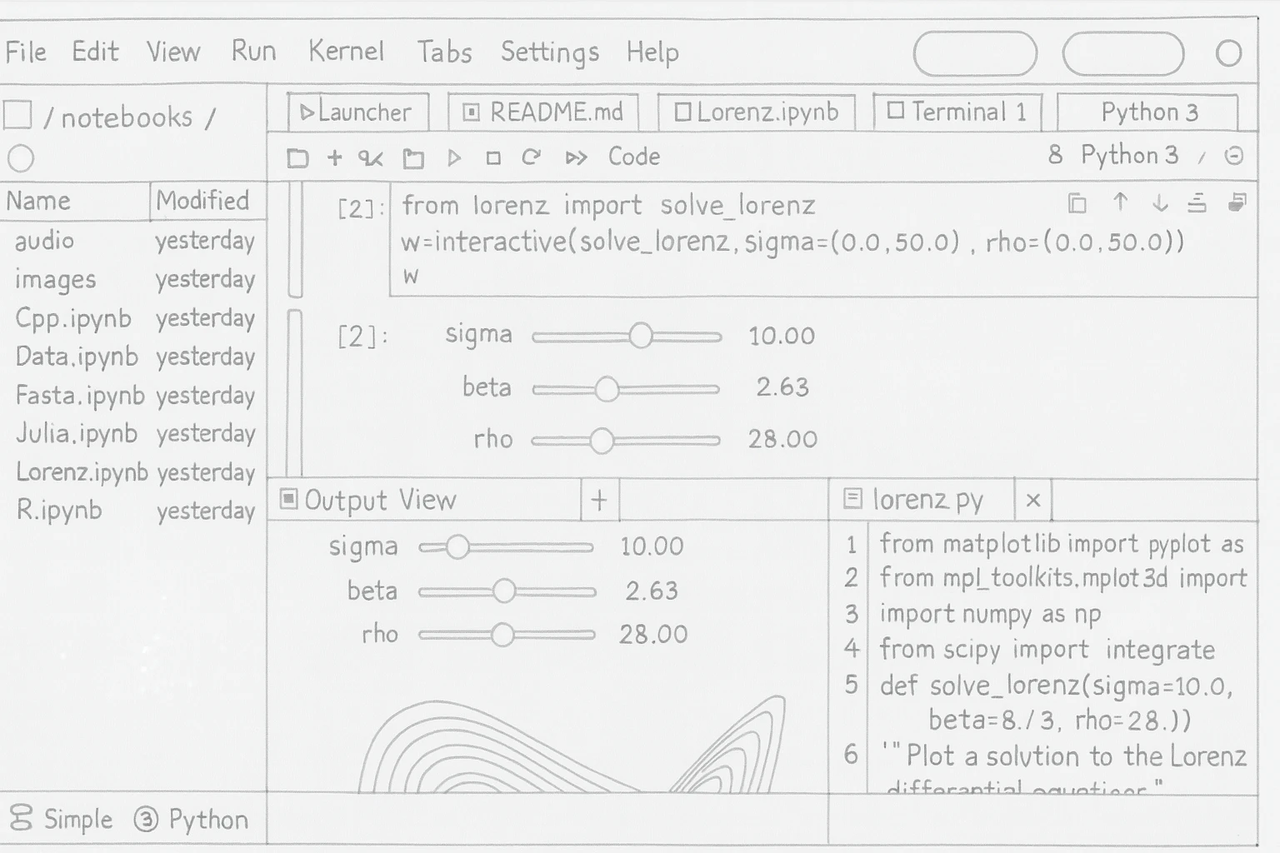
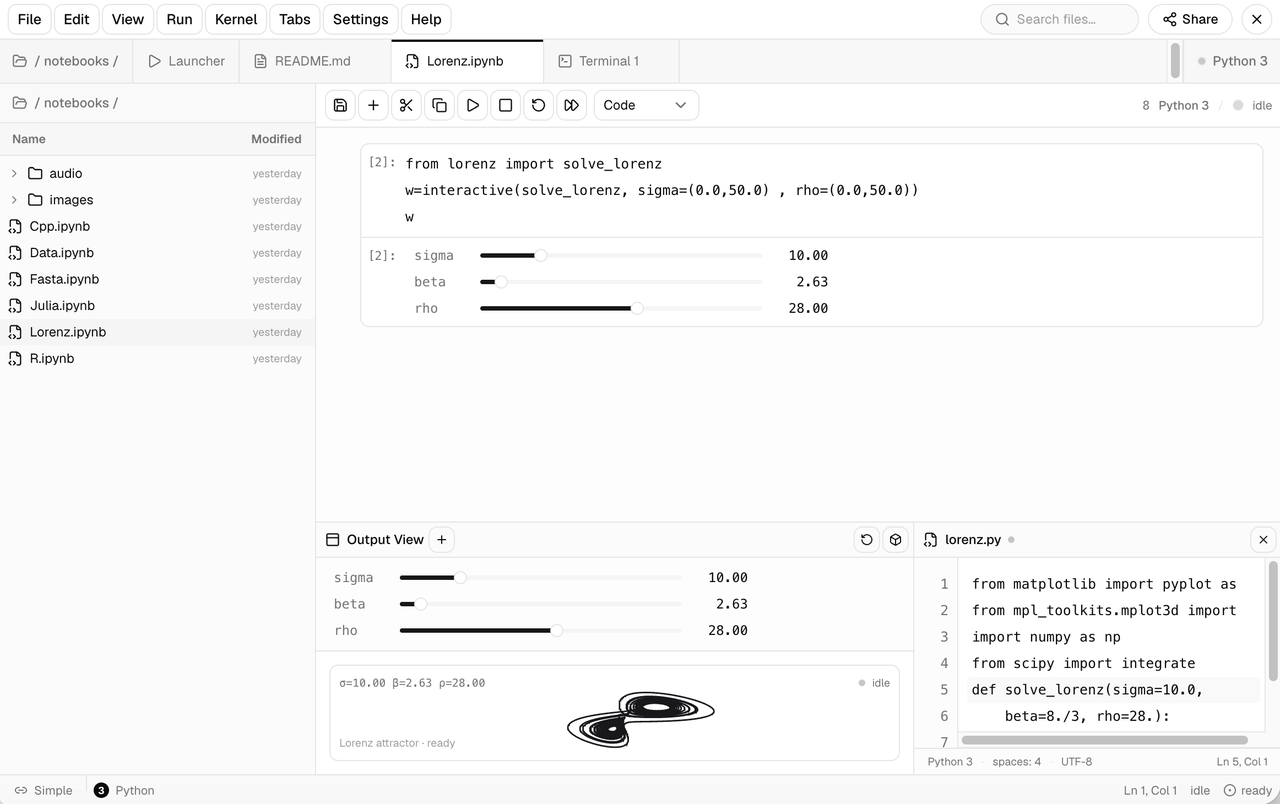
UI 还原:一句话从手绘稿到成品界面
49%
51%
左:作为输入的手绘参考;右:依据该手绘稿还原出的 JupyterLab 工作区界面。完整流程见 UI 还原 playbook。由 Codex 搭配 deepseek-v4-flash 实际执行。
快速 UI 还原:先交付近似复原
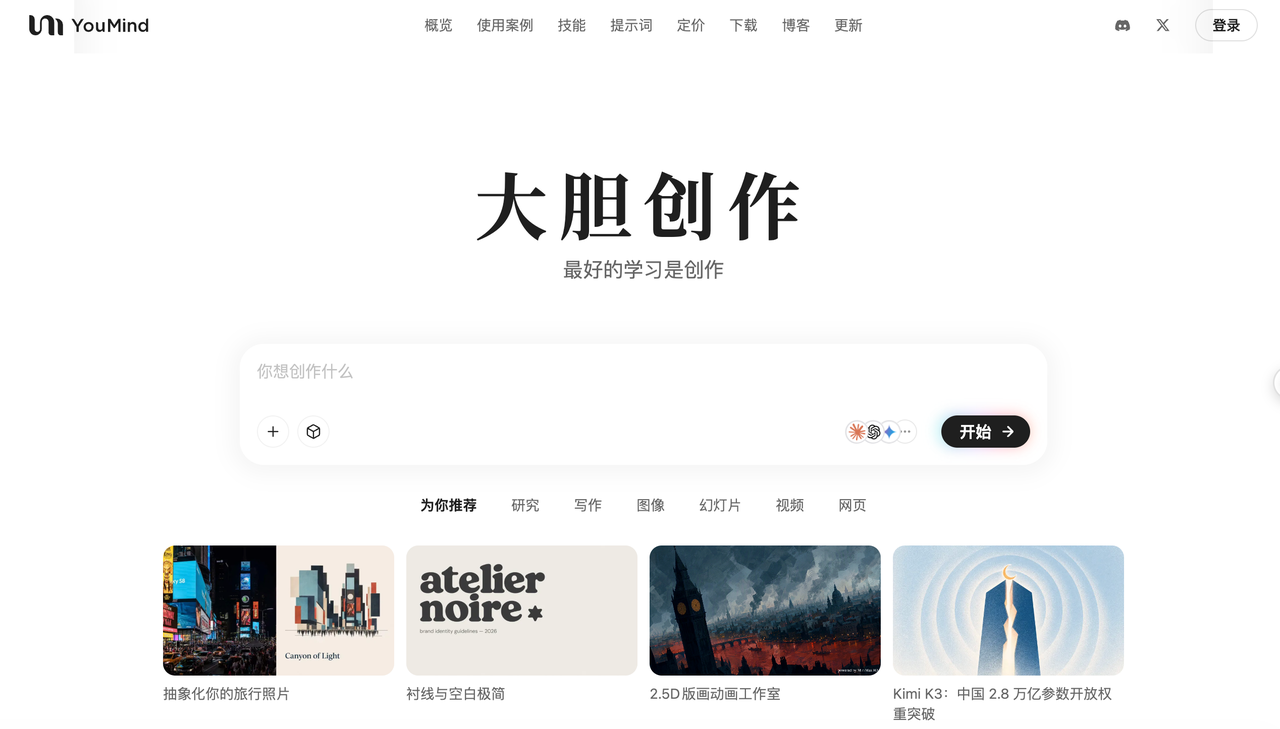
50%
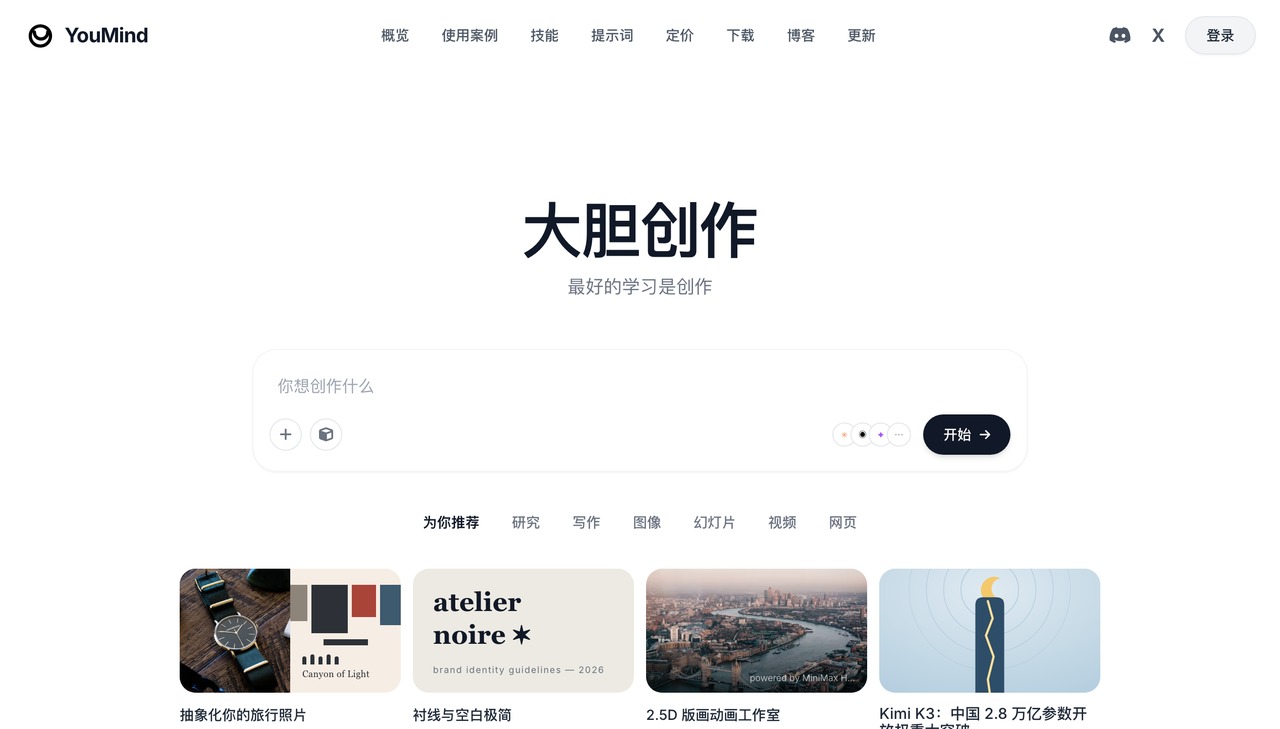
50%
左:原始页面;右:快速复原结果。该模式优先保留主要布局、内容和视觉层级,允许颜色和前端图标库中的图标近似;目标是在约三分钟内给出第一张截图。
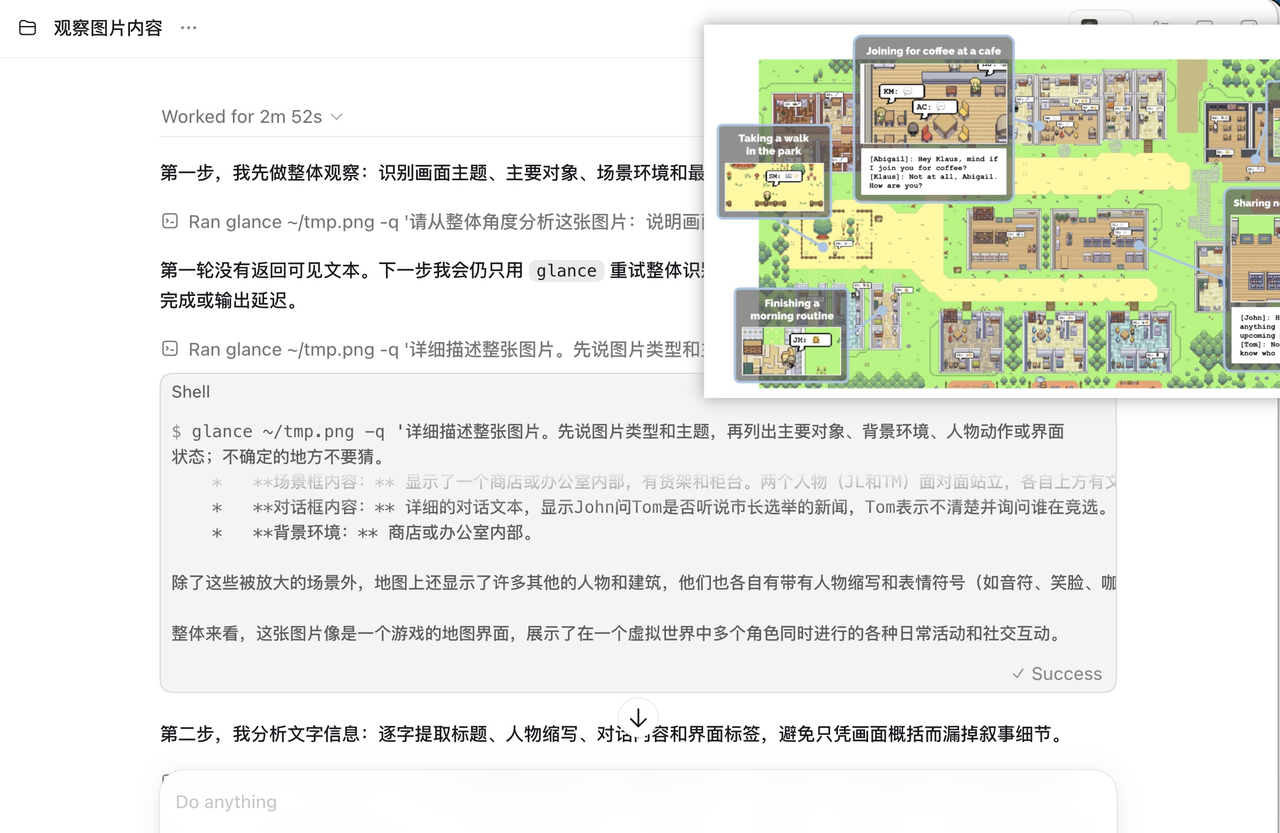
47%
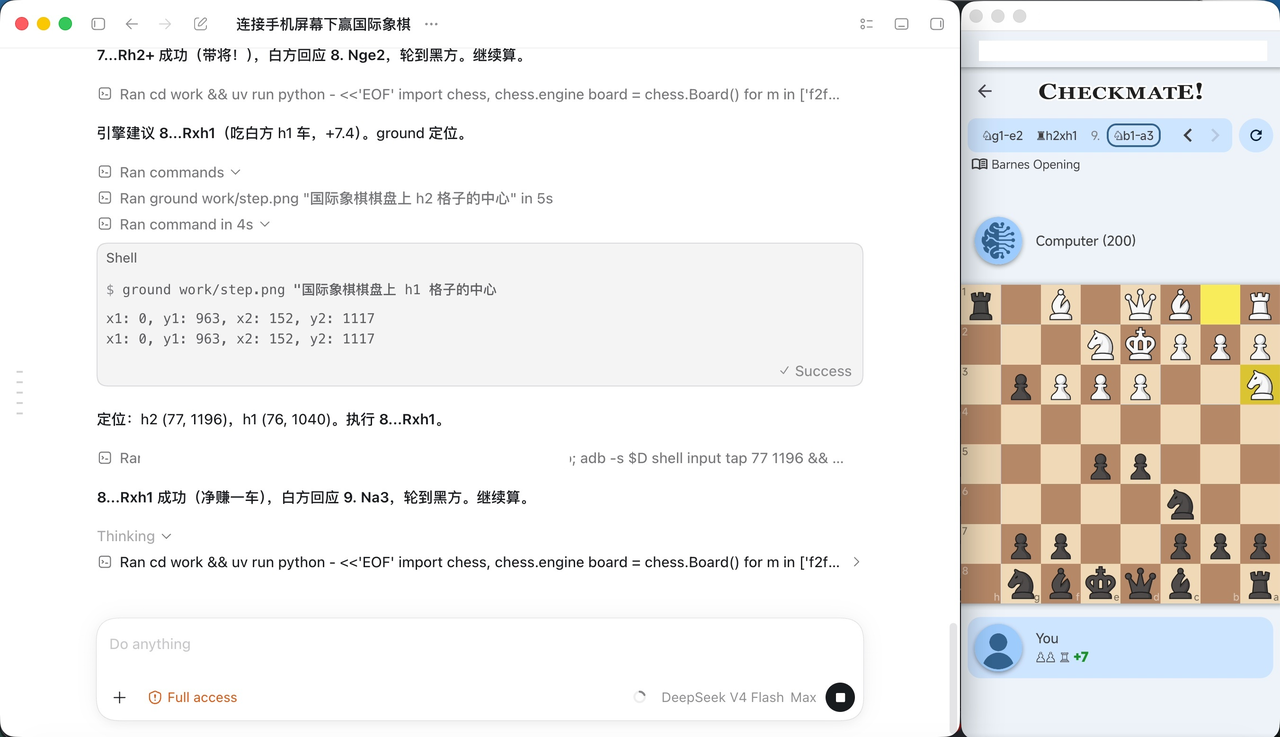
53%
左:用 glance 做多轮图片问答;右:用 ground 定位屏幕视觉元素,DeepSeek V4 自主游玩国际象棋。
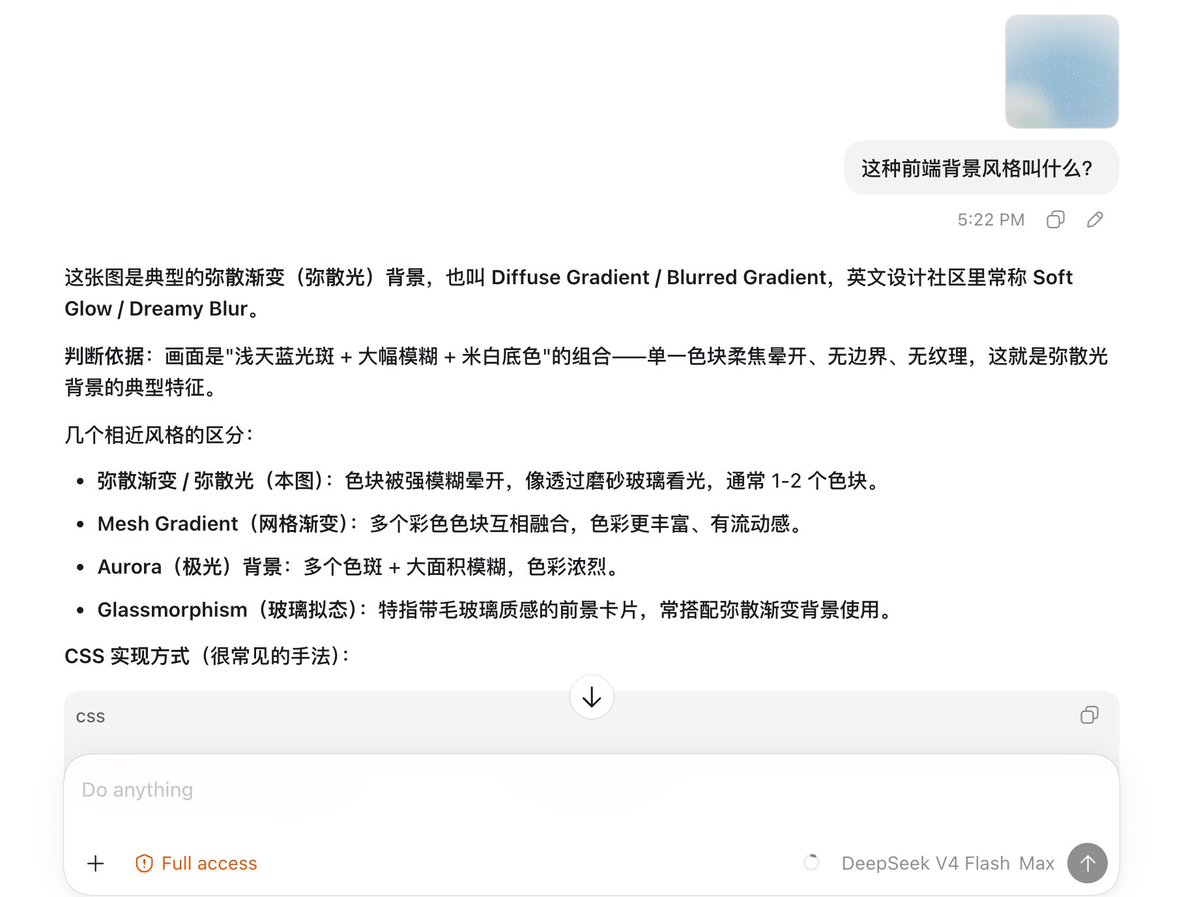
44%
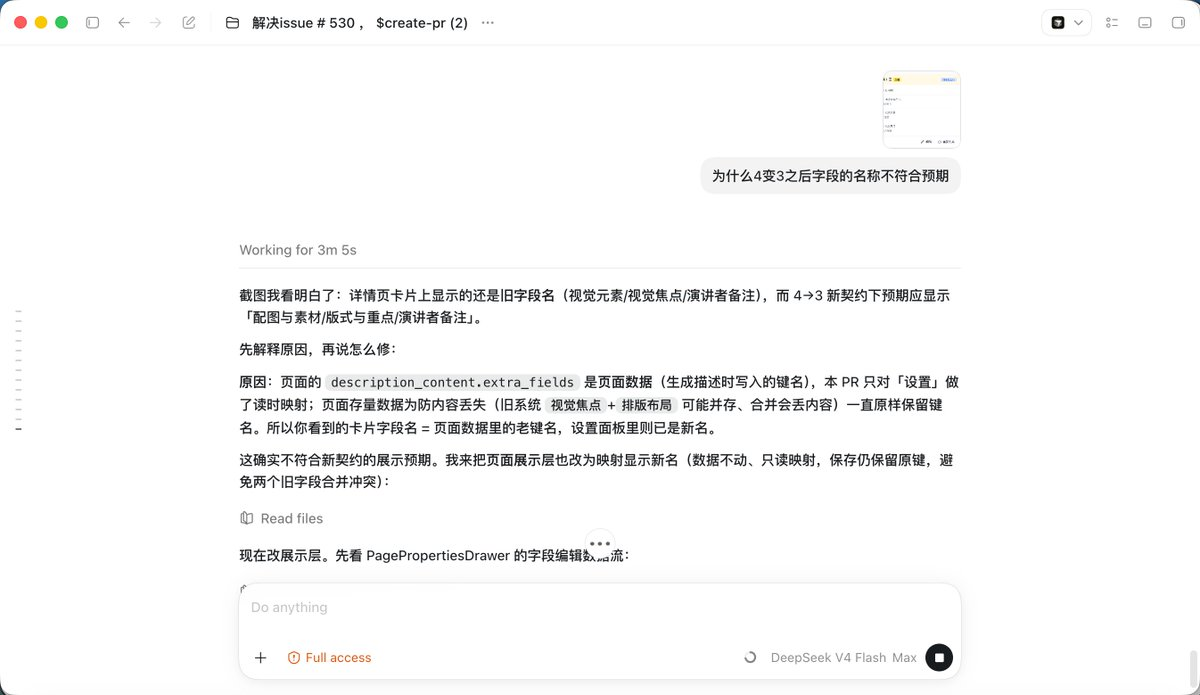
56%
左:DeepSeek V4 回答 UI 背景风格问题并对比相近风格;右:DeepSeek V4 根据截图排查字段名称不符预期的 bug。
亮点
•
不只是看图描述,是获取llm真正关注的内容:看图时传递用户/模型的最新意图,得到这一轮真正要用到的细节,而不是一段没有重点的宽泛描述。
•
直接粘贴图片和内置看图都支持:直接粘贴图片,和模型调用内置工具两种方式,都能看图。
•
一套经过实战验证的视觉任务方法论:项目提供的skill,会告诉 agent 面对不同视觉任务时应该看什么、选择哪个工具、按什么步骤推进,以及最后如何验证结果。
•
一句话安装:直接让 agent 沿着已验证流程一键安装,视觉工具箱、skill 和无缝接入一次到位。
用例技能
随项目提供的 vision-skills skill 内置了可以直接对照执行的完整用例。 使用时机、工具调用顺序、最后如何验收,都写在对应的技能文档里:
快速开始
最简单的安装方式,是把这句话发给 agent:
根据 https://github.com/Anionex/agent-vision-toolkit 的仓库指引,在本地安装视觉工具箱和 skill。如果视觉 API 尚未配置,请按当前系统找到配置文件,并引导我填写 VISION_API_KEY、VISION_BASE_URL 和 VISION_MODEL。
如果需要安装可选的无缝接入层,也可以发送:
完整阅读 https://github.com/Anionex/agent-vision-toolkit/blob/main/AGENT_INSTALL.md,根据我们当前使用的 agent 应用,安装适用的视觉代理或原生 extension/plugin。如果视觉 API 尚未配置,请按当前系统找到配置文件,并引导我填写 VISION_API_KEY、VISION_BASE_URL 和 VISION_MODEL。
只需准备一个支持 OpenAI Chat Completions、OpenAI Responses 或 Anthropic Messages 的多模态 API,以及它的 base URL、API key 和模型名称;agent 会引导你把它们写入对应的配置文件。
对于可选接入层,安装完成并重启后,直接粘贴图片或让模型调用内置看图工具即可。Pi、Oh My Pi、OpenCode 走的是单文件原生 extension 而不是代理,可见各 agent 的文档。
三步手动安装
指向一个视觉 API——在 ~/.config/agent-vision-toolkit/env 里写三个环境变量(chmod 600):
代码块
Plain Text
VISION_API_KEY=sk-...
VISION_BASE_URL=https://openrouter.ai/api/v1
VISION_MODEL=google/gemini-3.6-flash
任何支持 /chat/completions 与 image_url 的 OpenAI-compatible 端点都可以(如阿里云百炼:https://dashscope.aliyuncs.com/compatible-mode/v1 + qwen-vl-max-latest)。Python 客户端/代理也可设置 VISION_API_PROTOCOL=responses 使用 /responses + input_image,或设置 VISION_API_PROTOCOL=anthropic 使用 Anthropic Messages;此时 Base URL 应以 /v1 结尾,不要包含 /messages。需要英文描述时加 LANG=en(默认中文)。
把 CLI 放进 PATH:
代码块
Bash
git clone https://github.com/Anionex/agent-vision-toolkit.git
export PATH="$PWD/agent-vision-toolkit/bin:$PATH" # 写进 shell 配置以持久生效
glance 只需要 Python 3.11+;ground/detect/crop 和长截图 OCR 用例需要 pillow;trace 需要 pillow + numpy(只有显式使用 --outline 轮廓回退时才需要 vtracer)。只为实际使用的工具在隔离 venv 中安装可选依赖。
安装 skill,让 agent 知道这些工具的存在以及如何组合使用:
代码块
Plain Text
npx skills add Anionex/agent-vision-toolkit --skill vision-skills -a codex -g --copy -y
也可以把 skills/vision-skills/ 复制到你的 agent 的 skills 目录(如 ~/.codex/skills/),重启生效。
工作原理
让描述更加贴合agent的意图
大多数纯文本模型的视觉转接方案只是用多模态模型把图片变成一段通用描述,之后再丢给纯文本模型,让他自己根据描述拼凑出想要的内容,这中间隔了一层语义;一些东西必然会丢失——也就是这个地方存在的损失,让我们认为缝合方案必然带来巨大的性能损失。
为了解决这个问题,agent-vision-toolkit 尝试利用和得到 agent 为什么要看这张图的动机。它从用户消息、或模型调用 内置看图工具时自述的理由中提取出模型当时看图的动机,再把这个动机作为 focus hint 一并交给视觉模型。拿回来的是一段贴合任务的描述,突出当前这一步真正要紧的内容,而不是一段通用的“详细描述”。更低成本,更高的准确率,更快的响应速度。
50%
50%
50%
50%
请求流与协议细节
代码块
Plain Text
Codex -> 127.0.0.1:19100 -> 用户原有的纯文本模型上游
|
+-- 请求含图片时:
focus hint(用户的请求,或模型调用 view_image 时自述的动机)
-> 视觉 prompt -> 文字描述 -> 替换图片