Context Engineering 实战:如何为 AI 提供最完美的上下文
🚪
Context Engineering 不是简单的复制粘贴,而是对信息的“精算”。通过构建任务卷宗(Task Dossier)、利用 Prompt Caching 以及维护 CLAUDE.md 长期记忆,你可以将 AI 的逻辑一致性提升 200%。本文将分享一套可落地的上下文优化工作流。
引言
我们讨论了为什么上下文比 Prompt 更重要。但在实际开发中,面对数万行的代码库,你该递给 AI 哪些文件?如何防止它在海量信息中迷失?
本文将为你揭示 2026 年最顶尖的上下文工程实战技巧。
实战策略一:构建“任务卷宗” (The Dossier Pattern)
当你要求 AI 执行一个复杂的重构任务时,不要直接提问。先为它准备一份任务卷宗。
一份完美的卷宗应包含:
目标定义:本次任务的具体终点。
核心文件:直接涉及逻辑修改的 3-5 个文件。
引用链上下文:这些文件调用的关键工具类或接口定义(通常只需提供函数签名,无需全部代码)。
规格约束:预先写好的 spec.md。
实战技巧:在 Cursor 或 Trae 中,利用 @ 符号手动挑选这些文件,而不是让它扫描全库。这能显著减少噪音。
实战策略二:利用 CLAUDE.md 进行长期记忆管理
在长达数天的项目开发中,对话历史会变得臃肿且不可靠。
CLAUDE.md 方案是目前的最佳实践。在项目根目录维护这个文件,内容包括:
•
技术栈习惯:如“我们在这个项目中使用 Tailwind + Shadcn”。
•
架构约定:如“所有数据请求必须通过 React Query 处理”。
•
进度快照:如“已完成登录模块,正在进行支付模块的对接”。
操作建议:每当你完成一个重要阶段,就对 AI 说:“请总结我们刚才达成的架构决定,并更新到 CLAUDE.md 中。”
实战策略三:动态 .cursorrules 转向
如果你在处理特定模块(如:图像处理),全局的 .cursorrules 可能不够精准。
进阶技巧:在子目录中创建局部规约。AI 进入该目录时,会优先读取局部的上下文指令。
•
/src/components/ui/ 下的规约:专注无障碍(A11y)和动画性能。
•
/src/api/ 下的规约:专注错误处理和重试逻辑。
实战策略四:利用 Prompt Caching 优化性能与成本
在 2026 年,主流模型(Claude 3.7+)都支持 Prompt Caching(提示词缓存)。
如果你的上下文非常长(如 50k tokens),只要保持上下文的前半部分(系统提示词、基础架构代码)不变,后续请求的延迟和成本将降低 90%。
避坑指南:不要在上下文的开头放置“当前时间”或“随机数”,这会导致缓存失效。将动态变化的信息放在上下文的最末尾。
典型工作流示例:重构一个 API 模块
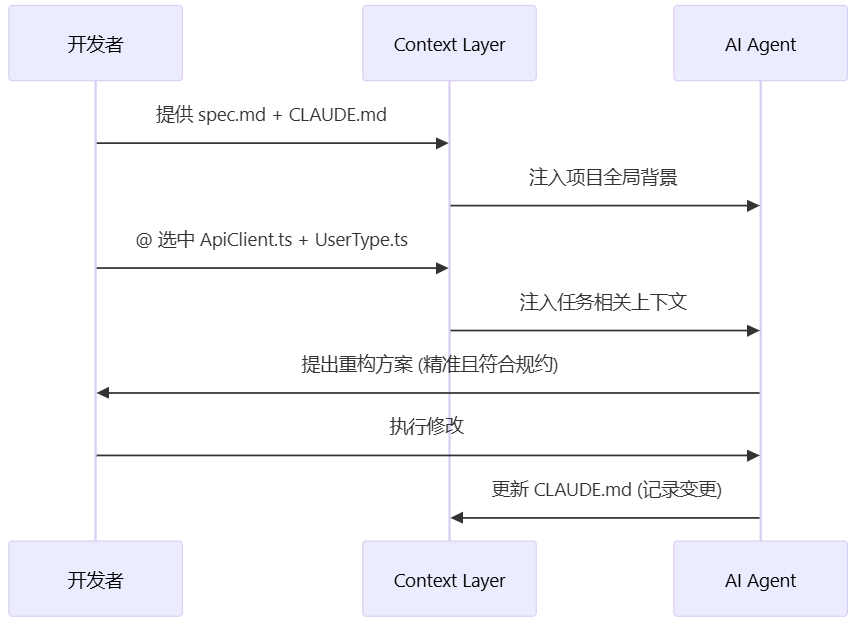
常见错误与治理
总结
Context Engineering 的本质是信息密度的管理。一个优秀的上下文工程师知道什么时候该给 AI “投喂”海量数据,什么时候该给它“精简”到极致。
掌握了上下文工程,你就能让 AI 像你的“数字双胞胎”一样工作。