【2026最新】上下文工程:从提示词到完整上下文栈的11步指南
提示工程已成过去。2026年那些正在交付最优秀智能体的工程师们谈论的是上下文:哪些数据以何种顺序、在何时输入模型。Karpathy 对此作出了界定,Anthropic 则用实践加以证明。然而,大多数人却错失了这一转变。
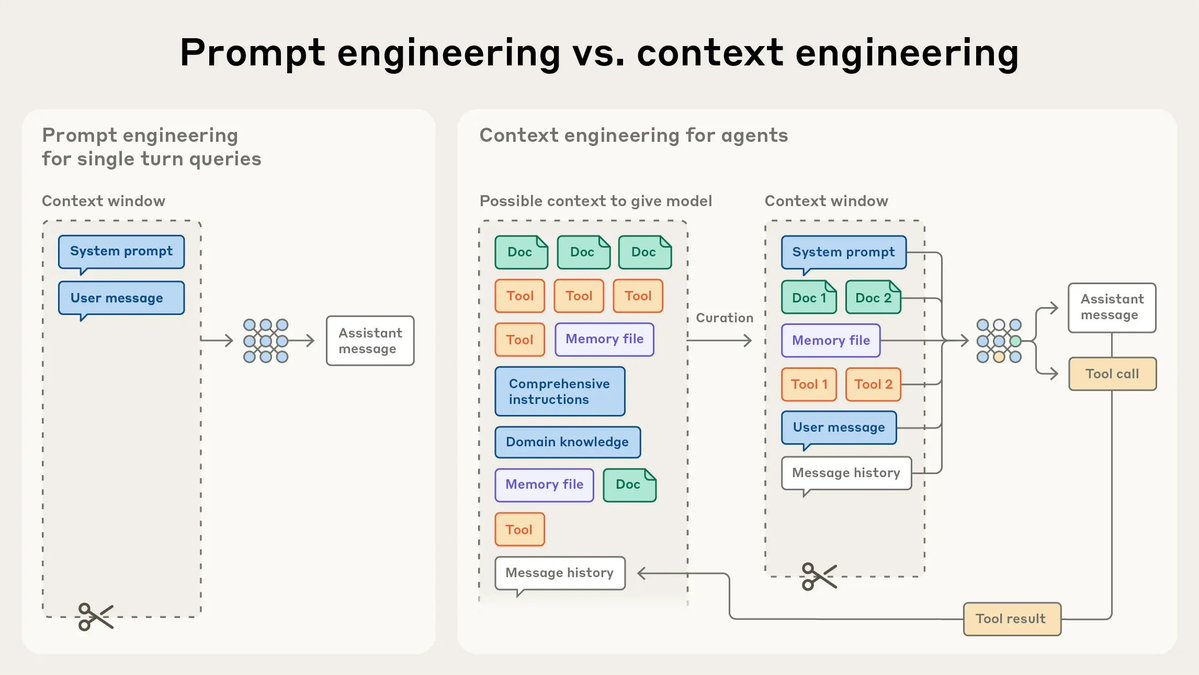
这是一份包含11个步骤的指南,带你从撰写提示词到构建完整的上下文栈。
01. 什么是上下文工程
Karpathy 的定义: 上下文工程是"一门精妙的艺术与科学,旨在为下一步操作恰到好处地填充上下文窗口。"
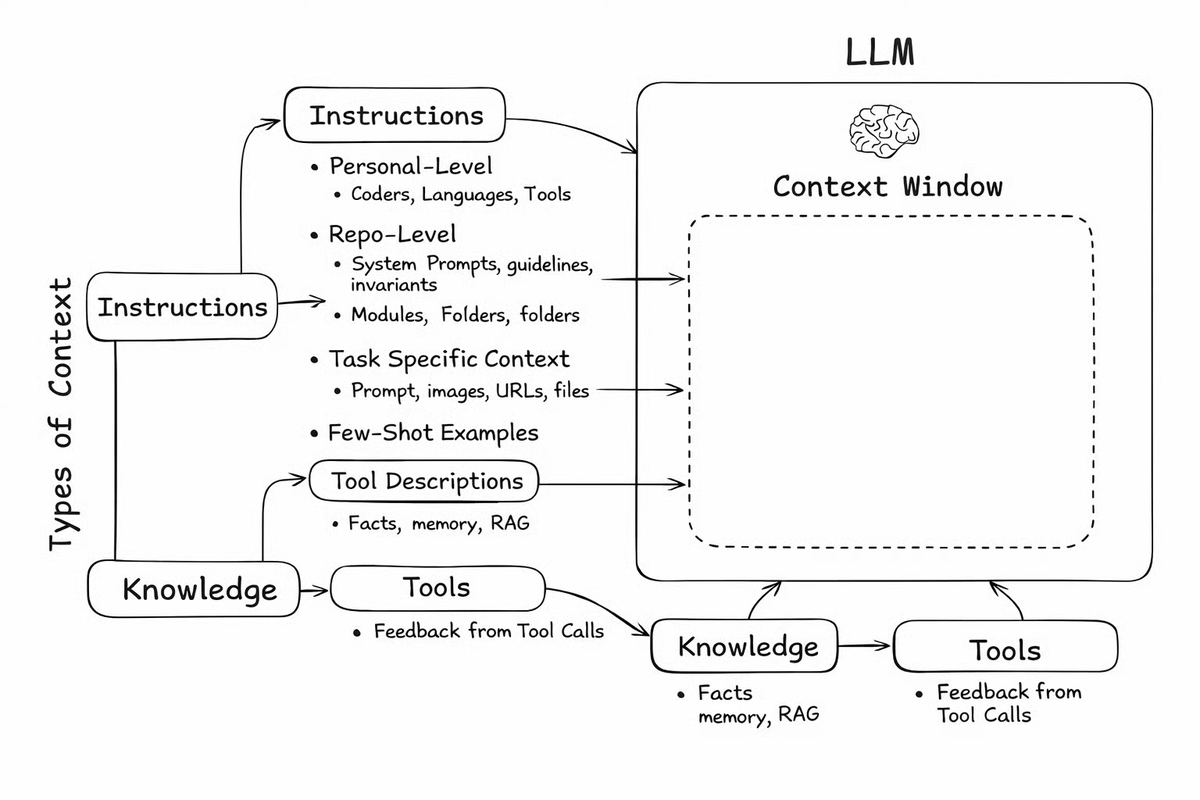
一个让人豁然开朗的类比:大语言模型相当于 CPU,而上下文窗口则相当于内存。每当你发送一条消息时,模型并不会"记住"任何内容,而是从头到尾读取整个上下文窗口,对其进行处理后生成回复。
作为工程师,你的工作就是进行操作系统管理:在每次推理步骤开始前,将正确的数据加载到工作内存中。
🧩
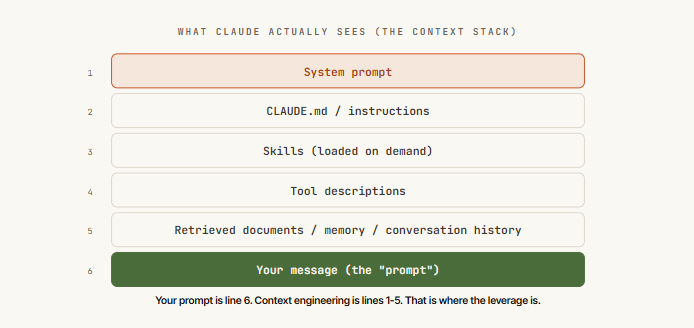
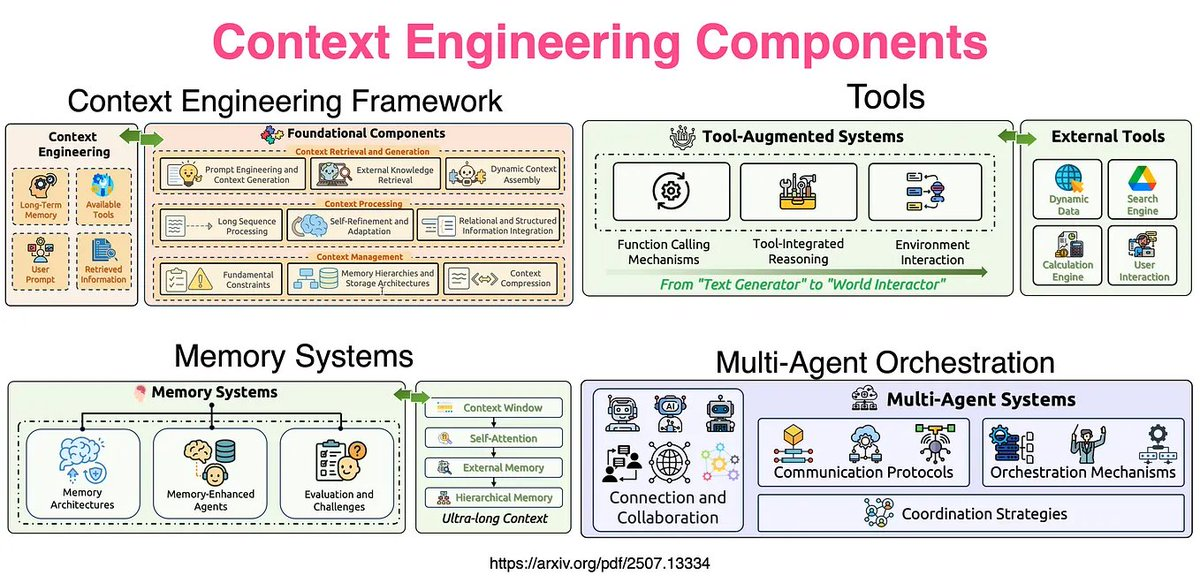
提示工程的核心在于撰写一条优质的指令。而上下文工程则关乎设计模型在生成首个标记之前所看到的所有内容——系统提示、检索到的文档、工具说明、对话历史、技能、记忆文件、示例——所有这些。在那一堆信息中,提示往往只占一行,而且通常是最不重要的一行。
02. 80%的削减
2026年7月24日,Anthropic 公司的 Thariq Shihipar 发表了《Claude 5 生成模型的上下文工程新规则》。
🧩
关键发现: Claude Code 团队在编码评估中,将 Opus 5 和 Fable 5 的系统提示词长度削减了80%以上,且性能未出现任何下降。
800个token缩水至164个。那些耗费数月才积累起来的指令不仅毫无必要,反而有害无益。Thariq 用一个词来描述这种状况:"去束缚化"(De-shackling)。旨在防止旧型号出现故障的约束措施,如今却产生了相互冲突的指令,并抑制了新型号的性能。
•
旧版提示规则: "默认不写注释。绝不编写多段落的文档字符串。"
•
新版本: "编写代码时,使其读起来与周围代码一致:在注释密度、命名风格和惯用法等方面保持一致。"
一条规则,适用范围更广。具体细节由模型根据代码库自身自动推导得出。
如果 Anthropic 自家的系统提示词有80%都是冗余无用的,那么你的也几乎肯定如此。
Anthropic 为此打造了一款工具:Claude Code 中的 /doctor 命令。它会审核您的指令,并识别出在较新模型中已不再需要的规则。在添加更多规则之前先运行它。
03. 这六项转变
Thariq 的帖子记录了 Anthropic 在为 Claude 5 模型构建上下文时所作出的六项具体调整。每一项转变都与六个月前被视为最佳实践的做法背道而驰。
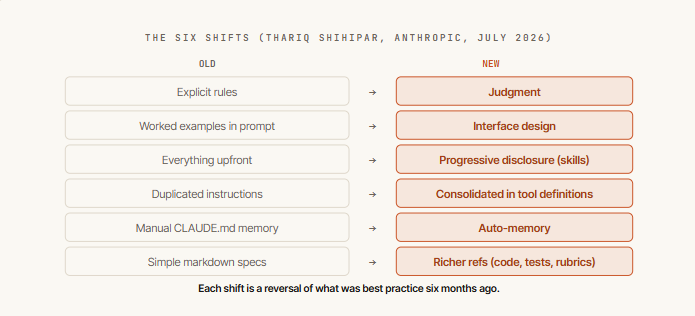
贯穿始终的主线: 赋予 Claude 更多自主权,减少事无巨细的指令。旧版模型则需要每一条规则都详尽说明。较新的模型在你描述目标并让它们自行规划路径时表现更佳。如今过度指定反而会显著降低性能。
04. 系统提示:精简,而非冗长
旧有的建议是"把所有内容都写进系统提示中"。而新规则是:系统提示应尽量简洁。只需明确角色、输出格式和边界,其他一概不提。
其他所有内容都应放入 CLAUDE.md、技能说明或工具描述中,以便按需加载,而无需在每次调用时都消耗 token。
🧩
Thariq 的框架: 轻量级提示、厚重的产物与上下文,以及精简的技能。系统提示是其中最轻薄的一层。周边上下文(CLAUDE.md、检索到的文档、代码示例)最为厚重。而技能则较为轻薄,因为它们仅在需要时才会被加载。
对比示例
旧版:800 tokens 的规范性规则
代码块
Plain Text
You are a coding assistant. When writing code:
- Default to writing no comments
- Never write multi-paragraph docstrings
- Use snake_case for variables
- Prefer list comprehensions over loops
- Always add type hints
- Never use print() for debugging
- ... (30 more rules)
新版:164 tokens 的判断力
代码块
Plain Text
旧版提示词在30种特定情况下告诉 Claude 该怎么做。新版提示词则只向 Claude 说明一次原则,并信任它能将这一原则应用于所有情况。所需 token 更少,效果更好。
05. CLAUDE.md 和技能
🧩
•
CLAUDE.md 是您项目的持久化上下文。Claude Code 会在每次会话开始时读取它。您的架构决策、命名规范、已知问题、构建命令等,只需编写一次,即可永久查阅。
•
技能是按需加载的可重用工作流。与 CLAUDE.md 的区别在于:技能仅在相关时才会被加载。
如果您具备"部署到生产环境"这一技能,而您正在修复一个 CSS 错误,那么该技能将保持未加载状态。这正是渐进式披露的体现:仅向 Claude 提供当前任务所需的相关上下文,而非所有可能的任务信息。
CLAUDE.md 示例
代码块
Markdown
# Project: E-commerce API
Python 3.12, FastAPI, PostgreSQL 16, Redis
06. 将工具说明作为上下文
大多数人认为工具描述是元数据,但事实并非如此。工具描述本身就是语境。
Claude 在决定使用哪款工具以及如何使用之前,会仔细阅读每一份工具说明。描述含糊不清,就会导致误判;描述精准,则能确保判断无误。Thariq 的六项调整之一:将操作指令从系统提示中移至工具描述中。
如果某条规则仅在调用特定工具时生效,请将其置于该工具的说明中,而非系统提示中,以免在每次调用时都消耗 token。
对比示例
差劲的做法:模糊的描述,规则在系统提示中
代码块
JSON
{"name": "run_query", "description": "Run a database query"}
优秀的做法:精确的描述,规则在工具本身
代码块
JSON
{
"name": "run_query",
"description": "Execute a read-only SQL query against the PostgreSQL database. SELECT only. Never INSERT, UPDATE, or DELETE. Results are returned as JSON rows. Maximum 1000 rows per query. If you need more, paginate with LIMIT/OFFSET. The database uses UTC timestamps."
}
"绝不执行 INSERT、UPDATE 或 DELETE"这条规则过去曾显示在系统提示中,如今则移至工具说明中。该规则仅在工具可用时才会加载,当工具未启用时不会浪费任何 token。
07. 动态上下文:检索与渐进式披露
静态上下文(系统提示、CLAUDE.md)每次都会加载。而动态上下文则根据任务需求即时加载。
这就是在确保上下文窗口保持精简的同时,仍让 Claude 能够访问大型知识库的方法。
🧩
08. 记忆:学习成果、自动记忆、状态文件
记忆是随着时间不断积累的上下文。没有它,每一次会话都从零开始。智能体将重新发现你的习惯、重新学习你的小癖好,并重蹈昨日所犯的错误。
三种记忆机制
1. 学习记录文件(learnings.md)
这是一份持续更新的错误与修复日志,智能体会在每次会话开始时读取。当某个错误出现三次后,您便将其提升为 CLAUDE.md 中的永久规则。
2. 自动记忆
Thariq 的六大模式之一:较新的 Claude 模型支持自动记忆整合。模型无需手动记录学习内容,而是通过 Anthropic 的 Dreaming 记忆功能,在多轮对话中自动捕捉上下文信息。从手动到自动的转变。
3. 状态文件
对于智能体循环,这是一个记录发生情况的 JSON 文件:包括尝试、成功、失败以及下一步操作。智能体在每次运行开始时读取该文件。第50次运行将从第49次运行中断的地方继续,而不是从头开始。
代码块
Markdown
# learnings.md - accumulated context
- Payment API expects idempotency key in header, not body.
Three agents hit this independently. Now a hard rule.
- PostgreSQL NOTIFY needs explicit LISTEN in connection pool.
Default pool settings drop the channel after 30s.
- Rate limiter counts per-key, not per-IP.
🧩
复利效应: 每一次学习记录都会让下一次的投入更加高效。首次使用:20分钟用于探索你的项目;第50次使用:只需30秒即可重温已积累的背景信息。
09. 四种故障模式
当 Claude 生成的输出质量不佳时,问题几乎总是出在四种上下文故障之一。诊断出是哪一种,就能避免在提示本身并非问题的情况下重新编写提示。
| | |
| | |
| | |
| | |
| | |
10. 上下文审计
如果您拥有一份 CLAUDE.md 文件、一条系统提示,或一个专为 Claude 3 或 Claude 4 模型构建的技能库,那么它们都带有旧版的权重。
曾经用于防范最坏情况的指令,如今却为更强大的模型带来了相互矛盾的指导。
🧩
审计流程: 将所有"核实""再核对""再次核实""务必确保""切记"之类的指令,从你的上下文堆栈中逐一移除。对于每一条规则,都请自问:Claude 5 是否仍然需要这条规则,还是它已默认具备相应功能?若答案是"默认具备",则删除该规则。此举既耗费 token,又徒增冲突风险,毫无益处。
上下文审计清单
代码块
Markdown
11. 更丰富的参考文献
Thariq 六个转变中的最后一个:用更丰富的参考资料取代简单的标记规范。
与其用文字描述输出格式,不如直接给 Claude 展示实际的产物。与其在提示中写测试标准,不如直接指向测试套件;与其解释代码风格,不如让 Claude 去阅读整个代码库。
这正是 Karpathy 所倡导的"软件3.0"的实践:上下文窗口就是程序本身。 你加载到其中的代码、测试用例和评价标准,就是你的源代码;而大型语言模型则负责对它们进行解读。
对比示例
之前:描述格式
代码块
Plain Text
Write a report with an executive summary (2 paragraphs),
three findings (each with a heading, 2-3 paragraphs,
and a supporting data point), and a conclusion with
three actionable recommendations.
之后:展示格式
代码块
Plain Text
Here is a report we published last quarter that matches
the format and quality bar we want:
[actual report pasted or @-mentioned]
一个真实的示例胜过十段格式说明。 模型会从该示例中进行模式匹配。这比解析你对所需内容的书面描述更快、更便宜、也更准确。
五种上下文工程中的常见错误
| |
| |
| |
| |
| |
| |
结论
提示从来就不是变量。上下文才是。
过去两年,人工智能行业一直在优化提示词。"一步一步思考""你是一名资深工程师""表达要简洁"——这些技巧只能让效果提升5%到10%。而上下文工程则能将效果提升2到3倍。
Karpathy 曾对此作出定义。Anthropic 通过删除自身80%的指令加以证明。对所有人而言,模型都是相同的。真正变化的是上下文——系统提示、CLAUDE.md、技能、工具描述、检索到的文档、记忆、示例以及状态等要素。那就是你的程序。大型语言模型只是对其进行解释。
那些真正理解这一点的工程师正在打造切实有效的智能体;而那些仍在反复修改提示词的人,其实是在调试错误的层面。
大语言模型就是CPU,上下文窗口就是内存。你的任务不是写出更好的指令,而是要在恰当的时机加载恰当的数据。