上下文工程完全指南:提示词工程的演进之路
💡
在 AI 2.0 时代,“你问什么”不再是关键,“你让 AI 看到什么”才是核心。 Context Engineering (上下文工程) 是 2025-2026 年 AI 领域的重大范式跃迁。本文将带你理解从“提示词调优”到“动态上下文管理”的进化之路,教你如何利用有限的 Token 窗口,构建无限的 AI 生产力。
引言:Prompt Engineering 的消亡
在 2023 年,我们还在学习如何使用“请你扮演一个资深架构师”或者“一步步思考”这样的 Prompt 技巧。但到了 2026 年,随着 Anthropic、OpenAI 和 Google 模型的进化,模型对自然语言指令的理解已经趋于完美。
提示词(Prompt)本身正在变得越来越廉价,而高质量、精准的上下文(Context)却变得空前昂贵。
Gartner 在 2025 年的报告中指出:
"The center of gravity in AI development has shifted from writing better prompts to engineering better contexts." (AI 开发的重心已从编写更好的提示词转移到工程化更好的上下文。)
什么是 Context Engineering?
核心定义
Context Engineering 是通过算法和工程手段,动态选择、组织和优化输入给 LLM 的背景信息,以确保模型在特定的 Token 限制下产出最高质量、最符合预期的结果。
如果把 LLM 比作一个超级大脑,那么:
•
Prompt Engineering 是你对他下达的命令。
•
Context Engineering 是你递给他的那叠卷宗和资料。
进化的三个阶段
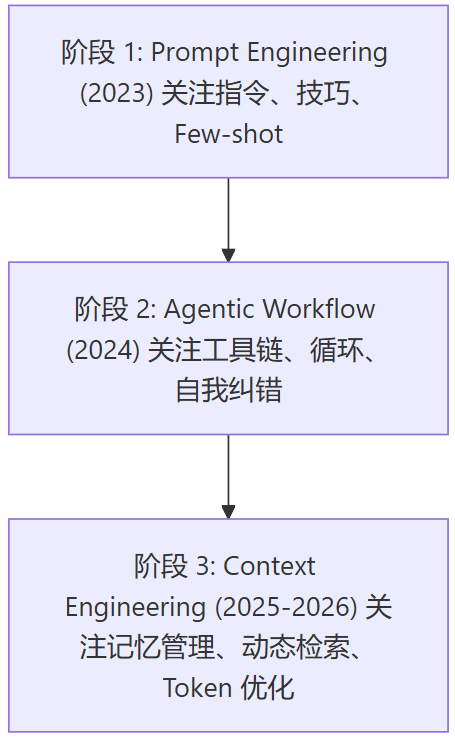
Context Engineering 的四大核心策略
为了让 AI Agent 表现卓越,我们需要在工程层面对上下文进行“四位一体”的管理:
选择 (Selection)
并不是所有的背景信息都有用。Context Engineering 需要根据当前的 Task 意图,从海量数据中挑选出最相关的部分。
•
关联代码片段:不仅仅是搜索文件名,还要包含引用链上的相关类。
•
元数据注入:注入项目的技术栈信息、版本号、以及当前的系统负载。
检索 (Retrieval)
超越基础的向量搜索(RAG)。
•
混合检索 (Hybrid Search):结合关键词和语义向量。
•
重排序 (Re-ranking):先检索出 100 条,再用轻量级模型选出最相关的 5 条。
压缩 (Compression)
在 200k 甚至 2M 的长上下文时代,我们依然需要压缩。
•
语义总结:将冗长的对话历史总结为几个核心要点。
•
关键信息提取:去除 HTML 标签或冗余的日志信息,只保留业务逻辑。
持久化 (Persistence)
通过 CLAUDE.md 或类似的机制,将项目的核心决策持久化。这样,无论对话进行到多少轮,AI 始终知道“我们的编码规约是什么”。
Prompt vs. Context Engineering:对比分析
#pwRlQQOEHTmi text { white-space: pre; }#pwRlQQOEHTmi .fb0 { stroke: var(--N900-FG, 0.15); }#pwRlQQOEHTmi .fb0 {stroke: rgba(31,35,41, 0.15)}#pwRlQQOEHTmi .fx0 { stroke-miterlimit: 10; }#pwRlQQOEHTmi .fx0 {stroke-miterlimit: 10}#pwRlQQOEHTmi .fa1 { fill: rgb(187, 191, 196); }#pwRlQQOEHTmi .fa1 {fill: rgb(187, 191, 196)}#pwRlQQOEHTmi .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#pwRlQQOEHTmi .fx1 {font-style: normal}#pwRlQQOEHTmi .fx2 { text-anchor: middle; }#pwRlQQOEHTmi .fx2 {text-anchor: middle}#pwRlQQOEHTmi .fx3 { dominant-baseline: central; }#pwRlQQOEHTmi .fx3 {dominant-baseline: central}#pwRlQQOEHTmi .fx4 { stroke: none; }#pwRlQQOEHTmi .fx4 {stroke: none}#pwRlQQOEHTmi .fc0 { fill: var(--text-caption); }#pwRlQQOEHTmi .fc0 {fill: #646a73}#pwRlQQOEHTmi .fa2 { fill: var(--text-link-disabled); }#pwRlQQOEHTmi .fa2 {fill: rgb(187, 191, 196)}#pwRlQQOEHTmi .fa3 { fill: rgb(31, 35, 41); }#pwRlQQOEHTmi .fa3 {fill: rgb(31, 35, 41)}#pwRlQQOEHTmi .fx5 { font: 400 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#pwRlQQOEHTmi .fx5 {font-style: normal}#pwRlQQOEHTmi .fx6 { text-anchor: start; }#pwRlQQOEHTmi .fx6 {text-anchor: start}#pwRlQQOEHTmi .fx7 { dominant-baseline: alphabetic; }#pwRlQQOEHTmi .fx7 {dominant-baseline: alphabetic}#pwRlQQOEHTmi .fc1 { fill: rgb(255, 255, 255); }#pwRlQQOEHTmi .fc1 {fill: rgb(255, 255, 255)}#pwRlQQOEHTmi .fx8 { font: 700 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#pwRlQQOEHTmi .fx8 {font-style: normal}#pwRlQQOEHTmi .fc2 { fill: rgb(51, 51, 51); }#pwRlQQOEHTmi .fc2 {fill: rgb(51, 51, 51)}#pwRlQQOEHTmi .fb1 { fill: var(--N900-FG, 0.15); }#pwRlQQOEHTmi .fb1 {fill: rgba(31,35,41, 0.15)}#pwRlQQOEHTmi .fb2 { fill: rgb(225, 228, 232); }#pwRlQQOEHTmi .fb2 {fill: rgb(225, 228, 232)}#pwRlQQOEHTmi .fa4 { fill: var(--bg-body); }#pwRlQQOEHTmi .fa4 {fill: #fff}ABC123456特性Prompt EngineeringContext Engineering关注点主要挑战解决手段模型依赖代表技术指令格式、语气、Few-shot 模板模型对指令的敏感度 (Brittle)编写更精细的文本高度依赖特定模型对 Prompt 的响应Chain-of-Thought (CoT)背景数据、检索精度、信息密度Token 窗口限制、检索噪音、延迟向量数据库、重排序算法、图谱检索更加通用,关注输入数据的“营养价值”RAG, Memory Management, Prompt Caching
Context Engineering 的核心组件
系统提示词 (System Prompt):定义 AI 的“灵魂”和基本行为准则。
工作记忆 (Working Memory):当前对话的短期历史。
长期记忆 (Long-term Memory):存储在数据库中的项目知识、用户偏好。
环境上下文 (Environmental Context):当前的操作系统信息、文件树结构、API 响应结果。
常见问题 (FAQ)
Context Engineering 与 Prompt Engineering 有什么区别?
Prompt Engineering 专注于写出更好的“指令(Instructions)”,而 Context Engineering 专注于提供最相关的“背景信息(Background Information)”。在 2026 年,随着模型推理能力的提升,指令变得越来越不重要,而上下文的质量成为了决定高质量输出的核心变量。
RAG 和 Context Engineering 的关系是什么?
RAG(检索增强生成)是 Context Engineering 的一个子集。Context Engineering 不仅包含检索,还包含动态的上下文选择、关键信息的压缩、多轮对话中的记忆持久化,以及 Token 窗口的最优分配。
长上下文导致的延迟(Latency)问题如何解决?
策略包括:1. 上下文压缩:只提取关键语义信息;2. 分层检索:先检索粗粒度信息,需要时再检索细节;3. Prompt Caching(提示词缓存):重用已处理的上下文,大幅降低首字延迟(TTFT)和成本。
为什么说 CLAUDE.md 是 Context Engineering 的一种实践?
因为 CLAUDE.md 将项目的“长期记忆”显式化,并放置在上下文窗口中。这使得 AI 能够基于全局架构和约定做出决策,防止了信息在长对话历史中丢失。
结论:上下文作为一种资产
在 2026 年,一个成功的 AI 应用的核心竞争力不再是它使用的模型(因为模型正在趋同),而是它的 Context Engineering 能力。谁能为 AI 提供最干净、最相关、最有逻辑的上下文,谁就能取得更优的结果。