上下文窗口与Token完全指南:LLM分词原理、计数方法与成本优化策略
核心摘要
Token是大语言模型处理文本的基本单位,上下文窗口决定了模型一次能处理的最大Token数量。本指南详细介绍Token化过程、主流分词算法(BPE、WordPiece、SentencePiece)、各模型上下文窗口对比、长上下文技术(RoPE、ALiBi),以及Token计数和成本优化的实用策略。
引言
当你使用ChatGPT、Claude或其他大语言模型时,是否好奇过:为什么有时候对话会被截断?为什么中文和英文的"长度"计算不一样?为什么API调用费用难以预估?
这些问题的答案都与两个核心概念相关:Token和上下文窗口(Context Window)。理解它们不仅能帮助你更高效地使用AI工具,还能显著降低API调用成本。
在本指南中,你将学到:
•
Token的定义和Token化过程
•
BPE、WordPiece、SentencePiece等分词算法的原理
•
什么是上下文窗口及其重要性
•
主流大模型的上下文窗口大小对比
•
长上下文技术:RoPE、ALiBi、Sliding Window
•
如何计算Token数量和估算成本
•
优化上下文使用的实用策略
什么是Token
Token是大语言模型处理文本的最小单位。在模型眼中,文本不是字符或单词的序列,而是Token的序列。
Token与字符、单词的区别
#evbhMWeLMlAc text { white-space: pre; }#evbhMWeLMlAc .fb0 { stroke: var(--N900-FG, 0.15); }#evbhMWeLMlAc .fb0 {stroke: rgba(31,35,41, 0.15)}#evbhMWeLMlAc .fx0 { stroke-miterlimit: 10; }#evbhMWeLMlAc .fx0 {stroke-miterlimit: 10}#evbhMWeLMlAc .fa1 { fill: rgb(187, 191, 196); }#evbhMWeLMlAc .fa1 {fill: rgb(187, 191, 196)}#evbhMWeLMlAc .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#evbhMWeLMlAc .fx1 {font-style: normal}#evbhMWeLMlAc .fx2 { text-anchor: middle; }#evbhMWeLMlAc .fx2 {text-anchor: middle}#evbhMWeLMlAc .fx3 { dominant-baseline: central; }#evbhMWeLMlAc .fx3 {dominant-baseline: central}#evbhMWeLMlAc .fx4 { stroke: none; }#evbhMWeLMlAc .fx4 {stroke: none}#evbhMWeLMlAc .fc0 { fill: var(--text-caption); }#evbhMWeLMlAc .fc0 {fill: #646a73}#evbhMWeLMlAc .fa2 { fill: var(--text-link-disabled); }#evbhMWeLMlAc .fa2 {fill: rgb(187, 191, 196)}#evbhMWeLMlAc .fa3 { fill: rgb(31, 35, 41); }#evbhMWeLMlAc .fa3 {fill: rgb(31, 35, 41)}#evbhMWeLMlAc .fx5 { font: 400 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#evbhMWeLMlAc .fx5 {font-style: normal}#evbhMWeLMlAc .fx6 { text-anchor: start; }#evbhMWeLMlAc .fx6 {text-anchor: start}#evbhMWeLMlAc .fx7 { dominant-baseline: alphabetic; }#evbhMWeLMlAc .fx7 {dominant-baseline: alphabetic}#evbhMWeLMlAc .fc1 { fill: rgb(255, 255, 255); }#evbhMWeLMlAc .fc1 {fill: rgb(255, 255, 255)}#evbhMWeLMlAc .fc2 { fill: rgb(51, 51, 51); }#evbhMWeLMlAc .fc2 {fill: rgb(51, 51, 51)}#evbhMWeLMlAc .fb1 { fill: var(--N900-FG, 0.15); }#evbhMWeLMlAc .fb1 {fill: rgba(31,35,41, 0.15)}#evbhMWeLMlAc .fb2 { fill: rgb(225, 228, 232); }#evbhMWeLMlAc .fb2 {fill: rgb(225, 228, 232)}#evbhMWeLMlAc .fa4 { fill: var(--bg-body); }#evbhMWeLMlAc .fa4 {fill: #fff}ABC1234概念定义示例字符单词Token最小的文本单位由空格分隔的文本模型处理的基本单位H, e, l, l, oHello, worldHello, wor, ld
Token的粒度介于字符和单词之间。常见单词通常是一个Token,而罕见词或长词会被拆分成多个Token。
为什么使用Token而非单词
词汇表大小可控:英语有数十万单词,而Token词汇表通常只有3-5万
处理未知词:任何文本都能被分解为已知Token的组合
跨语言支持:同一分词器可以处理多种语言
子词共享:相关词汇共享子词Token,如"run"、"running"、"runner"
Token化过程详解
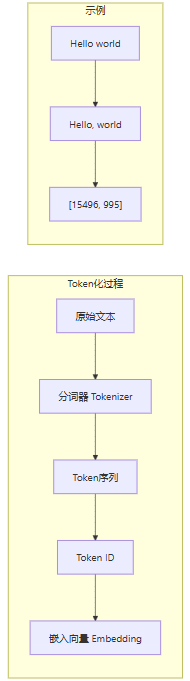
Token化(Tokenization)是将原始文本转换为Token序列的过程。
代码块
Python
import tiktoken
enc = tiktoken.encoding_for_model("gpt-4")
text = "Hello, world! 你好,世界!"
tokens = enc.encode(text)
print(f"原始文本: {text}")
print(f"Token数量: {len(tokens)}")
print(f"Token ID: {tokens}")
print(f"解码后: {[enc.decode([t]) for t in tokens]}")
输出示例:
代码块
Plain Text
原始文本: Hello, world! 你好,世界!
Token数量: 11
Token ID: [9906, 11, 1917, 0, 220, 57668, 53901, 3922, 244, 98220, 6447]
解码后: ['Hello', ',', ' world', '!', ' ', '你好', ',', '世', '界', '!']
不同语言的Token效率
中文和英文的Token效率差异显著:
代码块
Python
一般来说,英文约4个字符对应1个Token,而中文约1.5-2个字符对应1个Token。
主流分词算法
BPE(Byte Pair Encoding)
BPE是GPT系列模型使用的分词算法,通过迭代合并最频繁的字符对来构建词汇表。
代码块
Python
def simple_bpe_demo():
"""简化的BPE演示"""
corpus = ["low", "lower", "newest", "widest"]
BPE的优点:
•
平衡了字符级和单词级分词的优缺点
•
能有效处理未知词
•
词汇表大小可控
WordPiece
WordPiece是BERT使用的分词算法,与BPE类似但使用不同的合并策略。
代码块
Python
from transformers import BertTokenizer
tokenizer = BertTokenizer.from_pretrained('bert-base-uncased')
text = "unbelievable"
tokens = tokenizer.tokenize(text)
print(f"WordPiece分词: {tokens}")
WordPiece使用##前缀标记非首字符的子词Token。
SentencePiece
SentencePiece是一种语言无关的分词工具,将文本视为Unicode字符序列处理。
代码块
Python
SentencePiece的特点:
•
不依赖预分词(如空格分割)
•
支持BPE和Unigram两种算法
•
广泛用于多语言模型
什么是上下文窗口
上下文窗口(Context Window)是大语言模型一次能处理的最大Token数量。它决定了模型能"看到"多少信息。
上下文窗口的组成
上下文窗口包含所有输入和输出Token:
系统提示(System Prompt):定义模型行为的指令
对话历史:之前的对话轮次
用户输入:当前的问题或请求
模型输出:模型生成的回复
为什么上下文窗口很重要
主流模型上下文窗口对比
上下文窗口vs实际可用长度
需要注意的是,标称的上下文窗口大小并不等于实际可用长度:
代码块
Python
def calculate_available_context(total_window, system_prompt_tokens,
history_tokens, max_output_tokens):
"""计算实际可用的输入Token数"""
available = total_window - system_prompt_tokens - history_tokens - max_output_tokens
return max(0, available)
total = 128000
system = 500
history = 10000
长上下文技术
随着对长上下文需求的增加,研究者开发了多种技术来扩展模型的上下文处理能力。
RoPE(旋转位置编码)
RoPE通过旋转矩阵编码位置信息,支持位置外推。
代码块
Python
RoPE的优势:
•
相对位置信息自然编码
•
支持长度外推
•
计算效率高
ALiBi(Attention with Linear Biases)
ALiBi通过在注意力分数中添加线性偏置来编码位置信息。
代码块
Python
def alibi_bias(seq_len, num_heads):
Sliding Window Attention
滑动窗口注意力限制每个Token只关注固定范围内的Token,降低计算复杂度。
Token计数与成本估算
准确计算Token数量对于成本控制至关重要。
使用tiktoken计算Token
代码块
Python
import tiktoken
def count_tokens(text, model="gpt-4"):
"""
Token计数工具类
代码块
Python
class TokenCounter:
"""Token计数和成本估算工具"""def __init__(self, model="gpt-4"):
self.model = model
try:
self.encoding = tiktoken.encoding_for_model(model)
except KeyError:
self.encoding = tiktoken.get_encoding("cl100k_base")
def count(self, text):
"""计算Token数量"""return len(self.encoding.encode(text))
def count_messages(self, messages):
"""计算对话消息的Token数量"""
total = 0for message in messages:
total += 4for key, value in message.items():
total += self.count(value)
if key == "name":
total += -1
优化上下文使用的策略
精简系统提示
代码块
Python
verbose_prompt = """
你是一个非常有帮助的AI助手。你的任务是帮助用户解答各种问题。
你应该始终保持友好、专业的态度。当用户提问时,你需要仔细分析问题,
然后给出详细、准确的回答。如果你不确定答案,请诚实地告诉用户。
"""
concise_prompt = """
你是专业的AI助手。提供准确、简洁的回答。不确定时如实说明。
对话历史管理
代码块
Python
def manage_conversation_history(messages, max_tokens, counter):
"""
管理对话历史,保持在Token限制内
策略:保留系统消息和最近的对话
"""
system_messages = [m for m in messages if m.get("role") == "system"]
other_messages = [m for m in messages if m.get("role") != "system"]
system_tokens = counter.count_messages(system_messages)
available_tokens = max_tokens - system_tokens
文档分块策略
代码块
Python
def smart_chunk_document(text, max_chunk_tokens=1000, overlap_tokens=100):
"""
智能文档分块:在句子边界处分割
"""import re
counter = TokenCounter()
sentences = re.split(r'(?<=[。!?.!?])\s*', text)
使用摘要压缩历史
代码块
Python
def compress_history_with_summary(messages, summarizer_fn, threshold_tokens=2000):
"""
当历史过长时,使用摘要压缩早期对话
"""
counter = TokenCounter()
total_tokens = counter.count_messages(messages)
if total_tokens <= threshold_tokens:
return messages
system_msgs = [m for m in messages if m["role"] == "system"]
other_msgs = [m for m in messages if m["role"] != "system"]
split_point = len(other_msgs) // 2
old_msgs = other_msgs[:split_point]
recent_msgs = other_msgs[split_point:]
总结
理解Token和上下文窗口是高效使用大语言模型的基础:
Token是LLM的基本单位:不同于字符或单词,Token由分词算法决定
分词算法各有特点:BPE、WordPiece、SentencePiece适用于不同场景
上下文窗口限制总Token数:包括输入、输出和对话历史
长上下文技术不断发展:RoPE、ALiBi等技术扩展了模型能力
成本优化需要精确计数:使用tiktoken等工具准确估算
多种策略可优化使用:精简提示、管理历史、智能分块
掌握这些知识,你就能更好地控制API成本,设计更高效的AI应用。
常见问题
为什么中文消耗的Token比英文多?
这与分词算法的训练数据有关。GPT等模型主要在英文语料上训练,英文常见词通常是单个Token,而中文字符往往需要多个Token表示。例如,"人工智能"可能需要3-4个Token,而"AI"只需要1个Token。使用针对中文优化的模型(如Qwen)可以提高中文Token效率。
上下文窗口越大越好吗?
不一定。更大的上下文窗口意味着:1)更高的API成本(按Token计费);2)更长的响应时间;3)可能的注意力分散(模型可能难以聚焦关键信息)。应根据实际需求选择合适大小的上下文窗口,并使用检索增强生成(RAG)等技术优化信息利用。
如何估算一段文本的Token数量?
最准确的方法是使用对应模型的分词器。对于OpenAI模型,使用tiktoken库;对于其他模型,使用相应的tokenizer。粗略估算时,英文约4个字符=1个Token,中文约1.5-2个字符=1个Token。在线工具如OpenAI的Tokenizer也可以快速计算。
对话历史会消耗上下文窗口吗?
是的,每轮对话的输入和输出都会累积在上下文中。这就是为什么长对话可能导致早期内容被截断。建议实现对话历史管理策略:保留最近的对话、使用摘要压缩历史、或在适当时候重置上下文。
不同模型的Token是否通用?
不通用。不同模型使用不同的分词器,同一文本在不同模型中的Token数量可能不同。例如,GPT-4使用cl100k_base编码,而BERT使用WordPiece。在切换模型时需要重新计算Token数量和成本。