从热点到公众号成稿
这一篇,我拿 GLM-5.3-Flash 做了一次完整实测。直接让豆包工作而是把整篇文章的行文思路拆成四个工作流:
先做写作事实包;
再把事实包写成公众号长文;
单独做标题候选和误导风险检查;
最后根据文章和推荐标题制作封面。
别看步骤多,反而更省事。因为每一步都有上一份成果可查,后面的每一步都是前一步的结果。整个流程基本上形成了逻辑的闭环。
如何做到所有技能的最优组合
#PBzGomehOTou text { white-space: pre; }#PBzGomehOTou .fb0 { stroke: var(--N900-FG, 0.15); }#PBzGomehOTou .fb0 {stroke: rgba(31,35,41, 0.15)}#PBzGomehOTou .fx0 { stroke-miterlimit: 10; }#PBzGomehOTou .fx0 {stroke-miterlimit: 10}#PBzGomehOTou .fa1 { fill: rgb(187, 191, 196); }#PBzGomehOTou .fa1 {fill: rgb(187, 191, 196)}#PBzGomehOTou .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#PBzGomehOTou .fx1 {font-style: normal}#PBzGomehOTou .fx2 { text-anchor: middle; }#PBzGomehOTou .fx2 {text-anchor: middle}#PBzGomehOTou .fx3 { dominant-baseline: central; }#PBzGomehOTou .fx3 {dominant-baseline: central}#PBzGomehOTou .fx4 { stroke: none; }#PBzGomehOTou .fx4 {stroke: none}#PBzGomehOTou .fc0 { fill: var(--text-caption); }#PBzGomehOTou .fc0 {fill: #646a73}#PBzGomehOTou .fa2 { fill: var(--text-link-disabled); }#PBzGomehOTou .fa2 {fill: rgb(187, 191, 196)}#PBzGomehOTou .fx5 { font: 400 14px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#PBzGomehOTou .fx5 {font-style: normal}#PBzGomehOTou .fx6 { text-anchor: start; }#PBzGomehOTou .fx6 {text-anchor: start}#PBzGomehOTou .fx7 { dominant-baseline: alphabetic; }#PBzGomehOTou .fx7 {dominant-baseline: alphabetic}#PBzGomehOTou .fc1 { fill: rgb(167, 167, 167); }#PBzGomehOTou .fc1 {fill: rgb(167, 167, 167)}#PBzGomehOTou .fx8 { font: 400 14px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#PBzGomehOTou .fx8 {font-style: normal}#PBzGomehOTou .fc2 { fill: rgb(35, 35, 35); }#PBzGomehOTou .fc2 {fill: rgb(35, 35, 35)}#PBzGomehOTou .fb1 { fill: var(--N900-FG, 0.15); }#PBzGomehOTou .fb1 {fill: rgba(31,35,41, 0.15)}#PBzGomehOTou .fb2 { fill: rgba(0, 0, 0, 0.1); }#PBzGomehOTou .fb2 {fill: rgba(0, 0, 0, 0.1)}#PBzGomehOTou .fa3 { fill: var(--bg-body); }#PBzGomehOTou .fa3 {fill: #fff}ABC12345任务最终采用的组合为什么这样选动笔前核对事实把材料写成公众号长文生成标题并防止标题骗人制作公众号头图VOC 与舆情调研 + 豆包工作公开网页检索公众号图文与运营策略 + 本地事实包 + Lark Doc爆款标题与选题日历 + 已完成文章创意设计 + 豆包工作的图片生成与检查能力能同时读多来源、找冲突、留下原始链接和证据缺口写作时有明确事实边界,成稿还能继续交给编辑审核不只给标题,还逐个标记误导风险和使用场景先定概念和构图,再生成并检查比例、裁切和文字风险
它适合做增强检索,但我们的目标是让普通用户打开豆包工作就能轻松复现。如果你已经配置好密钥的话,可以把它加在第一步;没有也不影响主流程跑通。
任务一:先把事实、数字和来源找齐
很多人写科技热点的顺序是:先看到一个惊人的标题,马上开写,写到一半再找资料补洞。
这次我反过来。先不写正文,先让豆包工作交付一份“什么能写、什么不能直接写”的事实包。
第一步:找到适合做多来源核验的能力
打开左侧「技能 · 连接器 · 伙伴」,搜索「VOC 与舆情调研」。这个Skill不只是看舆情,它还支持内容筛选和原始帖子溯源,很适合拿来做写作前的资料核对。
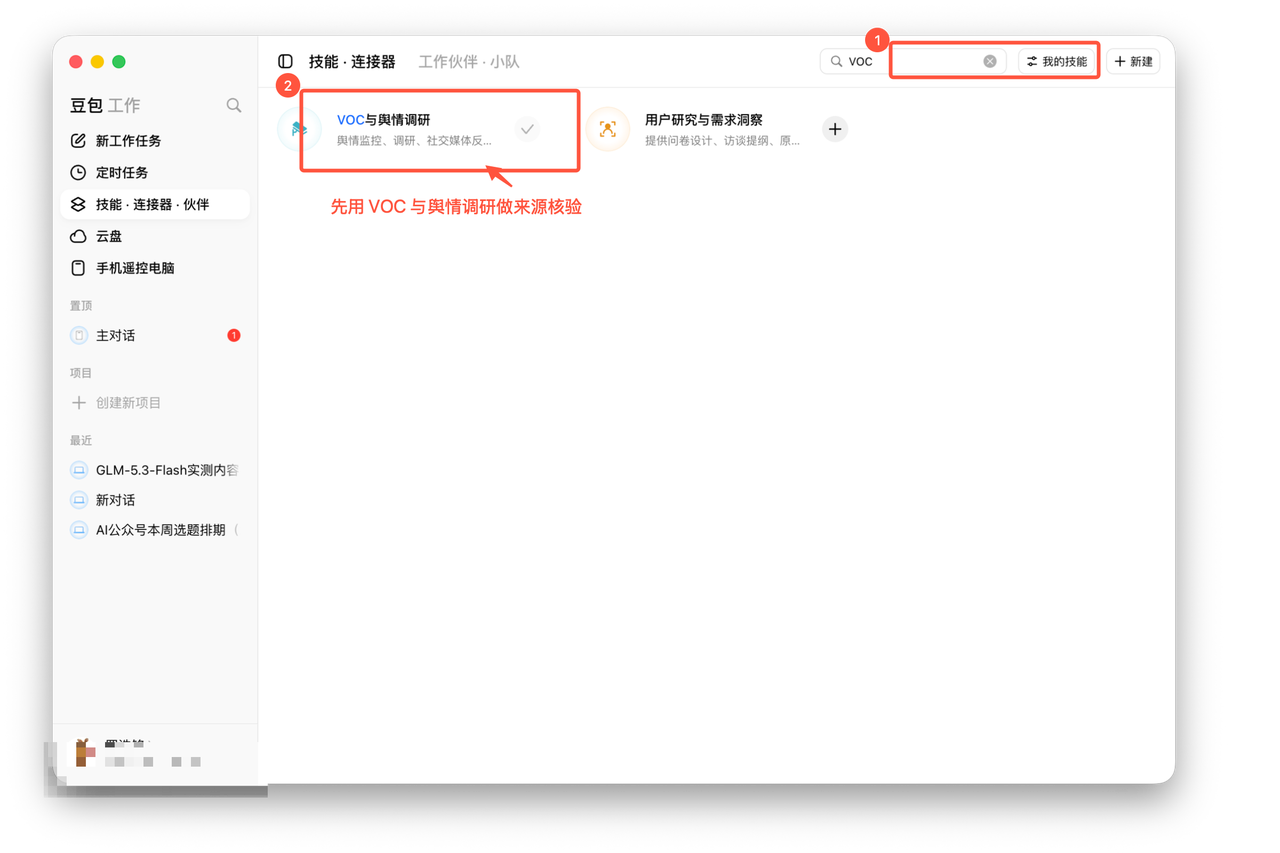
图02-01|找到事实核验能力
第二步:不要只说“帮我搜资料”
我在提示词里直接给了四个公开来源:Z.ai 官方博客、Hugging Face 模型卡、Z.ai 官方定价页和一篇 36 氪文章。同时规定了四种分类:官方可确认事实、厂商自报、媒体转述、仍缺独立证据。
提示词里最关键的部分是:
代码块
Plain Text
我是科技 / AI 类公众号编辑,准备写一篇面向普通职场人和开发者的 GLM-5.3-Flash 文章。请先制作「写作事实包」,此时不要写正文。
请优先完整读取并核验下面的公开来源:
这里有个好用的提示词习惯:不仅告诉 AI 要查什么,还要规定它怎样表达不确定性。否则它很容易把“搜索到了”误当成“已经证实”。
第三步:看它怎么处理打不开和对不上的信息源
运行后,豆包工作先完整读取官方博客,再尝试模型卡和定价页。过程中出现了两个很典型的情况:Hugging Face 页面因为安全策略无法直接抓取;官方定价页第一次访问也没有显示 Flash。
它没有悄悄跳过,而是把这种情况记录好,并继续通过缓存和多来源交叉确认。
核查事实,避免高风险说法
最终生成的事实包包含 8 个关键问题、四类事实表、传播性说法专项检查、可用案例、高风险表述和待确认清单。
它总结了三处很容易翻车的地方:
•
“价格只有 1/40”是媒体对用户价格的粗略概括,不能写成硬件成本;
•
“57 分持平”只是在特定版本的综合指数上成立,不能扩展成所有能力都一样;
•
国产芯片数量在官方英文博客和中文媒体之间存在口径差异,不能去掉来源直接下结论。
图02-04|GLM-5.3-Flash事实包
绿灯内容可以写,黄灯内容要加来源和限定,红灯内容先别碰。
以上的案例是告诉大家,我们在网上搜索到的热点信息,还需要再让 AI 去甄别一遍真假。判断事实之后,我们才能更放心地去使用那些数字、价格等信息。
任务二:公众号长文,要从材料写成一篇能读完的文章
事实包解决的是信息源的真实性和正确性,但它还不是一篇大家愿意读完的文章。
第二步要做的,是在不突破事实边界的前提下,把这些信息源变成一条自然的叙事线。
第一步:切换到公众号写作能力
回到技能页搜索「公众号图文与运营策略」。它适合生成、改写和评估公众号文章,也包含验真、结构、排版配图和运营复盘的思路。
图02-05|找到公众号写作能力
第二步:把事实包当成材料边界
这次我没有复制粘贴一大段资料,而是把刚生成的 Markdown 文件路径交给它,并明确“只使用事实包里的材料”。
提示词复制
代码块
Plain Text
请使用「公众号图文与运营策略」技能,读取这份事实包:
【素材说明】请直接上传你的事实包,或把下面路径替换成你自己的实际文件路径。
`/Users/kangarooking/Documents/my-project/doubao-baipishu/outputs/doubao-work-whitepaper/02-从事实包到公众号成稿/artifacts/GLM-5.3-Flash写作事实包.md`
基于它写一篇面向普通职场人和开发者的微信公众号长文。
图02-06|公众号长文提示词
第三步:先读材料,再规划结构
豆包工作先读取事实包,确认公众号写作和 Lark Doc 能力,再把文章定位成“专业解读 + 判断方法”。它没有从第一句话就开始写正文,而是先梳理普通职场人和开发者最关心的问题。
图02-07|事实包转文章过程
正文不再单纯列举一堆数字
成稿的结构很清楚:先解释模型是什么,再分别处理价格、能力、国产芯片和开源,最后给普通职场人和开发者两套建议。
更关键的是,事实包里的限制被保留下来了。文章没有直接写“能力等于 Opus”,只是限定在某个综合指数;没有把媒体概括的“1/40”直接当精确结论;也把国产芯片数量的口径差异明确留在正文里。
图02-08|GLM-5.3-Flash公众号成稿
任务三:想要爆款标题,但也不能纯粹的标题党
正文写得再严谨,标题也可能在最后一分钟把前面的努力全毁掉。
比如正文说的是“某个版本的综合指数拿到 57 分”,标题一压缩就容易变成“能力全面吊打”。这类标题不一定完全错,但它会把读者的期待值拉高,如果点进来看完发现落差太大,反手可能就会收到一个差评。。。
第一步:单独启用标题能力#
我选择了「爆款标题与选题日历」。原因不是它会起更多标题,而是它能把标题按类型、风险和使用场景拆开,方便编辑做选择。
图02-09|找到标题能力
第二步:把“不能怎么写”放进提示词
提示词没有只写“给我 20 个爆款标题”,而是先让它读取成稿,提炼新信息、最强证据、核心冲突和目标读者,再生成事实型、问题型、反差型、结果型各 5 个标题。
我还加了三条硬边界:不增加正文没有的数字;
可直接复制的实测提示词
代码块
Plain Text
请使用「爆款标题与选题日历」技能,读取这份文章:
【素材说明】请直接上传你的公众号成稿,或把下面路径替换成你自己的实际文件路径。
`/Users/kangarooking/Documents/my-project/doubao-baipishu/outputs/doubao-work-whitepaper/02-从事实包到公众号成稿/artifacts/GLM-5.3-Flash公众号成稿.md`
先概括文章真正的新信息、最强证据、核心冲突和目标读者,再生成 20 个标题:事实型、问题型、反差型、结果型各 5 个。
硬性边界:
- 不得加入正文没有的数字、结论、人物背书或亲测经历。
- 不用故意制造误解的半句话,不把厂商自报跑分包装成独立实测。
- 每个标题说明抓住了什么,并标记误导风险、营销强度和适合场景。
最后推荐 3 个标题,分别说明更适合公众号头条、社群转发还是搜索流量;再选出一个用于本次封面制作。把结果保存为「GLM-5.3-Flash标题候选与风险表.md」。未经确认,不发布、不发送消息、不修改线上文档。
图02-10|标题生成提示词
第三步:先诊断文章,再动手起标题
运行后,它先把文章真正的新信息和核心冲突找出来:这篇文章的真正的核心是把几个传播数字背后的前提拆开。接着它生成 20 个标题,并为每一个标注“抓住了什么、误导风险、营销强度、适用场景”。
其中 A5 和 B4 被标成中等风险,B4 还明确建议补上“官方称”。这比事后凭感觉删标题靠谱得多,因为风险已经和标题放在同一张表里。
图02-11|标题一致性检查
选三个各有用途的
豆包工作最后推荐了三条:
•
公众号头条用 C2:别人在传“1/40 价格”,正文里写的是 1/30 到 1/100;
•
社群转发用 C3:官方说“接近 Opus”,传播变成了“持平 Opus”;
•
搜索流量用 A1:把模型名、参数和 API 价格写全。
图02-12|标题候选与风险表
说实话,这一波他选的标题不咋地。但是其实测试下来,所有的 AI 起标题都一般。
你需要像我上面说的,平时去收集一些爆款标题,形成一个爆款标题库。在让 AI 知道什么样的标题是爆款的前提下,再去用这个工作流起标题,效果会好很多。
如果你的标题库足够庞大,甚至可以用仓颉skill去蒸馏一套起标题的skill出来。
任务四:制作公众号封面
封面最怕两件事:一是只顾着“科技感”,最后满屏机器人和电路板;二是标题还没定,就开始画图,结果画面和正文说的完全不是一回事。
第一步:找到当前版本里的「创意设计」
这项能力在当前豆包工作里叫「创意设计」,也就是生成社媒封面、创意海报和电商套图。后面的封面概念、出图和生成后检查,都是在这个能力里完成的。
图02-13|找到视觉创作能力
第二步:把正文和标题一起交给它
我让它同时读取公众号成稿和标题风险表,再做 3 个明显不同的无文字方案。视觉主题被限定为“高能力与低成本之间的理性权衡”,配色只用深蓝、冷白和少量亮绿;不用真人、品牌 Logo、机器人、密集电路板,也不在生成图里硬塞容易乱码的中文。
这样一来,封面就都是在已经确认的内容边界里做视觉表达。
可直接复制的实测提示词
代码块
Plain Text
生成的封面还不错,最好就是黑底的,因为黑底上面白色的标题才会更显眼。
结果:交付两种尺寸,还把检查项一起留下
这篇文章是智谱的模型,那如果能把智谱的logo放进去,会更好一点,所以网上找个智谱的logo图让豆包工作融入进去即可。
豆包工作内部集成了字节的seedream,在世界都是顶尖的生图模型。所以用来做封面非常适合。
最终生成的封面还不错。
最后,记住这条内容生产线
如果把这套流程压缩成一句话,就是:先收紧事实,再放开表达;先检查标题,再放大传播。
以后不管写新品发布、行业政策还是公司案例,都可以套同一条链路:
提示词复制
代码块
Plain Text
公开来源
→ 事实包
→ 公众号正文
→ 标题风险表
→ 封面
→ 人工复核
AI 不应该替你把每一个数字说得更响。真正省时间的,是它帮你把来源、边界和中间成果接起来,让后一步始终知道前一步已经确认了什么、还没确认什么。
这样做出来的文章,也许没有“一句话生成爆款”听起来那么刺激,但它更像真正能交给编辑、同事和老板的工作成果。