从评论区找到下一篇内容,并复盘
很多人做内容复盘,最后只留下三句话:播放一般、收藏不错、下次继续优化。
这不叫复盘,最多算看了一眼后台。
真正能帮到下一篇的复盘,要回答得更具体:大家究竟在问什么?哪几个问题反复出现?哪些评论虽然不多,却关系到信任和安全?收藏率达标了,完播为什么还掉得厉害?下次到底保留什么、优化什么、只测试哪一个变量?
这次我在豆包工作里把两个复盘流程分别跑了一遍:
代码块
Plain Text
任务一:32 条评论
→ 完整性检查
→ 主类别标注
→ 主题聚类
→ 事实与推断分开
→ 8 个候选打分
→ Top 3
→ 只推荐一个下一篇主题
任务二:72 小时发布指标 + 发布前目标与制作记录
→ 冻结统计口径
→ 汇总和手算复核
→ 按来源、日期比较
→ 对照目标与制作成本
→ 保留 / 停止 / 测试
→ 下一篇内容 brief
为了能公开展示流程,本文使用的是脱敏样例数据:32 条样例评论、9 行发布指标
先匹配工具:数据已经在本地,就不要多接一圈平台
#OJEnInzafaJH text { white-space: pre; }#OJEnInzafaJH .fb0 { stroke: var(--N900-FG, 0.15); }#OJEnInzafaJH .fb0 {stroke: rgba(31,35,41, 0.15)}#OJEnInzafaJH .fx0 { stroke-miterlimit: 10; }#OJEnInzafaJH .fx0 {stroke-miterlimit: 10}#OJEnInzafaJH .fa1 { fill: rgb(187, 191, 196); }#OJEnInzafaJH .fa1 {fill: rgb(187, 191, 196)}#OJEnInzafaJH .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#OJEnInzafaJH .fx1 {font-style: normal}#OJEnInzafaJH .fx2 { text-anchor: middle; }#OJEnInzafaJH .fx2 {text-anchor: middle}#OJEnInzafaJH .fx3 { dominant-baseline: central; }#OJEnInzafaJH .fx3 {dominant-baseline: central}#OJEnInzafaJH .fx4 { stroke: none; }#OJEnInzafaJH .fx4 {stroke: none}#OJEnInzafaJH .fc0 { fill: var(--text-caption); }#OJEnInzafaJH .fc0 {fill: #646a73}#OJEnInzafaJH .fa2 { fill: var(--text-link-disabled); }#OJEnInzafaJH .fa2 {fill: rgb(187, 191, 196)}#OJEnInzafaJH .fx5 { font: 400 14px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#OJEnInzafaJH .fx5 {font-style: normal}#OJEnInzafaJH .fx6 { text-anchor: start; }#OJEnInzafaJH .fx6 {text-anchor: start}#OJEnInzafaJH .fx7 { dominant-baseline: alphabetic; }#OJEnInzafaJH .fx7 {dominant-baseline: alphabetic}#OJEnInzafaJH .fc1 { fill: rgb(167, 167, 167); }#OJEnInzafaJH .fc1 {fill: rgb(167, 167, 167)}#OJEnInzafaJH .fx8 { font: 400 14px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#OJEnInzafaJH .fx8 {font-style: normal}#OJEnInzafaJH .fc2 { fill: rgb(35, 35, 35); }#OJEnInzafaJH .fc2 {fill: rgb(35, 35, 35)}#OJEnInzafaJH .fb1 { fill: var(--N900-FG, 0.15); }#OJEnInzafaJH .fb1 {fill: rgba(31,35,41, 0.15)}#OJEnInzafaJH .fb2 { fill: rgba(0, 0, 0, 0.1); }#OJEnInzafaJH .fb2 {fill: rgba(0, 0, 0, 0.1)}#OJEnInzafaJH .fa3 { fill: var(--bg-body); }#OJEnInzafaJH .fa3 {fill: #fff}ABC12345独立任务最优组合为什么这样选评论区用户洞察发布后复盘从线上平台直接取数专家团 / MCP豆包工作的“用户研究与需求洞察” Skill + 本地 CSV 读取 + Markdown 文件生成豆包工作的“数据分析” Skill + 指标 CSV + 发布前目标和制作记录对应平台连接器或只读 API,按需添加本次不需要这个 Skill 本身就覆盖原声打标、定量分析和用户需求归纳,适合从评论原话里找问题,而不是只做词频统计能先冻结指标口径,再做对账、比率、来源差异和经营复盘,结果可追溯只有数据还没导出时才需要;本次材料已经在本地,所以没有扩大授权范围两个任务都是单份本地材料的结构化分析,额外增加代理和连接只会扩大复杂度与权限面
这里有一个很实用的判断:工具不是越多越好,能完成任务的最小组合,通常才是最优组合。
如果你要处理真实评论,先从平台后台导出,或者用已经获得授权的只读连接器取数。不要把用户名、手机号、公司、群号、私信内容等个人信息直接放进公开案例。
本文的 comment_id 和 source_url 都是样例字段,只用于演示证据怎么回查。
任务一:评论区到底在问什么,单独做一次用户洞察
这个任务适合内容运营、品牌、公关、产品经理和做知识内容的人。它不要求你先拿到播放、转化等后台指标;只要有一批可以合法使用的评论,就能单独执行。
第一步:找到用户研究与需求洞察
进入豆包工作的“技能 · 连接器 · 伙伴”,搜索“用户研究”或“需求洞察”。这次使用的 Skill 能做开放题原声打标、标签体系、定量统计和原话引用,和“从评论里找下一篇”正好匹配。
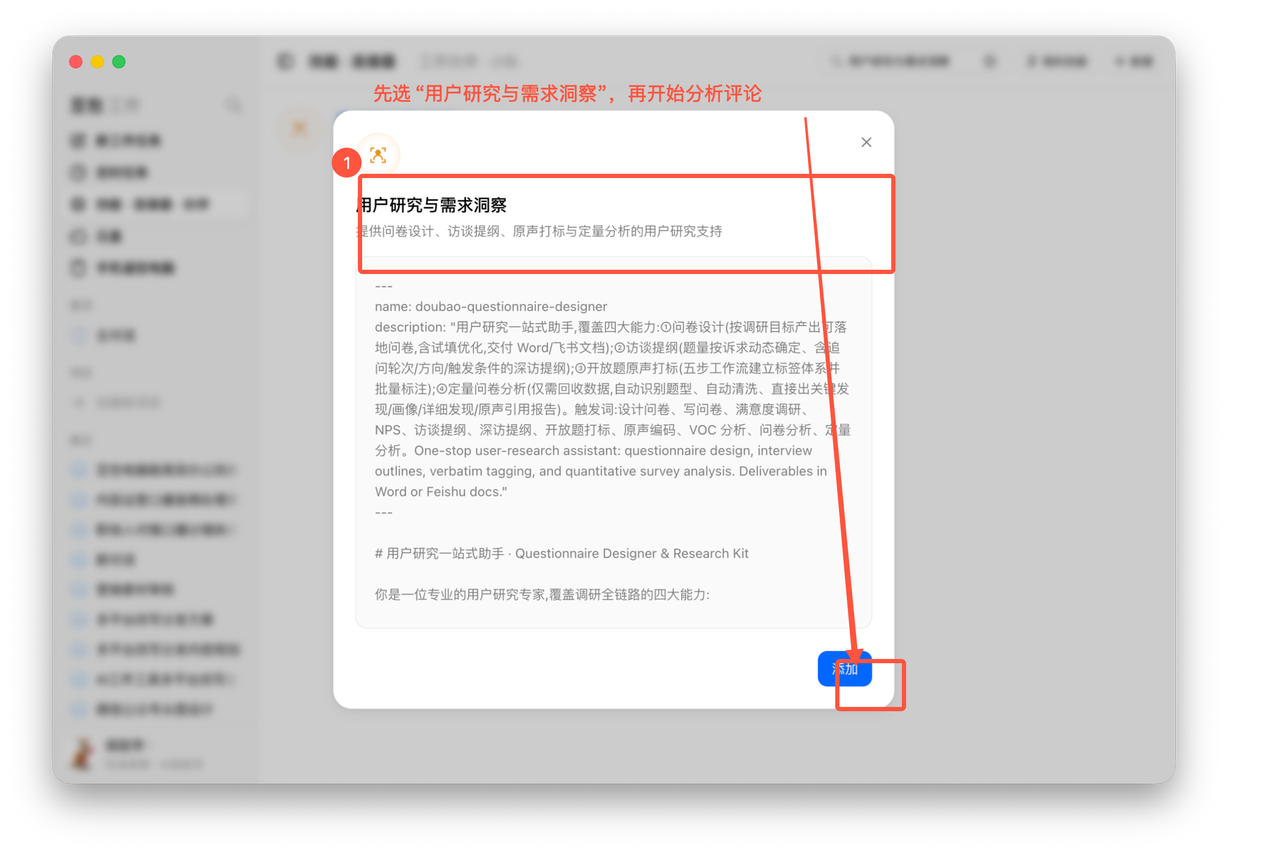
图06-01 添加用户研究与需求洞察 Skill
第二步:先把分类和证据口径写清
我准备了一份包含 32 条评论的 CSV,字段包括 comment_id、评论正文、点赞、回复和 source_url。
提示词里最关键就是下面这4点:
每条评论只计一个主类别,防止统计重复;
每个主题都要给评论数、互动量、代表性 ID、原话和来源;
用户原话能证明的事实,和分析者的推断分开;
只生成分析文件,不自动回评论、不私信、不发布。
可直接复制的实测提示词
代码块
Plain Text
我负责一个面向普通职场人的 AI 工具账号。请使用当前对话已启用的“用户研究与需求洞察”能力,只分析你刚刚找到并读取的 32 条评论文件:
/Users/你的用户名/你的目录/comments.csv
数据说明:这是用于内部练习的脱敏样例数据,不对应真实账号或真实评论者。不要联网补充评论,也不要根据账号画像推断年龄、性别、职业、地域、收入等个人敏感属性。
请按下面步骤完成:
1. 先做数据完整性检查:确认总行数、字段、空值、重复评论和疑似垃圾信息。
2. 给每条评论标一个“主类别”:提问、认可、反对、误解、补充案例、产品需求、情绪表达、垃圾信息。必要时可加副标签,但统计只按主类别计算,避免重复计数。
3. 把评论聚成用户问题主题。每个主题必须给出:评论数、互动量(点赞+回复)、代表性 comment_id、1—2 条原话和对应 source_url。
4. 明确区分“用户原话能直接证明的事实”和“你的推断”。推断必须单独标注,不得写成用户共识。
5. 单独列出:适合公开回复的问题、需要私下处理或谨慎回应的风险、可以忽略的垃圾信息。
6. 生成 8 个下一篇内容候选。分别按需求频次、互动强度、可操作性、信任/安全价值四项各 1—5 分打分,并给总分和证据 comment_id。
7. 选出 Top 3;再明确推荐下一篇只做一个主题,并给出选题标题、读者问题、文章承诺、必须回答的 5 个问题、需要准备的证据、不能夸大的边界。
8. 做一次自检:分类总数是否等于有效评论数,引用能否回到 comment_id/source_url,是否把推断写成事实。
请保存为《评论用户问题地图.md》。聊天里只汇总:有效评论数、垃圾评论数、Top 3 选题和推荐的下一篇主题。
把路径换成你自己的文件路径即可。如果你的评论已经作为附件上传,也可以把路径那一行改成“只分析当前对话中的【文件名】”。
图06-02 写清分类、证据和安全边界
第三步:结论是经过数据验证的
任务开始后,豆包工作先读取评论文件,检查行数、字段、空值、重复和垃圾信息,再进入分类、聚类和评分。
这一步值得要注意看一下。只要总数都没对上,就会导致后面的主题不可靠;因为如果它把同一条评论同时算进多个主类别,也没有意义。
图06-03 先检查数据,再做主题聚类
实测结果:从 31 条有效评论里,筛出下一篇
完整性检查得到 32 条记录、6 个字段、无空值、无重复,识别出 1 条垃圾信息 C032,所以有效评论是 31 条。
豆包工作给出的 Top 3 是:
最终只推荐了一个主题:长音频转写与人工校对实操。为什么会选择这个主题?从数据上我们可以看到 C026 明确说“每天都要整理访谈”,单条互动 108;同时还能回应会议录音、只要字幕、新手不知道从哪里开始等相邻问题。
图06-04 有效评论、Top 3 与唯一推荐主题
人工还要再检查三件事:引用有没有断章取义;少量但涉及信任、安全、隐私的问题有没有被平均数淹没;推荐主题是不是能拿出真实截图、数据或失败过程来回答。
任务二:发布后复盘,下一篇别再从零开始
这个任务和任务一彼此独立。你可以没有评论文本,只拿一份指标表,再配上发布前目标和制作记录,就ok。
这次样例指标覆盖 72 小时、3 天、3 个来源,共 9 行;制作记录里写了内容目标、结构、已知限制和总投入 490 分钟。
第一步:选择“数据分析” Skill
搜索并添加“数据分析”。它的优势是会先检查附件、冻结口径、明确分母、对账,再把事实、解释假设和下一步行动分开。
图06-05 添加数据分析 Skill
第二步:写提示词最重要的两点
复盘最容易踩的坑,是分母混乱。完播率到底是完播除以播放,还是除以 3 秒播放?关注转化率是关注除以主页点击,还是除以播放?不先写清,同一份数据能算出完全不同的结果。
可直接复制的实测提示词
代码块
Plain Text
这是一个新的、独立的发布后复盘任务。请使用当前对话启用的“数据分析”能力,只读取下面两份本地材料:
1. /Users/你的用户名/你的目录/metrics.csv
2. /Users/你的用户名/你的目录/goals-and-log.md
数据是脱敏样例,不代表真实账号表现。不要联网补数,不要连接内容平台,也不要把单次发布推断成长期规律。
请按以下步骤:
1. 冻结统计口径:72 小时;确认行数、字段、空值、重复、各指标单位。明确每个比率分母。
2. 汇总曝光、播放、3 秒播放、完播、点赞、收藏、分享、评论、主页点击、关注。
3. 计算并复核:曝光→播放率、3 秒留存率、完播率、点赞率、收藏率、分享率、评论率、主页点击率、关注转化率。至少手算抽查 3 个指标。
4. 按日期和来源分别比较,指出变化最大的环节;事实与解释假设分开。
5. 对照发布前目标、内容结构和 490 分钟制作投入,回答:目标是否达成、哪里值得保留、哪里应停止、下次还需测试什么。
图06-06 冻结统计口径并明确所有分母
第三步:先对账,再解释变化
豆包工作先确认 CSV 是 9 行、12 个字段、3 天 × 3 来源,无空值无重复。随后把分来源和分日期的总量相加,检查能否回到整体总数,再计算比率。
通常在数据对不上时,原因分析写得越流畅,误导越大,一切以数据为准。
图06-07 读取材料、核对数据并开始计算
实测结果:收藏达标,但不能因此说整条内容成功
72 小时总量是:曝光 51,400、播放 22,890、3 秒播放 19,358、完播 7,537、收藏 1,190。
图06-08 收藏率、完播率和保留/停止/测试
三个关键比率是:
•
曝光→播放率:22,890 ÷ 51,400 = 44.53%;
•
完播率:7,537 ÷ 22,890 = 32.93%;
•
收藏率:1,190 ÷ 22,890 = 5.20%,超过发布前设定的 3% 目标。
分来源看,粉丝页在 9 项比率中有 8 项最高;搜索的收藏率和分享率领先;推荐流贡献了约 70% 的曝光,但各项转化偏低。
更重要的是,它点出了四个明确动作:
“信息密度导致中段流失”仍然只是一个假设,必须通过后续 A/B 或同类内容对照验证。单次发布 n=1,而且指标表没有评论正文,所以“评论里是否出现更多具体问题”这项目标也无法在本任务中验证。
❗复盘不是给过去找一个听起来合理的故事,而是给下一次准备一个可以验证的动作。
最后,把这套方法压缩成一张检查清单
做评论洞察时:
先脱敏,再把评论交给 AI;
先查总数、空值、重复和垃圾信息;
每条评论只计一个主类别;
主题必须带 comment_id、原话和来源;
用户原话和分析推断分开;
先排 8 个候选,再选 Top 3,最后只定一个下一篇;
不自动回复、不私信、不发布。
做发布后复盘时:
固定统计窗口和指标分母;
总量、分来源、分日期必须对账;
至少手算抽查 3 个关键比率;
和发布前目标、内容结构、制作成本一起看;
结论必须落到保留、停止、测试;
单次发布只提出假设,不总结长期规律;
先生成复盘卡片和下一篇 brief,不直接写回选题库或发布平台。
评论区像一份免费的、持续更新的用户访谈。后台指标同样重要,它能知道你下次该改哪里。
把这两种材料分开处理,再把结果放回下一篇内容里,选题就不需要每次从空白文档开始了。