混合检索:如何结合语义检索和关键词检索?
难度:中级 分类:RAG
简短回答
混合检索(Hybrid Search)并行运行向量语义检索和 BM25 关键词检索,然后通过融合算法(如 Reciprocal Rank Fusion, RRF)将两组结果合并为统一排序列表。语义检索擅长理解意图和同义词匹配,关键词检索擅长精确术语匹配(产品编号、专有名词)。两者互补,实际生产中通常再加一层 Cross-Encoder 重排序形成"两阶段检索"架构。
详细解析
为什么需要混合检索?
纯语义检索的致命弱点:Embedding 模型只能理解其训练数据覆盖的语义。对于以下场景,语义检索可能完全失效:
•
产品编号/SKU:如 "TS-01"、"iPhone 16 Pro Max"
•
专有术语:新产品名、公司内部代号
•
精确匹配:法律条款编号、API 端点路径
•
Out-of-domain 数据:Embedding 模型训练集未覆盖的领域
这些场景下关键词检索(BM25)更可靠,因为它做的是精确的词汇匹配。
反过来,纯关键词检索无法理解语义相似性(如"汽车"和"轿车"、"bug"和"defect"),这正是语义检索的强项。
混合检索的工作流程
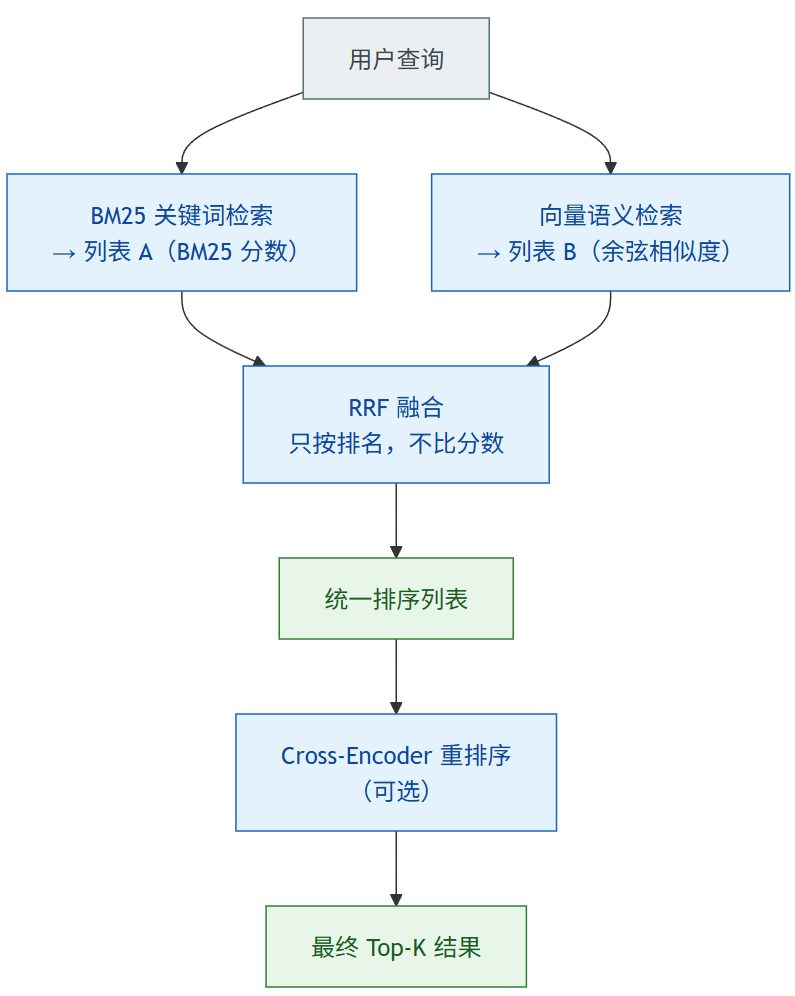
混合检索并行跑 BM25 与向量两路,RRF 只按排名融合规避分数不可比,再经 Cross-Encoder 精排出 Top-K。
分数不可比问题
直接合并两组结果的核心挑战:分数尺度完全不同。
•
BM25 分数:可能是 12.4(无上界,受词频和文档分布影响)
•
余弦相似度:0.85(范围 0-1)
这两个数值无法直接比较!解决方案有两种。
融合方法 1:Reciprocal Rank Fusion (RRF)
RRF 是最广泛使用的融合方法,核心思想是只看排名,不看分数:
代码块
Python
def reciprocal_rank_fusion(ranked_lists: list[list], k: int = 60) -> list:
"""
RRF 公式(Cormack et al. 2009):score(d) = sum(1 / (rank_i + k)) for each list i
论文原始公式 rank 从 1 开始;下面代码用 enumerate 起始为 1 与论文对齐。
k=60 是论文推荐的常数,用于平滑排名差异。
"""
scores = {}
RRF 优势:
•
无需归一化:纯基于排名位置,不关心原始分数
•
无需调参:k=60 开箱即用
•
高效可扩展:适合大规模分片索引
融合方法 2:线性组合(Weighted Scoring)
代码块
Python
def weighted_fusion(bm25_scores, vector_scores, alpha=0.5):
"""
先归一化两组分数到 [0,1],再加权求和
alpha: 向量检索的权重(1-alpha: BM25 的权重)
"""
norm_bm25 = min_max_normalize(bm25_scores)
norm_vector = min_max_normalize(vector_scores)
combined = {}
for doc_id in set(norm_bm25) | set(norm_vector):
combined[doc_id] = (
alpha * norm_vector.get(doc_id, 0) +
(1 - alpha) * norm_bm25.get(doc_id, 0)
)
线性组合经过仔细调参后可能优于 RRF,但对数据集敏感,需要实验。
两阶段架构(生产最佳实践)
代码块
Plain Text
# 第 1 阶段:混合检索(RRF 融合,取 Top 100)
bm25_results = bm25_retriever.search(query, top_k=100)
vector_results = vector_retriever.search(query, top_k=100)
candidates = reciprocal_rank_fusion([bm25_results, vector_results])[:100]
# 第 2 阶段:Cross-Encoder 精排(取 Top 5 送入 LLM)
reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L-6-v2")
reranked = reranker.rank(query, [doc.content for doc in candidates])
final_context = reranked[:5]
RRF 擅长合并列表但缺乏深层语义理解;Cross-Encoder 擅长精确的 query-document 关系评估但计算昂贵。两阶段结合取长补短。
主流平台支持
常见误区 / 面试追问
误区:"语义检索总是比关键词检索好" — 对精确术语(编号、代码、专有名词),BM25 通常更准确。混合检索的价值正在于让两者互补。
误区:"RRF 的 k=60 需要调参" — k=60 是论文验证过的鲁棒默认值,大多数场景下无需调整。除非有极端需求,否则保持默认即可。
追问:"如何设置 BM25 和向量检索的权重比?" — 如果用 RRF 则不需要设权重。如果用线性组合,默认 50/50 开始,然后根据评估指标(Recall@k)在你的数据集上调优。术语密集的领域(法律、医学)可能偏向 BM25。
追问:"稀疏向量(Sparse Embedding)和 BM25 有什么区别?" — 传统 BM25 基于词频统计。稀疏向量(如 SPLADE)用学习到的稀疏表示,保留了关键词匹配的精确性同时具有一定的语义理解能力,是 BM25 的升级版。