RAG 评估指标体系:原理、计算与实战
难度:高级 标签:RAG、评估指标、Retrieval、Generation、RAGAS
简短回答
RAG 系统的评估需要从检索质量和生成质量两个维度同时度量。检索侧使用 Precision@K、Recall@K、MRR、MAP、NDCG 等经典信息检索指标衡量"找得准不准";生成侧使用 Faithfulness(忠实度)和 Answer Relevancy(答案相关性)衡量"答得好不好"。RAGAS 框架将这些指标整合为一条自动化评估流水线,可在离线和 CI/CD 场景中持续监控 RAG 系统的端到端质量。
详细解析
一、RAG 评估的整体框架
一个完整的 RAG 系统可以拆解为两个阶段,评估也相应分为两个维度:
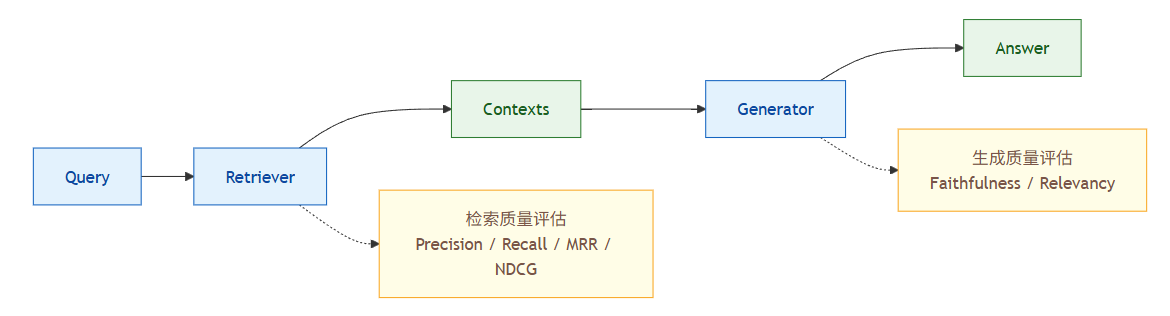
RAG 评估按流水线拆两半:Retriever 侧量找得准不准,Generator 侧量答得好不好,检索质量是生成质量的上界。
#BrDOHsvrkBAH text { white-space: pre; }#BrDOHsvrkBAH .fb0 { stroke: var(--N900-FG, 0.15); }#BrDOHsvrkBAH .fb0 {stroke: rgba(31,35,41, 0.15)}#BrDOHsvrkBAH .fx0 { stroke-miterlimit: 10; }#BrDOHsvrkBAH .fx0 {stroke-miterlimit: 10}#BrDOHsvrkBAH .fa1 { fill: rgb(187, 191, 196); }#BrDOHsvrkBAH .fa1 {fill: rgb(187, 191, 196)}#BrDOHsvrkBAH .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#BrDOHsvrkBAH .fx1 {font-style: normal}#BrDOHsvrkBAH .fx2 { text-anchor: middle; }#BrDOHsvrkBAH .fx2 {text-anchor: middle}#BrDOHsvrkBAH .fx3 { dominant-baseline: central; }#BrDOHsvrkBAH .fx3 {dominant-baseline: central}#BrDOHsvrkBAH .fx4 { stroke: none; }#BrDOHsvrkBAH .fx4 {stroke: none}#BrDOHsvrkBAH .fc0 { fill: var(--text-caption); }#BrDOHsvrkBAH .fc0 {fill: #646a73}#BrDOHsvrkBAH .fa2 { fill: var(--text-link-disabled); }#BrDOHsvrkBAH .fa2 {fill: rgb(187, 191, 196)}#BrDOHsvrkBAH .fx5 { font: 400 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#BrDOHsvrkBAH .fx5 {font-style: normal}#BrDOHsvrkBAH .fx6 { text-anchor: start; }#BrDOHsvrkBAH .fx6 {text-anchor: start}#BrDOHsvrkBAH .fx7 { dominant-baseline: alphabetic; }#BrDOHsvrkBAH .fx7 {dominant-baseline: alphabetic}#BrDOHsvrkBAH .fc1 { fill: rgb(31, 35, 40); }#BrDOHsvrkBAH .fc1 {fill: rgb(31, 35, 40)}#BrDOHsvrkBAH .fb1 { fill: var(--N900-FG, 0.15); }#BrDOHsvrkBAH .fb1 {fill: rgba(31,35,41, 0.15)}#BrDOHsvrkBAH .fb2 { fill: rgb(209, 217, 224); }#BrDOHsvrkBAH .fb2 {fill: rgb(209, 217, 224)}#BrDOHsvrkBAH .fa3 { fill: var(--bg-body); }#BrDOHsvrkBAH .fa3 {fill: #fff}ABC123维度检索质量生成质量核心问题检索到的文档是否相关?排序是否合理?答案是否忠于检索到的上下文?是否切题?代表指标Precision@K, Recall@K, Context Precision, Context Recall, MRR, MAP, NDCGFaithfulness, Answer Relevancy
关键认知:检索质量是生成质量的上界——如果检索阶段丢失了关键信息,生成阶段不可能凭空补回来。因此实践中应先优化检索,再调优生成。
二、检索质量指标
2.1 Precision@K 与 Recall@K
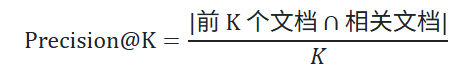
Precision@K(精确率@K)
•
定义:在检索返回的前 K 个文档中,相关文档所占的比例。
•
公式:
Recall@K(召回率@K)
•
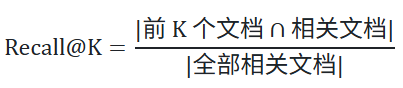
定义:在所有相关文档中,被检索返回的前 K 个文档覆盖了多少比例。
•
公式:
手算示例:
假设对于一个 query,共有 4 篇相关文档(ground truth),检索器返回了 Top-5 结果:
#ZEDcECXNnlhb text { white-space: pre; }#ZEDcECXNnlhb .fb0 { stroke: var(--N900-FG, 0.15); }#ZEDcECXNnlhb .fb0 {stroke: rgba(31,35,41, 0.15)}#ZEDcECXNnlhb .fx0 { stroke-miterlimit: 10; }#ZEDcECXNnlhb .fx0 {stroke-miterlimit: 10}#ZEDcECXNnlhb .fa1 { fill: rgb(187, 191, 196); }#ZEDcECXNnlhb .fa1 {fill: rgb(187, 191, 196)}#ZEDcECXNnlhb .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#ZEDcECXNnlhb .fx1 {font-style: normal}#ZEDcECXNnlhb .fx2 { text-anchor: middle; }#ZEDcECXNnlhb .fx2 {text-anchor: middle}#ZEDcECXNnlhb .fx3 { dominant-baseline: central; }#ZEDcECXNnlhb .fx3 {dominant-baseline: central}#ZEDcECXNnlhb .fx4 { stroke: none; }#ZEDcECXNnlhb .fx4 {stroke: none}#ZEDcECXNnlhb .fc0 { fill: var(--text-caption); }#ZEDcECXNnlhb .fc0 {fill: #646a73}#ZEDcECXNnlhb .fa2 { fill: var(--text-link-disabled); }#ZEDcECXNnlhb .fa2 {fill: rgb(187, 191, 196)}#ZEDcECXNnlhb .fx5 { font: 400 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#ZEDcECXNnlhb .fx5 {font-style: normal}#ZEDcECXNnlhb .fx6 { text-anchor: start; }#ZEDcECXNnlhb .fx6 {text-anchor: start}#ZEDcECXNnlhb .fx7 { dominant-baseline: alphabetic; }#ZEDcECXNnlhb .fx7 {dominant-baseline: alphabetic}#ZEDcECXNnlhb .fc1 { fill: rgb(31, 35, 40); }#ZEDcECXNnlhb .fc1 {fill: rgb(31, 35, 40)}#ZEDcECXNnlhb .fb1 { fill: var(--N900-FG, 0.15); }#ZEDcECXNnlhb .fb1 {fill: rgba(31,35,41, 0.15)}#ZEDcECXNnlhb .fb2 { fill: rgb(209, 217, 224); }#ZEDcECXNnlhb .fb2 {fill: rgb(209, 217, 224)}#ZEDcECXNnlhb .fa3 { fill: var(--bg-body); }#ZEDcECXNnlhb .fa3 {fill: #fff}ABC123456排名12345文档Doc ADoc BDoc CDoc DDoc E是否相关✅❌✅✅❌
代码块
Plain Text
Precision@5 = 3 / 5 = 0.6
Recall@5 = 3 / 4 = 0.75
Python 验证代码:
代码块
Python
def precision_at_k(retrieved: list[bool], k: int) -> float:
"""retrieved: 按排名顺序的相关性列表,True 表示相关"""
return sum(retrieved[:k]) / k
def recall_at_k(retrieved: list[bool], k: int, total_relevant: int) -> float:
return sum(retrieved[:k]) / total_relevant
# 示例数据
retrieved = [True, False, True, True, False]
total_relevant = 4
print(f"Precision@5 = {precision_at_k(retrieved, 5)}") # 0.6
print(f"Recall@5 = {recall_at_k(retrieved, 5, total_relevant)}") # 0.75
2.2 Context Precision 与 Context Recall
这两个指标是 RAGAS 框架对传统 Precision/Recall 的 RAG 场景适配版本,核心区别在于用 LLM 判断相关性而非人工标注。
Context Precision
•
定义:检索到的上下文中,每个相关上下文的排名加权精确率。排名越靠前的位置出现相关上下文,得分越高。
◦
公式:
其中 1[dk 相关] 是指示函数,当第 k 个文档相关时为 1,否则为 0。
Context Recall
•
定义:ground truth 答案中的每个关键陈述(claim)是否都能在检索到的上下文中找到支撑。
•
公式:
手算示例:
假设检索返回 4 个上下文,相关性判断为 [1, 0, 1, 0](1=相关,0=不相关):
代码块
SQL
Precision@1 = 1/1 = 1.0 → d₁ 相关,计入:1.0 × 1 = 1.0
Precision@2 = 1/2 = 0.5 → d₂ 不相关,计入:0.5 × 0 = 0
Precision@3 = 2/3 ≈ 0.667 → d₃ 相关,计入:0.667 × 1 = 0.667
Precision@4 = 2/4 = 0.5 → d₄ 不相关,计入:0.5 × 0 = 0
Context Precision = (1.0 + 0 + 0.667 + 0) / 2 = 0.833
假设 ground truth 包含 5 个关键陈述,其中 4 个能在检索上下文中找到支撑:
代码块
Plain Text
Context Recall = 4 / 5 = 0.8
Python 验证代码:
代码块
Python
def context_precision(relevance: list[int]) -> float:
"""relevance: 按排名顺序的相关性列表,1=相关,0=不相关"""
num_relevant = sum(relevance)
if num_relevant == 0:
return 0.0
score = 0.0
cumulative_relevant = 0
for k, rel in enumerate(relevance, 1):
cumulative_relevant += rel
precision_at_k = cumulative_relevant / k
score += precision_at_k * rel
return score / num_relevant
def context_recall(claims_supported: int, total_claims: int) -> float:
return claims_supported / total_claims
2.3 MRR(Mean Reciprocal Rank)
•
定义:对于一组 query,每个 query 取第一个相关文档的排名倒数,再求平均。反映"用户最快多久能找到想要的结果"。
•
公式:
其中 ranki 是第 i 个 query 的第一个相关文档的排名位置。
手算示例:
3 个 query 的检索结果(✅ 表示第一个相关文档):
代码块
Plain Text
MRR = (0.500 + 1.000 + 0.250) / 3 = 0.583
Python 验证代码:
代码块
Python
2.4 MAP(Mean Average Precision)
•
定义:对每个 query 计算 Average Precision(AP),再对所有 query 取平均。AP 考虑了每个相关文档出现位置的精确率,比 Precision@K 更全面地衡量排序质量。
•
公式:
手算示例:
Query 的检索结果(Top-6),共 3 个相关文档:
#hlCBEvRBtwly text { white-space: pre; }#hlCBEvRBtwly .fb0 { stroke: var(--N900-FG, 0.15); }#hlCBEvRBtwly .fb0 {stroke: rgba(31,35,41, 0.15)}#hlCBEvRBtwly .fx0 { stroke-miterlimit: 10; }#hlCBEvRBtwly .fx0 {stroke-miterlimit: 10}#hlCBEvRBtwly .fa1 { fill: rgb(187, 191, 196); }#hlCBEvRBtwly .fa1 {fill: rgb(187, 191, 196)}#hlCBEvRBtwly .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#hlCBEvRBtwly .fx1 {font-style: normal}#hlCBEvRBtwly .fx2 { text-anchor: middle; }#hlCBEvRBtwly .fx2 {text-anchor: middle}#hlCBEvRBtwly .fx3 { dominant-baseline: central; }#hlCBEvRBtwly .fx3 {dominant-baseline: central}#hlCBEvRBtwly .fx4 { stroke: none; }#hlCBEvRBtwly .fx4 {stroke: none}#hlCBEvRBtwly .fc0 { fill: var(--text-caption); }#hlCBEvRBtwly .fc0 {fill: #646a73}#hlCBEvRBtwly .fa2 { fill: var(--text-link-disabled); }#hlCBEvRBtwly .fa2 {fill: rgb(187, 191, 196)}#hlCBEvRBtwly .fx5 { font: 400 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#hlCBEvRBtwly .fx5 {font-style: normal}#hlCBEvRBtwly .fx6 { text-anchor: start; }#hlCBEvRBtwly .fx6 {text-anchor: start}#hlCBEvRBtwly .fx7 { dominant-baseline: alphabetic; }#hlCBEvRBtwly .fx7 {dominant-baseline: alphabetic}#hlCBEvRBtwly .fc1 { fill: rgb(31, 35, 40); }#hlCBEvRBtwly .fc1 {fill: rgb(31, 35, 40)}#hlCBEvRBtwly .fb1 { fill: var(--N900-FG, 0.15); }#hlCBEvRBtwly .fb1 {fill: rgba(31,35,41, 0.15)}#hlCBEvRBtwly .fb2 { fill: rgb(209, 217, 224); }#hlCBEvRBtwly .fb2 {fill: rgb(209, 217, 224)}#hlCBEvRBtwly .fa3 { fill: var(--bg-body); }#hlCBEvRBtwly .fa3 {fill: #fff}ABCD1234567排名 k123456是否相关✅❌✅❌❌✅Precision@k1/1 = 1.0001/2 = 0.5002/3 = 0.6672/4 = 0.5002/5 = 0.4003/6 = 0.500相关时计入1—0.667——0.5
代码块
Plain Text
AP = (1.000 + 0.667 + 0.500) / 3 = 0.722
如果有 2 个 query,AP 分别为 0.722 和 0.500:
代码块
Plain Text
MAP = (0.722 + 0.500) / 2 = 0.611
Python 验证代码:
代码块
Python
def average_precision(retrieved: list[bool]) -> float:
num_relevant = sum(retrieved)
if num_relevant == 0:
return 0.0
score = 0.0
cumulative_relevant = 0
for k, is_relevant in enumerate(retrieved, 1):
if is_relevant:
cumulative_relevant += 1
score += cumulative_relevant / k
return score / num_relevant
def mean_average_precision(queries: list[list[bool]]) -> float:
return sum(average_precision(q) for q in queries) / len(queries)
2.5 NDCG(Normalized Discounted Cumulative Gain)
•
定义:在二元相关性(相关/不相关)之上,NDCG 支持多级相关性评分(如 0/1/2/3),并通过对数折扣惩罚排名靠后的结果。它衡量的是"排序结果与理想排序的接近程度"。
•
公式:
其中 IDCG 是将所有文档按相关性降序排列后的理想 DCG 值。
手算示例:
检索返回 Top-5,相关性评分(0~3):
代码块
Plain Text
DCG@5 = 7.000 + 0.000 + 1.500 + 0.431 + 1.161 = 10.092
理想排序(降序):[3, 2, 2, 1, 0]
代码块
Plain Text
IDCG@5 = 7.000 + 1.893 + 1.500 + 0.431 + 0.000 = 10.824
NDCG@5 = 10.092 / 10.824 = 0.932
Python 验证代码:
代码块
Python
import math
def dcg_at_k(relevances: list[int], k: int) -> float:
return sum(
(2 ** rel - 1) / math.log2(i + 2) # i+2 因为 enumerate 从 0 开始
for i, rel in enumerate(relevances[:k])
)
def ndcg_at_k(relevances: list[int], k: int) -> float:
dcg = dcg_at_k(relevances, k)
ideal = sorted(relevances, reverse=True)
idcg = dcg_at_k(ideal, k)
return dcg / idcg if idcg > 0 else 0.0
# 示例数据
relevances = [3, 0, 2, 1, 2]
print(f"DCG@5 = {dcg_at_k(relevances, 5):.3f}") # 10.092
print(f"NDCG@5 = {ndcg_at_k(relevances, 5):.3f}") # 0.932
检索指标诊断价值对比表
适用场景速查表
三、生成质量指标
3.1 Faithfulness(忠实度)
•
定义:生成的答案中,有多少比例的陈述(claim)可以从检索到的上下文中找到依据。衡量"幻觉"程度。
•
公式:
评估流程(LLM-as-Judge):
Step 1: 用 LLM 将生成答案拆解为独立的事实性陈述(claims)
Step 2: 逐条判断每个 claim 是否能在检索上下文中找到支撑
Step 3: 计算被支撑的 claims 占总 claims 的比例
手算示例:
代码块
Plain Text
检索上下文:
"Python 是 Guido van Rossum 在 1991 年发布的编程语言。
Python 3.0 于 2008 年发布。"
Python 验证代码:
代码块
Python
3.2 Answer Relevancy(答案相关性)
•
定义:生成的答案与原始问题的语义相关程度。通过反向生成问题来衡量——如果从答案中能还原出与原始问题语义一致的问题,说明答案是切题的。
•
公式:
其中 qi 是从答案反向生成的第 i 个问题,是原始问题,表示 embedding 向量。
评估流程:
代码块
Plain Text
手算示例:
代码块
SQL
原始问题:"什么是 RAG?"
生成答案:"RAG 是检索增强生成,通过检索外部知识来增强 LLM 的回答质量。"
反向生成的 3 个问题:
Q1: "RAG 是什么技术?" → cos(e_Q1, e_orig) = 0.95
Q2: "如何通过检索增强 LLM?" → cos(e_Q2, e_orig) = 0.82
Q3: "什么是检索增强生成?" → cos(e_Q3, e_orig) = 0.97
Answer Relevancy = (0.95 + 0.82 + 0.97) / 3 = 0.913
Python 验证代码:
代码块
Python
import numpy as np
def answer_relevancy(similarities: list[float]) -> float:
"""给定反向问题与原始问题的余弦相似度列表,计算答案相关性"""
return np.mean(similarities)
# 示例数据
similarities = [0.95, 0.82, 0.97]
print(f"Answer Relevancy = {answer_relevancy(similarities):.3f}") # 0.913
四、RAGAS 评估框架介绍与代码示例
RAGAS(Retrieval-Augmented Generation Assessment)是目前最流行的 RAG 评估框架,集成了上述核心指标,并使用 LLM-as-Judge 实现自动化评估。
RAGAS 核心指标一览
完整代码示例
代码块
Python
from datasets import Dataset
from ragas import evaluate
from ragas.metrics import (
context_precision,
context_recall,
faithfulness,
自定义评估指标
RAGAS 也支持自定义指标,适用于特定业务场景:
代码块
Python
from ragas.metrics.base import MetricWithLLM
from dataclasses import dataclass
@dataclass
class DomainAccuracy(MetricWithLLM):
五、评估最佳实践和流水线设计
评估流水线架构
RAGAS 把评估做成闭环:数据集 → 推理 → 自动打分 → 仪表盘,结果反馈回数据集持续优化。
最佳实践
构建高质量评估数据集
代码块
Python
# 评估数据集结构(黄金标准)
eval_sample = {
"question": "...", # 真实用户问题或合成问题
"ground_truth": "...", # 人工标注的标准答案
"ground_truth_contexts": [] # 人工标注的相关文档
}
•
数据集规模建议:至少 50~100 条,覆盖高频 query 类型
•
包含简单 / 中等 / 困难三个梯度的问题
•
包含边界用例:多跳推理、否定性问题、模糊查询
建立评估基线与持续监控
代码块
Python
指标异常的诊断思路
A/B 评估对比模板
代码块
Python
def ab_evaluate(pipeline_a, pipeline_b, eval_dataset):
"""对比两个 RAG pipeline 的评估结果"""
results_a = evaluate(pipeline_a(eval_dataset))
results_b = evaluate(pipeline_b(eval_dataset))
print("=" * 50)
print(f"{'指标':<25} {'Pipeline A':>10} {'Pipeline B':>10} {'Δ':>8}")
print("=" * 50)
for metric in THRESHOLDS:
a = results_a[metric]
b = results_b[metric]
delta = b - a
arrow = "↑" if delta > 0 else "↓" if delta < 0 else "="
print(f"{metric:<25} {a:>10.3f} {b:>10.3f} {delta:>+7.3f}{arrow}")
常见误区 / 面试追问
常见误区
面试追问
Q1:MRR、MAP、NDCG 三者如何选择?
•
MRR:只关心第一个相关结果,适合"只需一个答案"的场景(如问答)
•
MAP:关心所有相关结果的排名分布,适合"需要多个相关文档"的场景(如多文档摘要)
•
NDCG:在 MAP 基础上支持多级相关性,适合"文档重要程度有差异"的场景(如搜索排序)
Q2:RAGAS 使用 LLM-as-Judge 有什么局限?
•
LLM 本身可能存在偏见(如偏好更长的答案)
•
不同 LLM 的评估结果可能不一致,需固定评估模型版本
•
Claim 拆解的粒度影响 Faithfulness 得分的稳定性
•
对于需要领域专业知识的场景,通用 LLM 的判断可能不准确
Q3:如何构建 RAG 评估数据集?
•
人工标注:质量最高,但成本高。适合核心场景
•
LLM 合成:用 LLM 基于文档自动生成 QA 对,再人工校验
•
线上日志挖掘:从真实用户 query 中采样,标注相关文档和参考答案
•
对抗样本:故意构造 LLM 容易出错的问题(多跳推理、否定性问题、需要计算的问题)
Q4:检索质量和生成质量之间的关系是什么?
•
检索质量是生成质量的上界:生成质量 ≤ f(检索质量)
•
当 Recall 低时,优化生成端收益有限——信息都没检索到,LLM 再强也无法凭空生成
•
当 Faithfulness 低时,可能是检索 Precision 低(噪声文档干扰)或 LLM 自身幻觉
•
建议从左到右排查:先确保检索质量达标,再优化生成质量