RAG 概念、Pipeline 与组件总览
难度:基础 分类:RAG
简短回答
RAG(Retrieval-Augmented Generation,检索增强生成)是一种在 LLM 生成回答之前,先从外部知识库中检索相关文档并注入到 Prompt 中的技术。它主要解决 LLM 的三大核心局限:知识截止(训练数据过时)、幻觉(编造看似合理的错误信息)、以及缺乏领域专有知识。生产级 RAG 系统由三条流水线组成:Indexing Pipeline(离线——数据清洗、分块、Embedding、存储到向量数据库)、Retrieval Pipeline(在线——查询理解、向量检索、后检索优化如重排序和压缩)、Generation Pipeline(在线——上下文组装、Prompt 构建、LLM 生成、输出验证)。RAG 经历了 Naive→Advanced→Modular 三个演进阶段:Naive RAG 是简单的索引-检索-生成链;Advanced RAG 加入预检索(查询改写)与后检索(重排序、压缩)优化;Modular RAG 让每个组件独立可替换、可组合。理解三条流水线的交互方式与 RAG 的演进脉络,是构建高质量 RAG 系统的基础。
详细解析
LLM 的三大核心局限
1.1
知识截止(Knowledge Cutoff)
LLM 的知识在训练完成后就被"冻结"了。当用户询问训练数据截止日期之后的信息时,模型要么承认不知道,要么自信地给出错误答案。LLM 的训练数据往往严重过时,而且当知识出现空白时,它们会进行外推,自信地说出听起来合理但实际错误的陈述。
1.2
幻觉(Hallucination)
由于依赖固定参数,LLM 在面对超出训练范围的任务时,经常产生与任务无关的输出或事实不一致的回答。这种现象被称为幻觉(hallucination)或虚构(confabulation),严重损害了 LLM 的可靠性和可信度。
1.3
缺乏私有/领域知识
LLM 无法访问企业内部文档、私有数据库或最新的领域知识。即使是最强大的通用模型,也无法回答关于公司内部流程、客户数据或专有技术的问题。
RAG 如何解决三大局限
#QwTSTsXVQrFQ text { white-space: pre; }#QwTSTsXVQrFQ .fb0 { stroke: var(--N900-FG, 0.15); }#QwTSTsXVQrFQ .fb0 {stroke: rgba(31,35,41, 0.15)}#QwTSTsXVQrFQ .fx0 { stroke-miterlimit: 10; }#QwTSTsXVQrFQ .fx0 {stroke-miterlimit: 10}#QwTSTsXVQrFQ .fa1 { fill: rgb(187, 191, 196); }#QwTSTsXVQrFQ .fa1 {fill: rgb(187, 191, 196)}#QwTSTsXVQrFQ .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#QwTSTsXVQrFQ .fx1 {font-style: normal}#QwTSTsXVQrFQ .fx2 { text-anchor: middle; }#QwTSTsXVQrFQ .fx2 {text-anchor: middle}#QwTSTsXVQrFQ .fx3 { dominant-baseline: central; }#QwTSTsXVQrFQ .fx3 {dominant-baseline: central}#QwTSTsXVQrFQ .fx4 { stroke: none; }#QwTSTsXVQrFQ .fx4 {stroke: none}#QwTSTsXVQrFQ .fc0 { fill: var(--text-caption); }#QwTSTsXVQrFQ .fc0 {fill: #646a73}#QwTSTsXVQrFQ .fa2 { fill: var(--text-link-disabled); }#QwTSTsXVQrFQ .fa2 {fill: rgb(187, 191, 196)}#QwTSTsXVQrFQ .fx5 { font: 400 13px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#QwTSTsXVQrFQ .fx5 {font-style: normal}#QwTSTsXVQrFQ .fx6 { text-anchor: start; }#QwTSTsXVQrFQ .fx6 {text-anchor: start}#QwTSTsXVQrFQ .fx7 { dominant-baseline: alphabetic; }#QwTSTsXVQrFQ .fx7 {dominant-baseline: alphabetic}#QwTSTsXVQrFQ .fc1 { fill: rgb(0, 0, 0); }#QwTSTsXVQrFQ .fc1 {fill: rgb(0, 0, 0)}#QwTSTsXVQrFQ .fb1 { fill: var(--N900-FG, 0.15); }#QwTSTsXVQrFQ .fb1 {fill: rgba(31,35,41, 0.15)}#QwTSTsXVQrFQ .fb2 { fill: rgb(209, 217, 224); }#QwTSTsXVQrFQ .fb2 {fill: rgb(209, 217, 224)}#QwTSTsXVQrFQ .fa3 { fill: var(--bg-body); }#QwTSTsXVQrFQ .fa3 {fill: #fff}AB1234局限知识截止幻觉缺乏领域知识RAG 的解决方式外部知识库可以随时更新,无需重新训练模型提供"事实锚点",让 LLM 基于检索到的真实文档生成回答接入企业私有数据、行业文档、实时数据源
额外优势:
•
成本效益:无需对 LLM 进行昂贵的微调或重新训练
•
来源可溯:可以在回答中附带引用来源,用户可以验证
•
权限控制:可以根据用户权限控制可检索的文档范围
RAG 整体架构
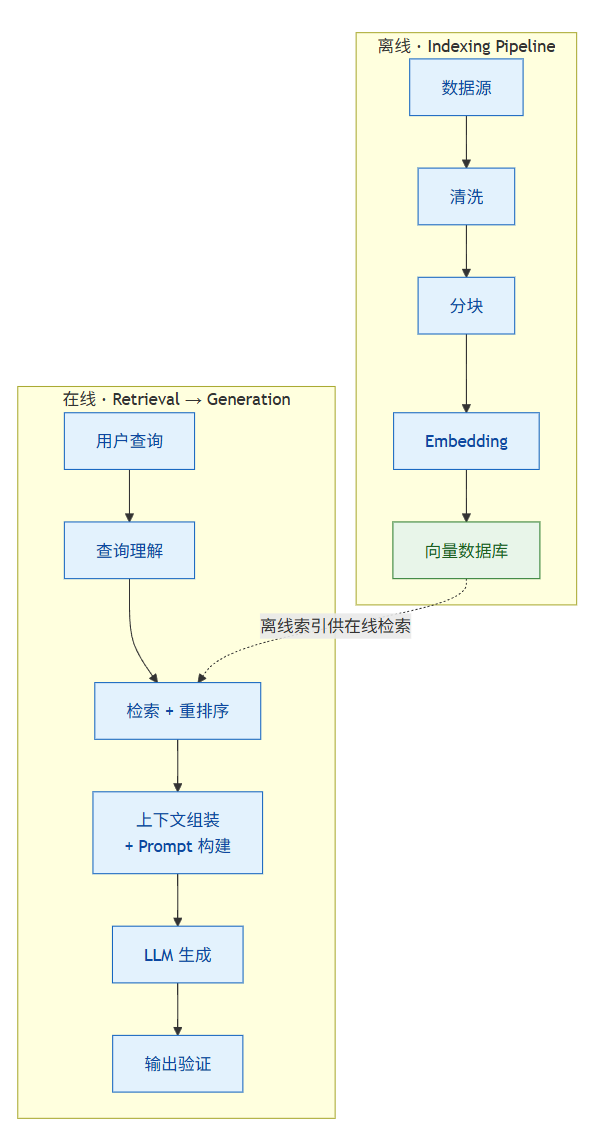
生产级 RAG 由离线索引流水线与在线检索/生成流水线构成,检索质量决定生成上限。
核心流程:
索引(Indexing):离线阶段——将文档分块、生成 Embedding、存入向量数据库
检索(Retrieval):在线阶段——将用户查询转为向量,从向量库中找到最相关的文档块
生成(Generation):将检索到的文档块与原始问题拼接为 Prompt,送入 LLM 生成回答
Indexing Pipeline(索引流水线)
索引流水线是离线阶段,负责将原始数据转化为可检索的向量索引。
数据摄取与清洗
代码块
Python
# 原始数据通常来自多种格式
分块(Chunking)
将长文档切分为语义完整的小块,常见策略:
•
固定大小分块:按 token 数切分,简单但可能破坏语义
•
递归分块:按段落→句子→词的层次分割,平衡实用性
•
语义分块:基于 Embedding 相似度在语义断点处分割
代码块
Python
from langchain.text_splitter import RecursiveCharacterTextSplitter
splitter = RecursiveCharacterTextSplitter(
chunk_size=512, # 注意:chunk_size 是字符数,不是 token 数
chunk_overlap=50, # 相邻块重叠 50 字符,保留上下文连续性
separators=["\n\n", "\n", "。", " ", ""]
)
chunks = splitter.split_documents(documents)
# 如需按 token 计长,使用 TokenTextSplitter 或 from_tiktoken_encoder:
# from langchain.text_splitter import TokenTextSplitter
# splitter = TokenTextSplitter(chunk_size=512, chunk_overlap=50)
# 或:
# splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
# chunk_size=512, chunk_overlap=50
# )
Embedding 与存储
代码块
Plain Text
from langchain_openai import OpenAIEmbeddings
embeddings = OpenAIEmbeddings(model="text-embedding-3-large")
vectors = embeddings.embed_documents([chunk.content for chunk in chunks])
# 存入向量数据库(附带元数据,支持后续过滤)
vectorstore.upsert(
ids=[chunk.id for chunk in chunks],
embeddings=vectors,
documents=[chunk.content for chunk in chunks],
metadatas=[chunk.metadata for chunk in chunks] # 来源、日期、类别等
)
Retrieval Pipeline(检索流水线)
检索流水线在每次用户查询时实时运行,负责找到最相关的文档块。
预检索优化(Pre-retrieval)
提升检索质量的关键在于优化查询本身:
代码块
Python
# 查询改写:让 LLM 重新表述用户问题,提升匹配度
def rewrite_query(original_query: str) -> str:
return llm.generate(
f"将以下问题改写为更适合向量检索的形式,"
f"保持核心语义:\n{original_query}"
)
# 查询分解:将复杂问题拆分为多个子问题
def decompose_query(query: str) -> list[str]:
return llm.generate(
f"将以下复杂问题分解为 2-3 个独立的子问题:\n{query}"
)
# HyDE:生成假设性回答,用回答而非问题去检索
def hypothetical_document(query: str) -> str:
return llm.generate(f"为以下问题生成一个假设性回答:\n{query}")
向量检索
代码块
Plain Text
# 基本语义检索
results = vectorstore.similarity_search(
query_embedding,
top_k=20, # 先检索较多候选
filter={"category": "technical_docs"} # 元数据过滤
)
后检索优化(Post-retrieval)
代码块
Python
# 重排序:用 Cross-Encoder 对候选结果精排
from sentence_transformers import CrossEncoder
reranker = CrossEncoder("cross-encoder/ms-marco-MiniLM-L-6-v2")
Generation Pipeline(生成流水线)
将检索结果与用户查询组合,送入 LLM 生成最终回答。
上下文组装与 Prompt 构建
代码块
Python
def build_rag_prompt(query: str, contexts: list[str]) -> str:
context_text = "\n\n---\n\n".join(contexts)
return f"""基于以下参考文档回答用户问题。
如果文档中没有足够信息,请明确说明。
上下文窗口管理
当检索到的文档超出 LLM 的上下文窗口时,需要智能截断:
•
按重排序得分排列,优先保留高分文档
•
对低优先级文档进行摘要压缩
•
确保关键信息出现在上下文的开头和结尾(避免 "Lost in the Middle" 问题)
三条流水线的优化关系
RAG 的三个演进阶段
RAG 的局限性
RAG 并非万能。它自身也存在问题:
不能完全消除幻觉:"RAG 不是直接的解决方案,因为 LLM 仍然可能围绕源材料进行幻觉。" LLM 可能从检索到的文档中断章取义,得出错误结论。
检索质量瓶颈:
◦
低精确率(Precision):检索到的文档块与问题不匹配
◦
低召回率(Recall):未能检索到所有相关文档块
◦
过时信息:知识库本身可能包含过时数据
依赖知识库质量:知识库中的偏见或错误会直接传导到 LLM 的回答中
1M token 时代:长上下文 vs RAG 决策框架
2026 年,Claude / Gemini / GPT 旗舰模型的上下文窗口普遍达到 1M token(约 75 万英文单词),一个自然的疑问随之而来:既然能一次性塞下整本书甚至整个代码仓,还需要 RAG 吗? 答案不是二选一,而是按场景决策——长上下文解决了「单针检索」,但「多跳找针」与成本/延迟仍是 RAG 的主场。
单针已解,多跳仍难
2026 年的实证研究(arXiv:2605.02173,Retrieval and Multi-Hop Reasoning in 1M-Token Context)系统测试了 Gemini 3.1 Pro、Claude Opus 4.7 等顶级模型在 1M token 窗口下的检索与推理表现,得出两条关键结论:
单针检索(single-needle retrieval)基本已解决:在超长上下文中找一条明确的事实陈述("文档里提到的 CFO 叫什么名字?"),顶级模型的召回接近满分,经典的"大海捞针"(needle-in-a-haystack)不再是难题。
多跳推理(multi-hop reasoning)仍有显著差距:当答案需要跨多个分散段落定位并串联推理(如"A 公司的 CFO 曾任职于哪家被 B 公司收购的企业?"),模型要先找再连,错误会逐跳放大。超过约 256K token 后,多跳任务准确率出现明显滑坡——上下文越长,中间关键信息越容易被忽略(Lost in the Middle 现象在超长窗口下依然存在)。
这条分界线直接决定了选型:长上下文"消灭"了简单事实查找对 RAG 的依赖,但复杂问答、跨文档推理仍是 RAG(尤其 Agentic RAG 的迭代检索)的主场。Agentic RAG 如何用多轮检索攻克多跳问题,详见 #018 — 什么是 Agentic RAG?它与传统 RAG 有何不同?。
决策框架:何时全塞上下文,何时仍需 RAG
按知识源规模与问题复杂度选路:小语料全塞上下文,大语料 RAG 按需检索,多跳推理交给 Agentic RAG。
三条经验法则(按维度查表):
成本与延迟权衡
长上下文不是免费的。即便模型支持 1M token,三大成本仍在:
Token 费用随长度近似线性增长:1M token 的输入费用远高于"一次向量检索 + 拼接 Top-5 片段"(后者通常 < 8K token)。高频场景下,RAG 的成本优势是数量级的。
首 token 延迟(TTFT)显著上升:Prefill 阶段需要处理全部输入 token,上下文越长等待越久;RAG 只 prefill 精选片段,首 token 更快,体感更"跟手"。
召回率反噬:如前所述,超过约 256K token 后多跳任务的"有效召回"不升反降——塞得越多,模型越可能在中间段落"走神"。
实践建议:Prompt Caching 可缓解长上下文的重复 prefill 成本——把稳定的大段系统提示 / 参考文档缓存,仅增量部分计费,是长上下文方案的"中间路线"。详见 #102 — 什么是 Context Engineering?。
现实中的混合方案
生产系统很少走极端,主流组合有二:
•
RAG 为主 + 长上下文兜底:先向量检索 Top-K 片段注入上下文;若用户追问或检索置信度不足,再触发二次检索或扩大注入范围。这正是 Agentic RAG 的典型循环(交叉引用 #018)。
•
长上下文为主 + RAG 定位辅助:对单份大文档(如一份长合同、一个中型代码仓)直接全塞,省去检索;但跨多份文档时仍用 RAG 先定位再读取,规避多跳退化。
一句话总结:1M token 淘汰了"为了塞不下才检索"的 RAG,但没淘汰"为了找得准、花得省、推得对"的 RAG。
端到端代码示例
代码块
Python
from langchain_chroma import Chroma
from langchain_openai import OpenAIEmbeddings, ChatOpenAI
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough
# 1. 索引:分块 + Embedding + 存储
text_splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
chunks = text_splitter.split_documents(documents)
常见误区 / 面试追问
误区:"RAG 完全解决了幻觉问题" — RAG 降低了幻觉概率,但 LLM 仍可能围绕检索内容进行幻觉,或忽略检索结果而使用自身知识。需要配合 Guardrails 和输出验证。
误区:"RAG 可以替代微调(Fine-tuning)" — RAG 和微调解决不同问题。RAG 解决知识问题("知道什么"),微调解决能力问题("怎么做")。如果需要改变模型的行为风格或推理模式,应该用微调。
误区:"RAG 的重点是 Generation" — 实际上 Retrieval 的质量才是 RAG 效果的决定性因素。检索到的文档不相关,再强的 LLM 也救不回来。优化顺序应该是:Retrieval > Indexing > Generation。
误区:"原型能用 = 生产能用" — 原型和生产系统的差异在于评估和监控能力。生产 RAG 需要 (1) 检索质量监控;(2) 生成质量评估;(3) 成本和延迟追踪。
追问:"RAG vs 长上下文窗口——如果模型能处理 100 万 token,还需要 RAG 吗?" — 需要。(1) 长上下文的"大海捞针"问题——中间的信息容易被忽略;(2) 成本——100 万 token 的推理费用远高于 RAG 检索;(3) 延迟——长上下文增加推理时间。
追问:"RAG 的检索精度和 LLM 生成质量哪个更重要?" — 检索精度。如果检索到的文档不相关,再强的 LLM 也无法生成正确答案。"Garbage in, garbage out" 在 RAG 中尤为适用。
追问:"如何评估 RAG Pipeline 的各个环节?" — Indexing:覆盖率测试(是否所有关键信息都被索引);Retrieval:Recall@k、MRR、NDCG;Generation:Faithfulness(忠实度)、Relevance(相关性)、Answer Correctness。
追问:"向量检索一定比关键词检索好吗?" — 不一定。精确术语匹配(如产品型号、法律条款编号)时,BM25 等关键词检索可能更好。最佳实践是混合检索(Hybrid Search)。