高级 RAG 变体:Corrective RAG、Self-RAG、Adaptive RAG
难度:高级 分类:RAG
简短回答
三种高级 RAG 变体各解决不同问题:Self-RAG 通过反思 token 动态决定是否检索并自我评估输出质量,提升事实准确性;Corrective RAG (CRAG) 在检索后评估文档质量,对低质量结果触发 Web 搜索补救;Adaptive RAG 用分类器分析查询复杂度,动态路由到最合适的检索策略。三者可以组合使用,构成多层防御的高可靠 RAG 系统。
详细解析
Self-RAG(自我反思 RAG)
核心思想: 训练 LLM 生成特殊的"反思 token"来自我管理检索和输出质量。
工作流程
代码块
Plain Text
Query → LLM 判断是否需要检索?
├── 不需要 → 直接生成(简单问题,如常识)
└── 需要 → 检索文档
→ 生成回答
→ [反思 token] 评估:
├── 检索结果是否相关?(Relevance)
├── 回答是否基于检索内容?(Support)
└── 回答是否有用?(Utility)
→ 如果不满意 → 重新检索或修改回答
两种特殊 Token
•
Reflection Token(反思 token):决定是否需要检索
•
Critique Token(批评 token):评估检索结果和生成内容的质量
代码块
Python
class SelfRAG:
def answer(self, query: str) -> str:
# 1. 决定是否需要检索
need_retrieval = self.llm.predict_retrieval_need(query)
if not need_retrieval:
return self.llm.generate(query)
# 2. 检索并生成
docs = self.retriever.search(query)
response = self.llm.generate_with_context(query, docs)
# 3. 自我批评
relevance_score = self.llm.critique_relevance(docs, query)
support_score = self.llm.critique_support(response, docs)
utility_score = self.llm.critique_utility(response, query)
# 4. 如果质量不够,迭代改进
关键优势: 根据 Asai et al. (2023) 论文(ICLR 2024 Oral)在 Open-domain QA、推理和事实验证等六类任务上的实验,Self-RAG(7B/13B)显著优于 ChatGPT 和 retrieval-augmented Llama2-chat,事实性指标在多个任务上取得 SOTA。在医疗、法律、金融等高精度需求场景尤为有价值。
局限: 需要用特殊 token 对模型进行微调,不能直接用于现有 API 模型。
Corrective RAG (CRAG)
核心思想: 在检索之后、生成之前,加入一个轻量级评估器来评估文档质量,并在质量不足时启用 Web 搜索作为补救。
工作流程
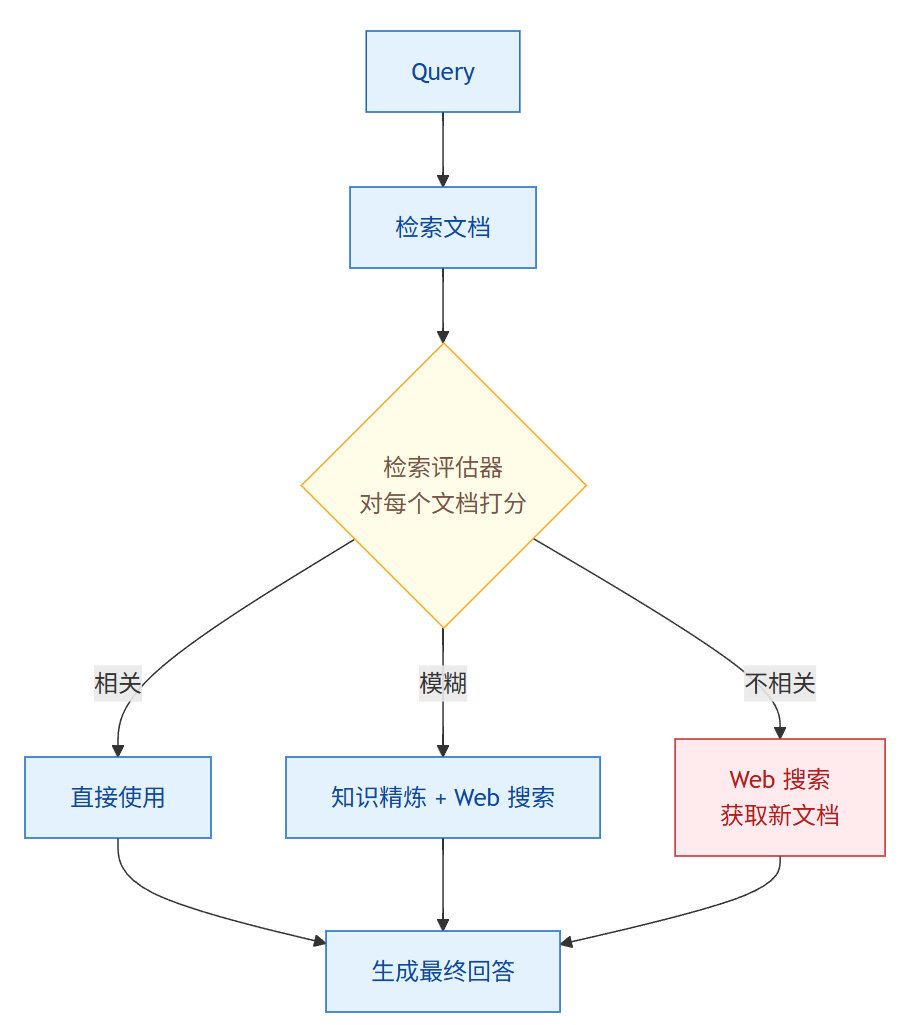
CRAG 在检索与生成之间加评估器:相关直接用,模糊先精炼再补 Web,不相关整组换 Web 搜索兜底。
代码块
Python
class CorrectiveRAG:
关键优势: 轻量级——评估器可以是小模型(甚至规则引擎),不需要微调主 LLM。Web 搜索兜底确保即使知识库不完善也能给出有用回答。
适用场景: 法律研究、学术写作、政策分析——准确性至关重要且允许稍高延迟的场景。
Adaptive RAG
核心思想: 在检索之前,用分类器分析查询复杂度,然后动态选择最合适的检索策略。
工作流程
Adaptive RAG 用复杂度分类器前置路由:简单不检索,中等单次 RAG,复杂多跳检索加验证。
代码块
Python
class AdaptiveRAG:
def answer(self, query: str) -> str:
# 1. 分析查询复杂度
complexity = self.classifier.predict(query)
if complexity == "simple":
# 常识问题 → 不需要检索
return self.llm.generate(query)
elif complexity == "moderate":
# 标准问题 → 单次 RAG
docs = self.retriever.search(query)
关键优势: 通过避免对简单问题过度检索来优化效率和成本。复杂问题得到更深入的处理。
适用场景: 查询复杂度差异大的系统(客服、通用助手)——简单 FAQ 不需要检索,复杂分析需要多轮检索。
三者对比
组合使用:多层防御
三种变体可以组合构成更强大的系统:
代码块
Python
class CombinedAdvancedRAG:
def answer(self, query: str) -> str:
# Layer 1: Adaptive RAG — 路由到合适策略
complexity = self.classifier.predict(query)
if complexity == "simple":
常见误区 / 面试追问
误区:"这些变体互相替代" — 它们解决不同环节的问题,完全可以组合使用。Adaptive RAG 做前端路由,CRAG 做检索质量控制,Self-RAG 做输出质量保证。
误区:"Self-RAG 可以用任何 LLM" — 原始 Self-RAG 需要用反思 token 微调模型。不过,可以通过 Prompt Engineering 模拟类似效果(让 LLM 在 Prompt 中评估自己的输出),但效果不如原版。
追问:"GraphRAG 属于哪个类别?" — GraphRAG 是另一种独立变体,它用知识图谱代替(或补充)向量检索。适合实体关系密集的场景(如组织架构、产品关系网络)。与上述三种变体正交,可以并行使用。
追问:"实际生产中最常用的是哪种?" — Corrective RAG 因为实现简单(不需要微调)且效果显著而最常被采用。Adaptive RAG 在成本敏感场景也很流行。Self-RAG 因为需要微调,更多出现在研究中。