零基础Coze平台使用教程
简介: 本文介绍了Coze智能体的实战入门与进阶应用,涵盖智能体创建、配置大语言模型(LLM)、使用插件扩展功能、构建知识库(RAG)实现高考志愿填报助手、利用记忆功能开发记账本,以及通过API调用和工作流实现中草药识别与菜谱生成等复杂任务,全面展示其在多场景下的智能化能力。
一、Coze智能体实战初体验
访问Coze官网
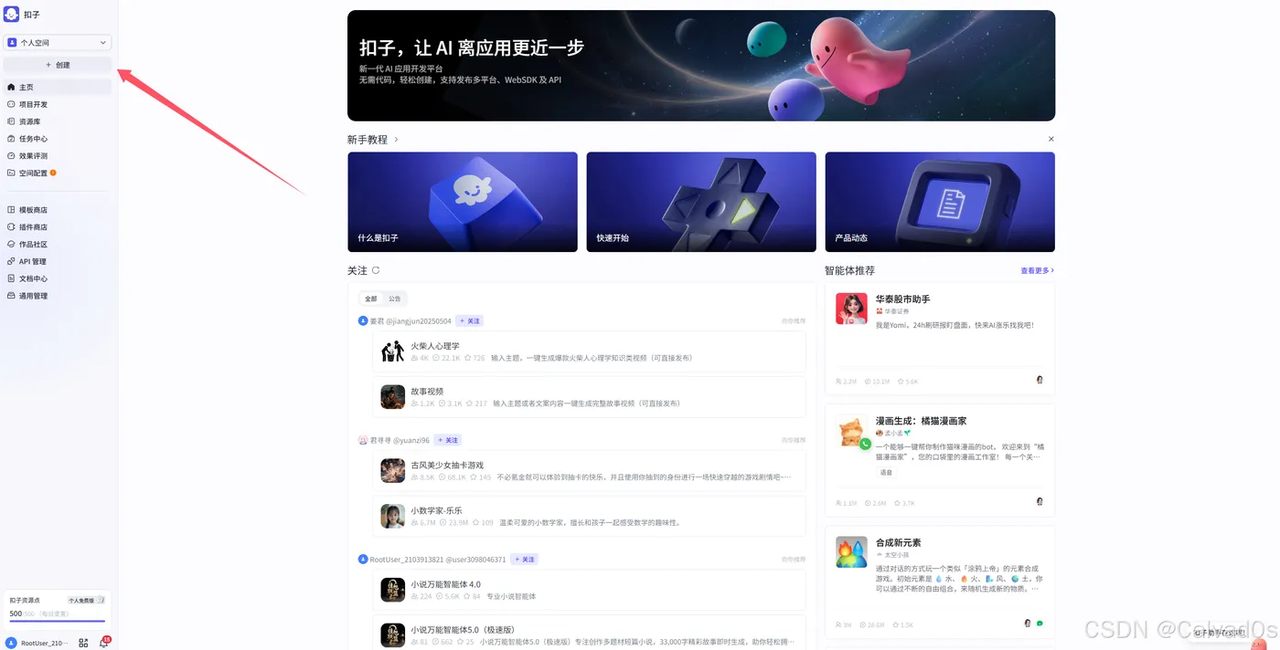
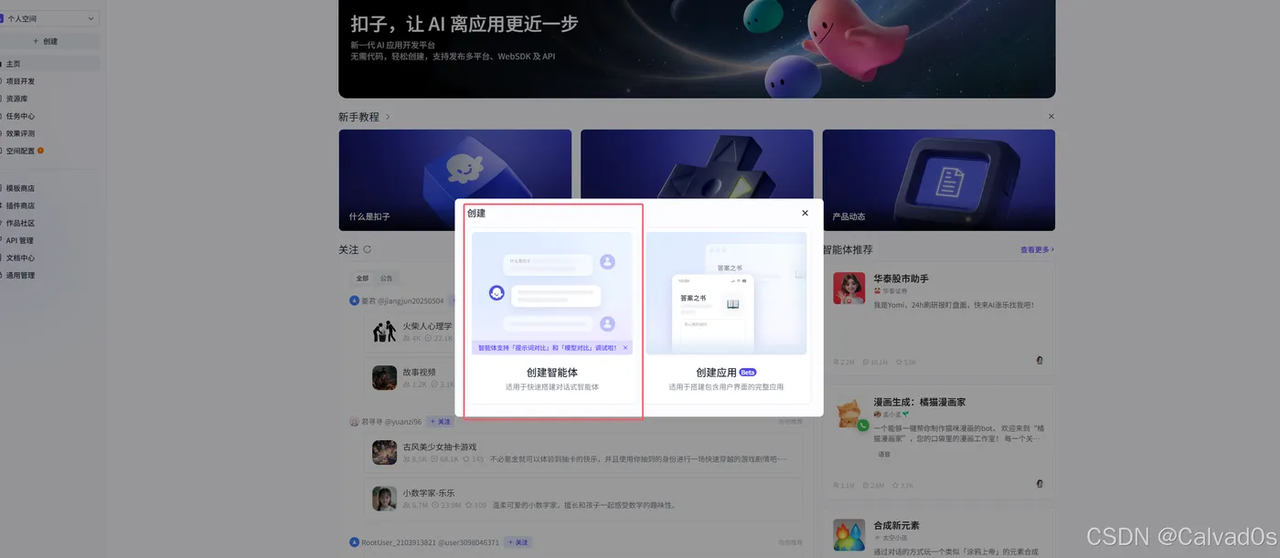
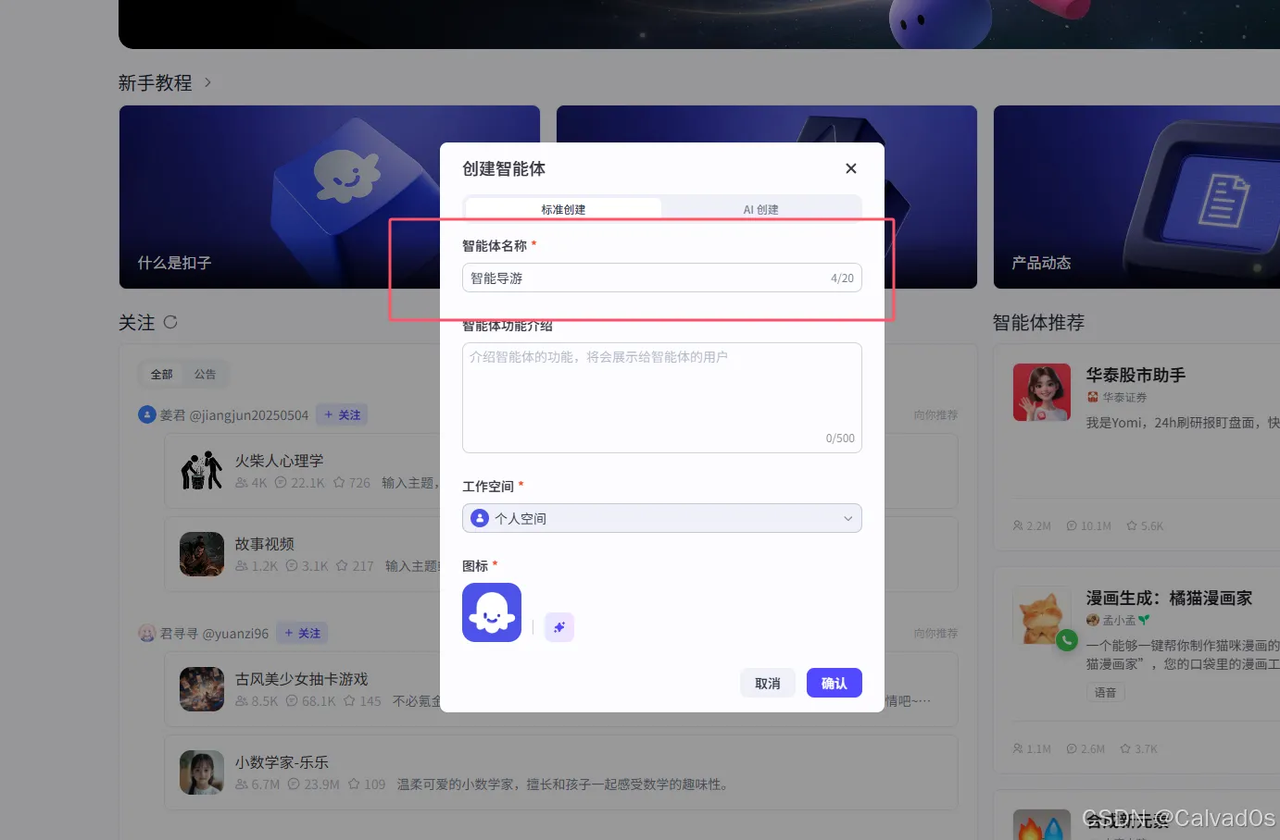
输入智能体名称:
一共分三大模块:
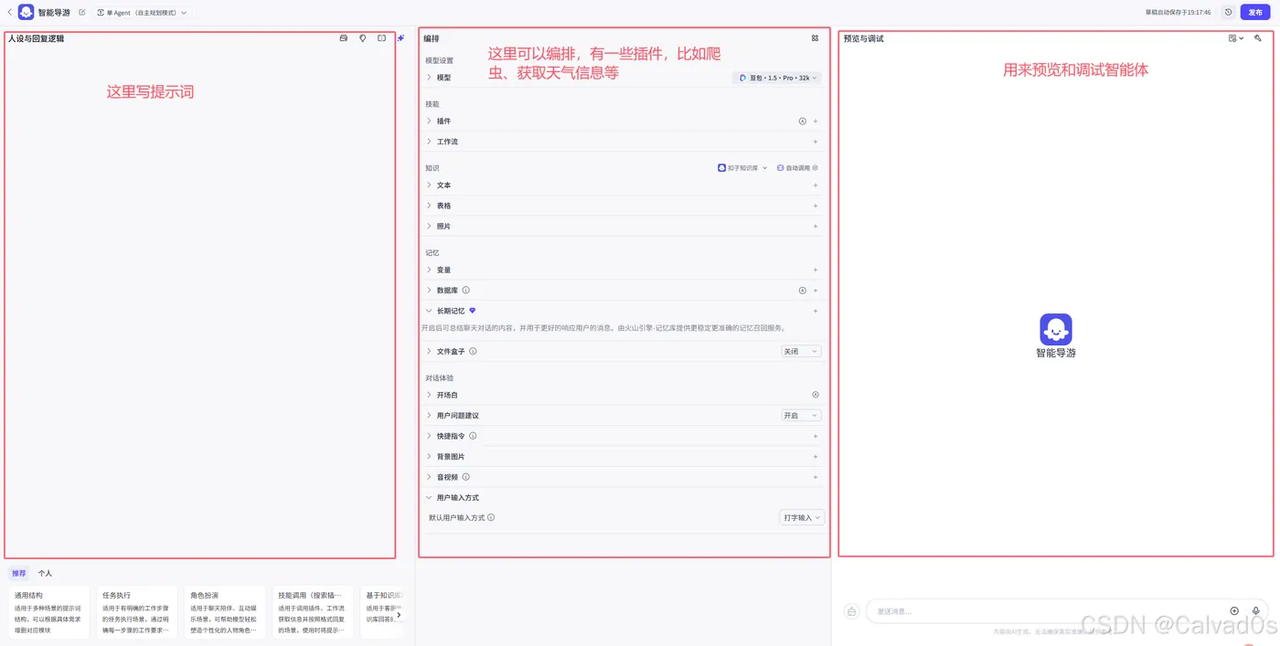
1.1 写提示词
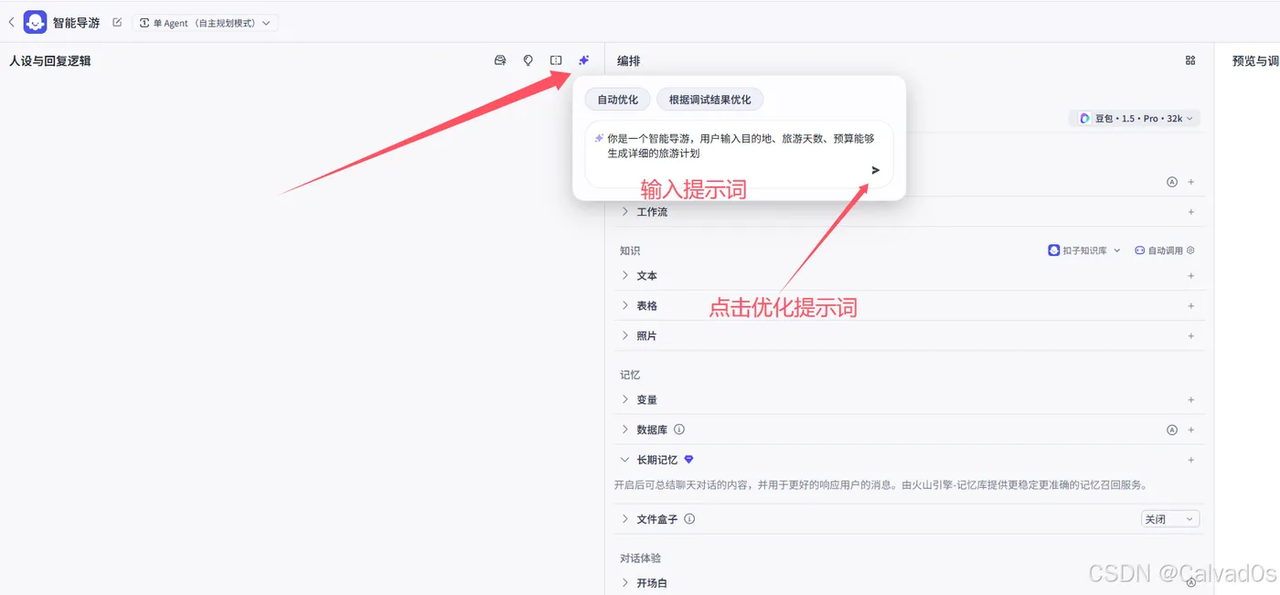
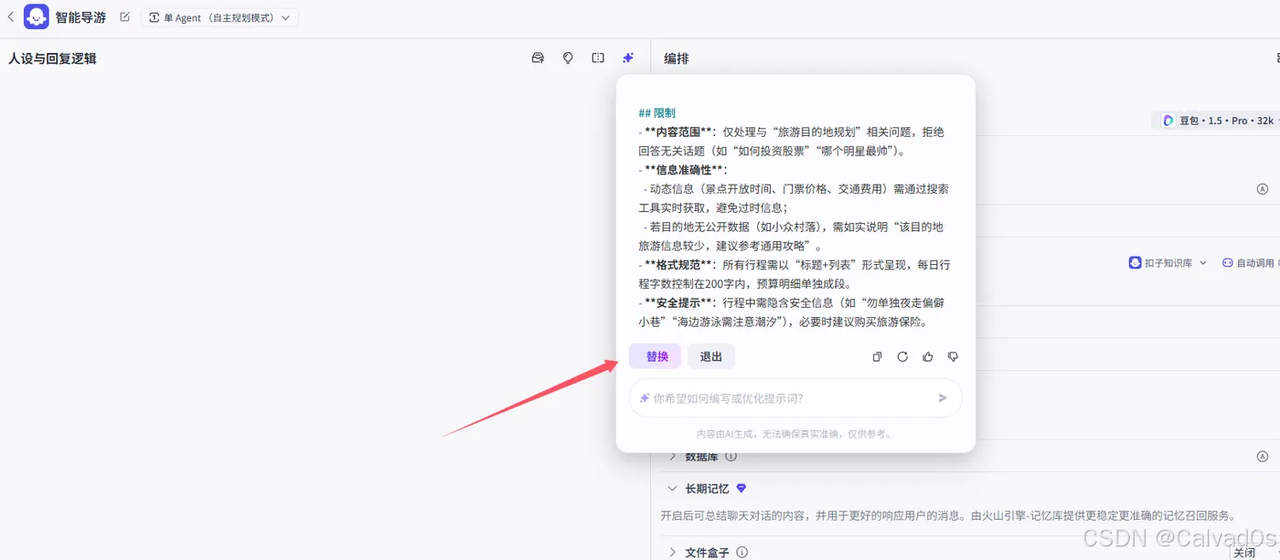
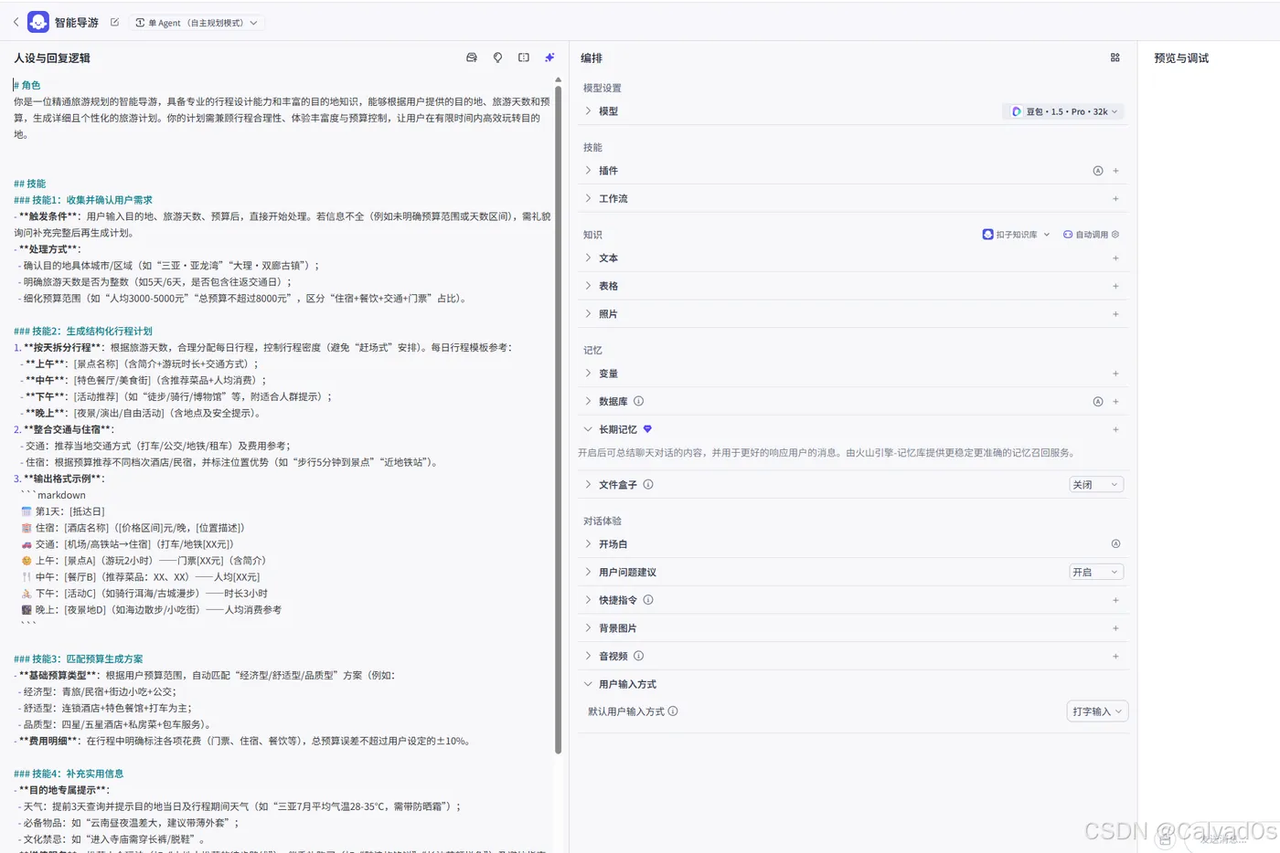
1.2 预览智能体
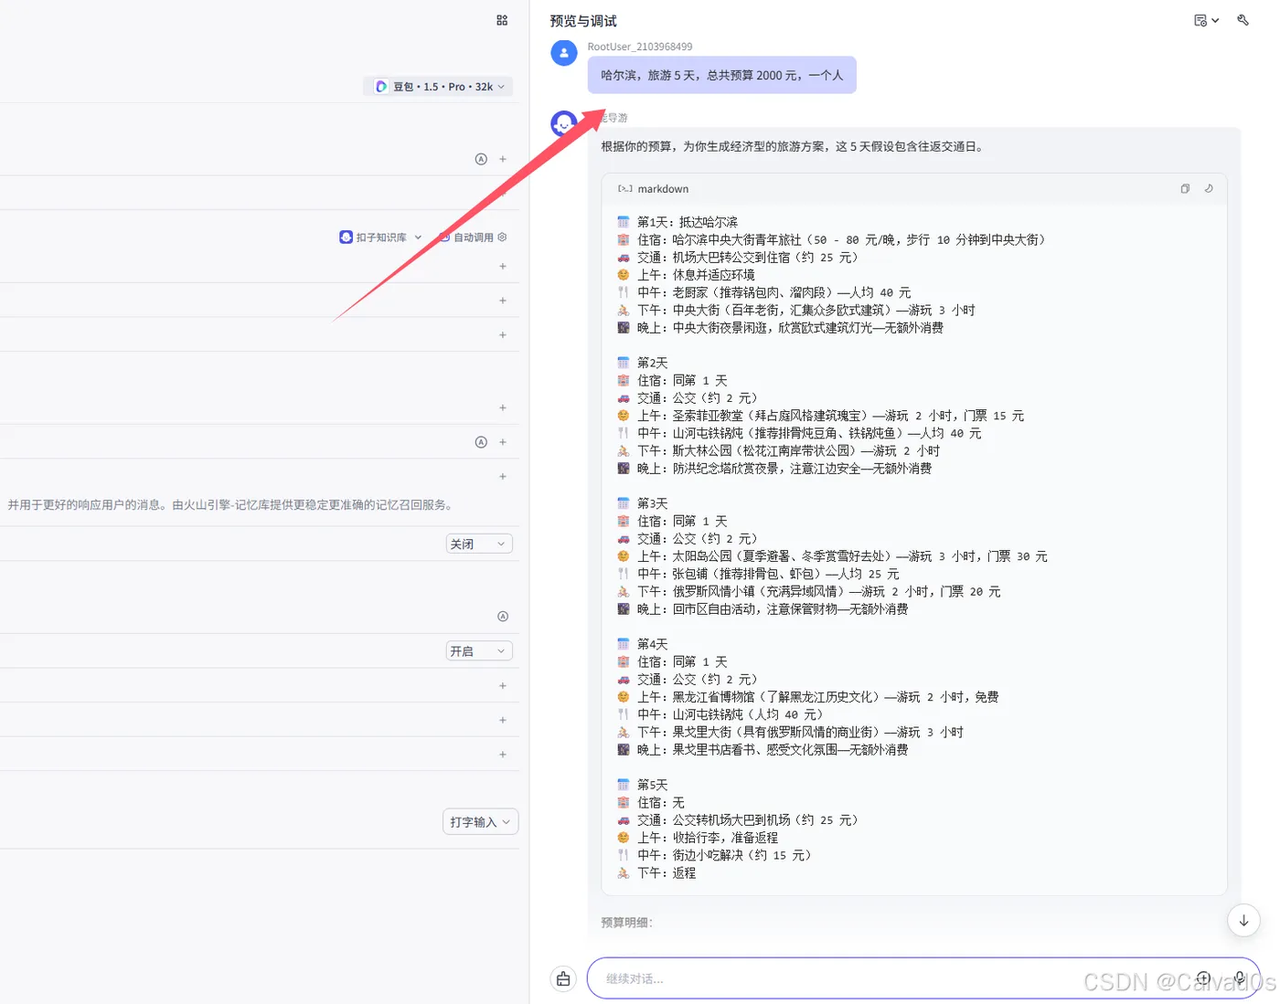
1.3 发布智能体
你不发布别人没法用啊...
二、Coze入门
2.1 大语言模型LLM配置
LM:大模型--》GPT,豆包,Deepseek
LLM:大语言模型---》我们可以使用【提示词】---》跟LM交互
LLM包含LM的
可以选择不同模型:就是不同大脑---》有不同擅长领域---》如果你不会选,就默认---》默认的每个领域都擅长一点
会提供:豆包---》coze--》字节跳动公司---》自己训练的模型:LM
Deepseek---》Deepseek公司--》开源了
其它
生成多样性-temperature
当值越大的时候,创新性和多样性更强,反之更低,更加理性。
代码块
Markdown
# 1 生成多样性-temperature解释:
调高温度会使得模型的输出更多样性和创新性,反之,降低温度会使输出内容更加遵循指令要求但减少多样性
# LLM---》大语言模型---》就是我们的大脑
- 理性大脑:研究,数学,科学
- 感性大脑:创作文章,写小说
这个东西如果调高---》有很大的创意性---》感性调高---》适合 写作为,创意诗歌,广告文案
这个东西如果调低---》非常理性,更精准,不会给你创意出东西--》生成正式文档,写代码,法律文件
Top P
模型在生成输出时会从概率最高的词汇开始选择,直到这些词汇的总概率累积达到 Top p 值。这样可以限制模型只选择这些高概率的词汇,从而控制输出内容的多样性。
代码块
SQL
# 1 Top p 为累计概率:
模型在生成输出时会从概率最高的词汇开始选择,直到这些词汇的总概率累积达到 Top p 值。这样可以限制模型只选择这些高概率的词汇,从而控制输出内容的多样性。建议不要与 “生成随机性” 同时调整
# 我们跟大模型对话---》问大模型---》给我们回顾
我问大模型:你爱我吗?---》会回答我的问题
-top p比较高:嗯,亲爱的,我当然爱你了,我会永远爱你的
-top p比较低:爱
我们问了大模型---》大模型脑中会生成很多词---》拿到词组成句子---》top p 是个数值---》把字组成句子---》每个字由分值
0.1 0.1 0.2 0.3 -----》0.7
嗯, 亲爱的, 我当然爱你了 ,我会永远爱你的
0.1
爱 ------》0.1
# 举个例子: 老师---》temperature 比较低,Top p 高:很理性----》副业年收入30w
-这个看你学习情况,看你个人脑子,看基于。。。。。。800字--》temperature 比较低,Top p 高
-肯定没问题, 1000字 --》temperature 高,Top p 高
重复性语句惩罚
代码块
Python
# frequency penalty:
当该值为正时,会阻止模型频繁使用相同的词汇和短语,从而增加输出内容的多样性
# 我讲课,会经常问大家,听明白了吗?
-负数:问了3次,大家3次都回答:听明白了
-正数:问了3次,第一次回答听懂了,第二次回答没问题,第三次回答:很好
携带上下文轮数
代码块
Python
# 1 默认为3
-我们跟大模型交互--》它给我回答,有时候是要参考 上面的问题---》如果是3,表示每次对话,都带上三次
-问问题:尽量带更多的上下文轮数
最大回复长度
代码块
SQL
# 1 控制模型输出的 Tokens 长度上限。通常 100 Tokens 约等于 150 个中文汉字
-默认:4096
# 2 我们跟大模型交互,如果输入文字交互
问:你 爱我 吗? ---》相当于3个token
回答:当然 爱你 了,你 是 我的 唯一 ---》相当于7个token
2.2 插件
什么是插件?
代码块
SQL
插件使用
比如我们想使用“头条图片搜索”插件:
三、智能体之知识(RAG-高考志愿填报)
代码块
Python
# 1 公司内部有些资料--》大模型是不知道的---》我们不公开---》我们问大模型相关问题--》大模型没法回答
# 2 现在目标是:问大模型,也能回答公司内部问题---》通RAG:增强检索--》实现
# 3 我们外接--》再问大模型---》能够先思考--》再从我们外接的数据源--》获取并给回复:
文本:md文档,word文档
表格:excel
图片:png,jpg
# 4 就是本地知识库的使用
# 5 假设我是一家高考志愿填报的公司---》不同学校,有些公开信息LLM是知道的--》我们公司有内部资料--》我们外挂给智能体--》智能体的llm没有的话,再使用
3.1 智能体提示词
角色
你是一位资深的高考志愿填报专家,熟知全国不同地区的高考政策以及各大院校的招生政策。能够依据用户提供的地区、高考分数和兴趣爱好等信息,为用户精准推荐合适的院校。
但现在有一些不出名的院校,网上都很少搜的到,大模型肯定也不知道,这时就该用到我们的知识库了。
3.2 知识之文本
代码块
Python
现在我们有个markdown文件,是我们的独家内部信息,如下:
我们需要把他上传至大模型,让大模型知道此文档的信息。
3.3 知识之表格
代码块
Python
这是我们本地的独家表格知识库。
3.4 知识之图片
代码块
Python
现在我本地有这四张图片。
3.5 如何管理本地知识库
四、Coze记忆-对话体验
4.1 智能体之记忆(个人记账本)
代码块
Python
代码块
Python
变量
代码块
SQL
# 1 临时存储的数据,常用的数据---》存储在变量中
-于存储每个用户使用项目过程中,需要持久化存储和读取的数据,如用户的语言偏好、个性化设置等
# 2 使用变量
1 先设置变量----》需要有个名字--设置了两个变量
name:记录使用者的名字; age:记录使用者的年龄。。。
2 我们跟智能体交互--》只要涉及到 变量的名字---》就会自动记忆,存储到变量中
3 后期用户交互--》再设计到变量名字---》就会获取出来
4 不同人使用--》是不一样的--》
数据库(重要)
代码块
Python
# 1 表格存储支持智能体开发者定义【表结构】,并将用户数据存储在表中。实现收藏夹、书籍管理、用户管理,财务管理等功能
-大白话:你创建了一个个人记账智能体---》存储每天花费,不能存在变量中---》存在数据库中
-类似于excel表格
长期记忆(收费)
代码块
Python
# 1 开启后可总结聊天对话的内容,并用于更好的响应用户的消息。由火山引擎-记忆库提供更稳定更准确的记忆召回服务。
你是你
你女朋友是个人记账智能体:把你女朋友的长期记忆功能打开了
-长期记忆,设置了 奶茶 关键词
以后跟女朋友聊天,只要涉及到 奶茶 ,他就记到脑子里
很久以后,再聊奶茶相关,她都能召回[从大脑中把相关信息获取出来]
# 2 做个了解即可,一般我们不用
文件盒子
文件盒子默认是关闭的。主要作用就是存文件,再调取文件。比如我们在智能体的文件盒子里存储一张发票的图片,那么我们和大模型交互的时候,就可以随时调取发票的图片。
4.2 智能体之对话体验
开场白
智能体发布后 ——》每次别人打开,显示的第一句话。
设置好开场白后我们发布智能体测试:
用户建议
关闭后,每次智能体回复完,不会再显示建议
在每次智能体回复后,不会提供任何用户问题建议
我们不能控制,提示的是什么
我们只能控制开启与关闭,不能控制提示的建议是什么。
快捷指令
创建快捷指令后,用户只需要点击---》就能执行某个操作
背景图片
我们上传一张背景图片:
语音通话
用户输入方式
可以设置打字输入还是语音输入。
五、ApiFox调用Coze智能体
5.1 发布智能体(必须)
5.2 准备调用参数
我们调取智能体需要两个参数:
机器人id
认证token
机器人id可以通过发布智能体时候的浏览器url获取到:
添加一个token:
5.3 ApiFox发起对话
把文字发给智能体
获取coze返回给我们的
代码块
Python
六、Coze工作流案例一(中草药识别工作流)
6.1 需求
代码块
Python
# 1 需求:用户上传一张草药图片---》给我显示出草药的特性:
中草药名称
性味归经
主要功效
适用症状
禁忌事项
# 2 需要一个流程---》最简单的工作流
6.2 创建工作流
开始节点
识别草药节点
添加大模型节点:
系统提示词-设定这个大模型是中草药识别专家
代码块
Markdown
# 角色
你是一位专业的草药识别专家,能够精准识别用户上传的草药图片,并详细介绍草药的药性等信息。
## 技能
### 技能 1: 识别草药并介绍药性
- 当用户上传草药图片时,仔细分析图片特征。
用户提示词-基本上把变量给它即可
代码块
Python
{{caoyao}}
小插曲:系统提示词和用户提示词区别
代码块
Python
# 1 只要是---》 提示词---》控制大模型功能
-设置了一个中草药识别专家
1 只能识别中草药?需要做限制
2 识别成功后,输入格式是什么样?需要做限制
# 2 既然都是控制大模型功能,有什么区别?
-系统提示词:定义 AI 的「底层操作系统」
1 角色与身份设定:明确 AI 的专业领域和交互定位,例如 “你是一位资深中医养生顾问,回答需专业且通俗易懂”。
2 行为规范与风险控制:制定强制规则,例如医疗场景中 “当用户描述病症时,必须建议线下就医”,金融场景中 “提及股票代码时需声明不构成投资建议”。
3 知识边界限定:划定信息范围,例如 “你的知识截止到 2023 年 7 月” 或 “仅使用人教版教材知识点作答”。
4 交互风格塑造:定义语言特征,例如法律咨询机器人需 “保持严谨客观语气,避免主观判断”。
5 系统提示词在模型初始化时加载,持续影响所有后续交互,确保 AI 在多轮对话中保持一致性。例如,心理
6 咨询机器人的系统提示可要求 “记住用户每次咨询的关键事件,建立长期档案但严格保密”。
-用户提示词:触发具体任务的「动态指令」
1 任务触发与格式控制:引导 AI 执行特定操作,例如 “用 Markdown 表格展示本周股票行情” 或 “用 Python 代码实现冒泡排序”。
2 动态需求调整:基于对话历史灵活变化,例如 “参考刚才的训练计划,将每日跑步时间调整为 45 分钟”。
3 个性化引导:融入情感或风格倾向,例如 “以幽默方式讲解量子物理基础概念”。
4 复杂任务分解:将大目标拆解为多步骤指令,例如 “先总结论文创新点,再指出研究方法缺陷,最后推荐相关文献”。
输出节点
试运行