coze搭建作业智能体(图片识别+语音合成+知识听写)
上传两张英语单词词汇图片:
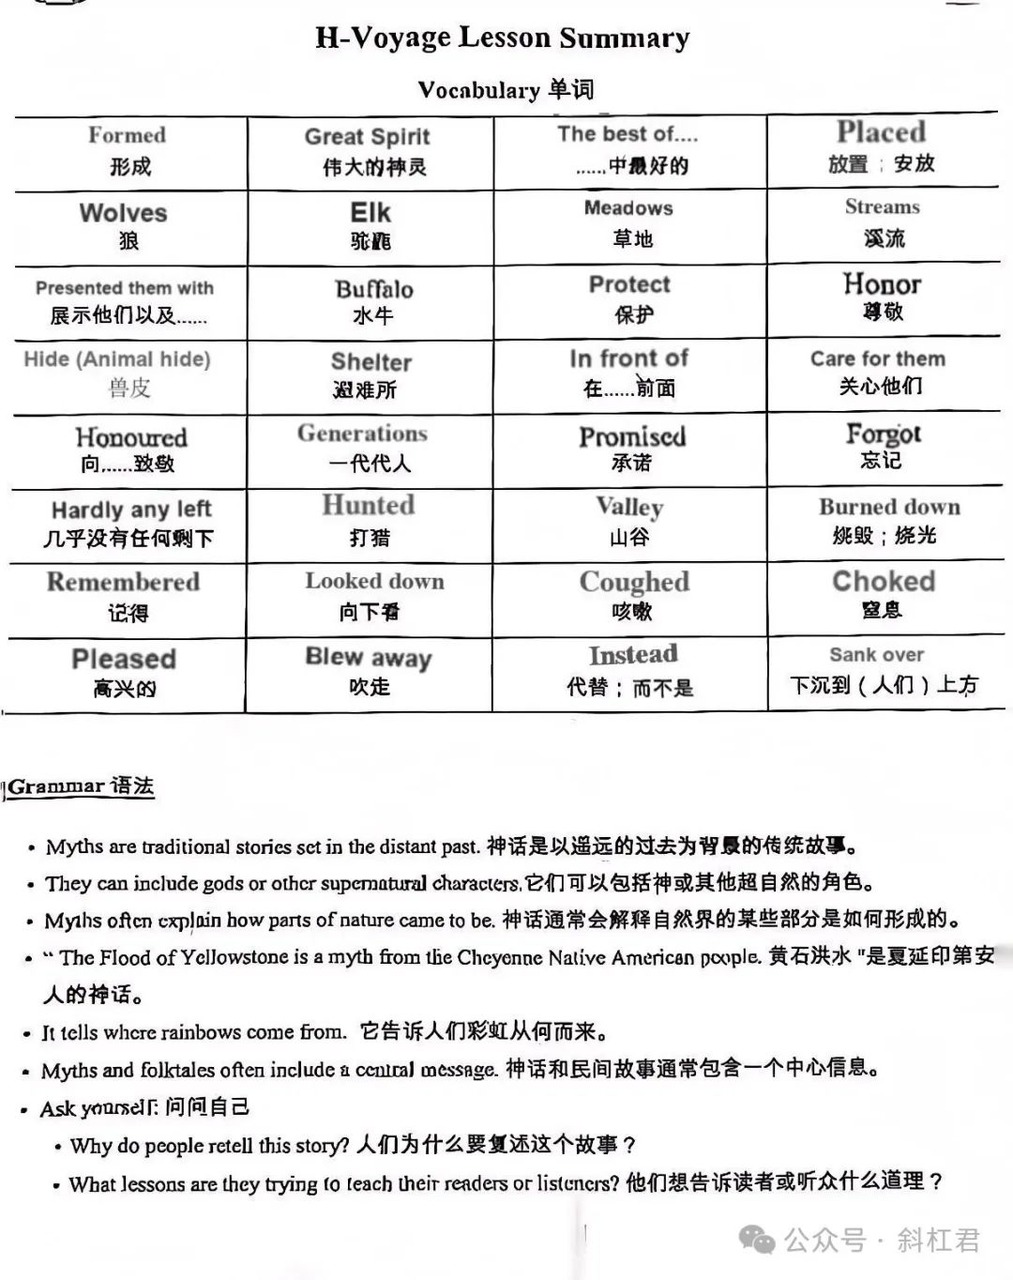
50%
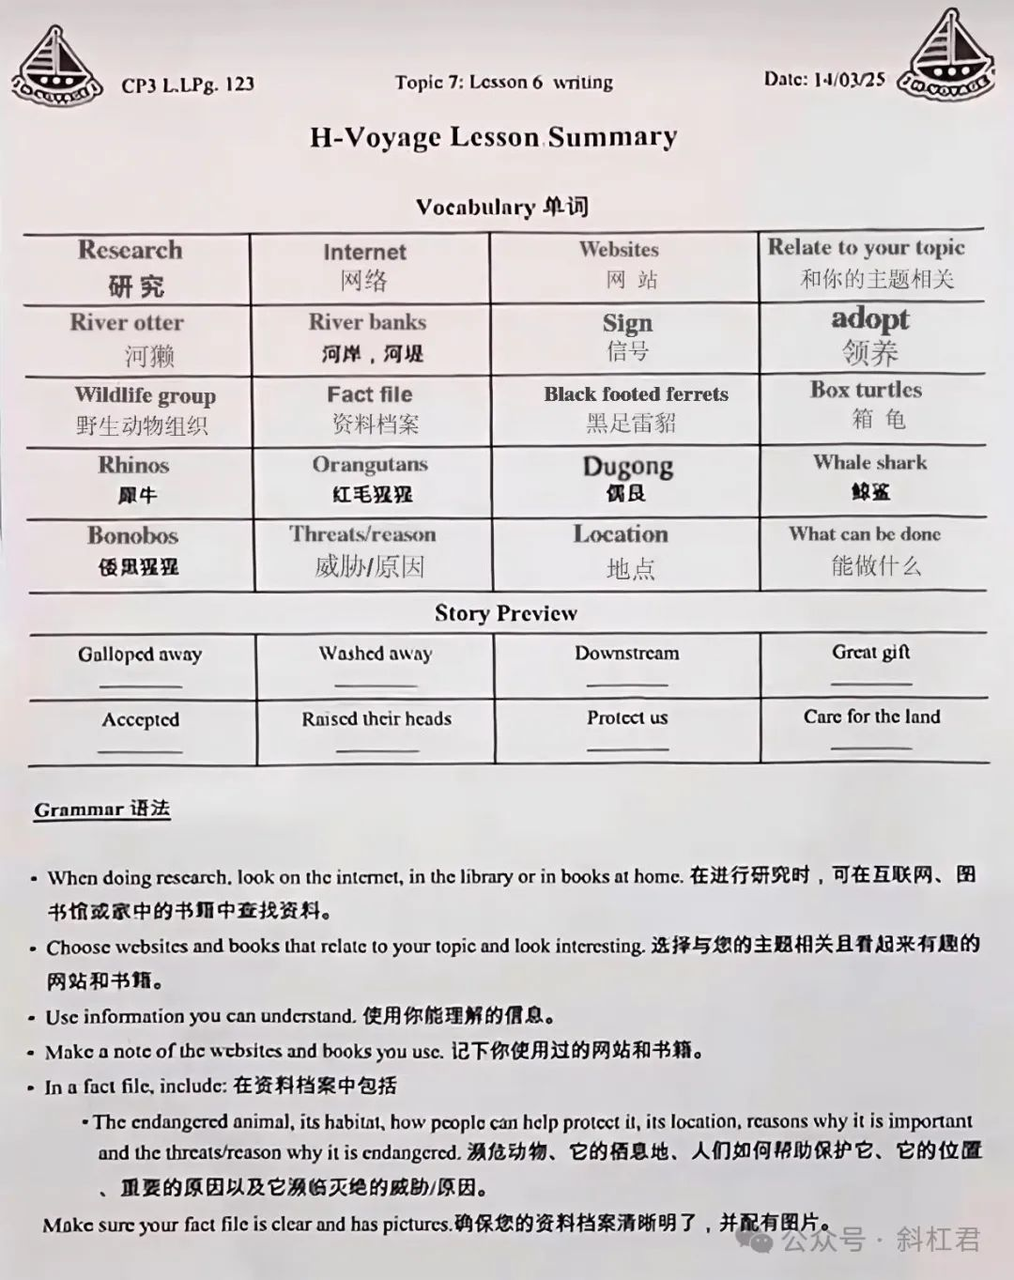
50%
一、基本逻辑流程
💾
1.开始上传英语词汇图片;
2.通过大模型OCR识别插件,根据所设条件识别所需单词;
3.通过大模型进一步准确筛选所需内容,并输出文字列表;
4.通过批处理带功能插件,将文字列表转换为语音列表;
5.通过代码在语音列表中增加重复内容和空白内容,生成新的语音数组;
6.合成单词语音数组,生成一个完整语音。
二、创建工作流
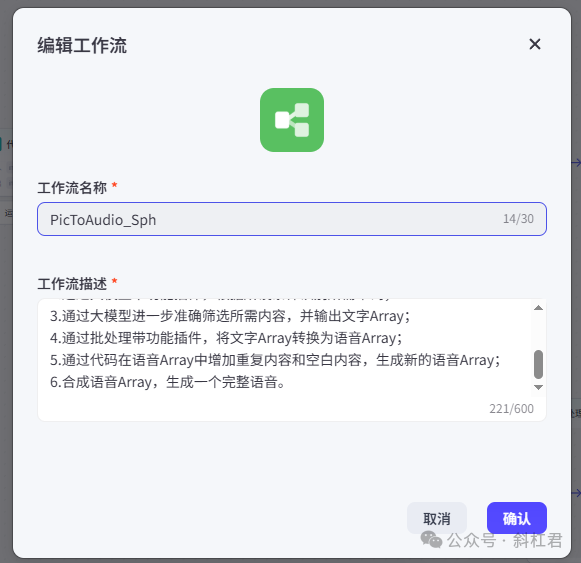
1、首先新建一个工作流。
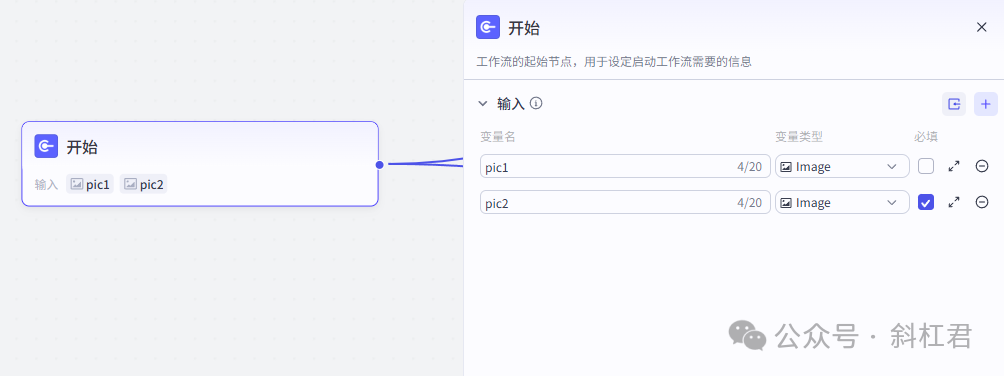
2、开始节点
开始节点设置两个变量(这里可以设置多个上传变量),用来接收两张或多个上传的英语单词图片。
3、大模型节点
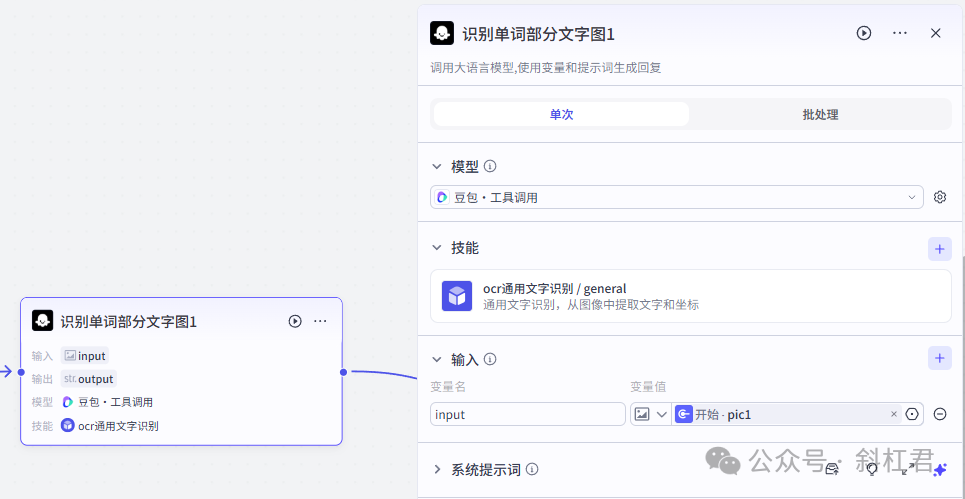
大模型节点加入「OCR通用文字识别」插件,用来识别上传图片的单词,把单词提取出来成一个数组。
5、代码节点
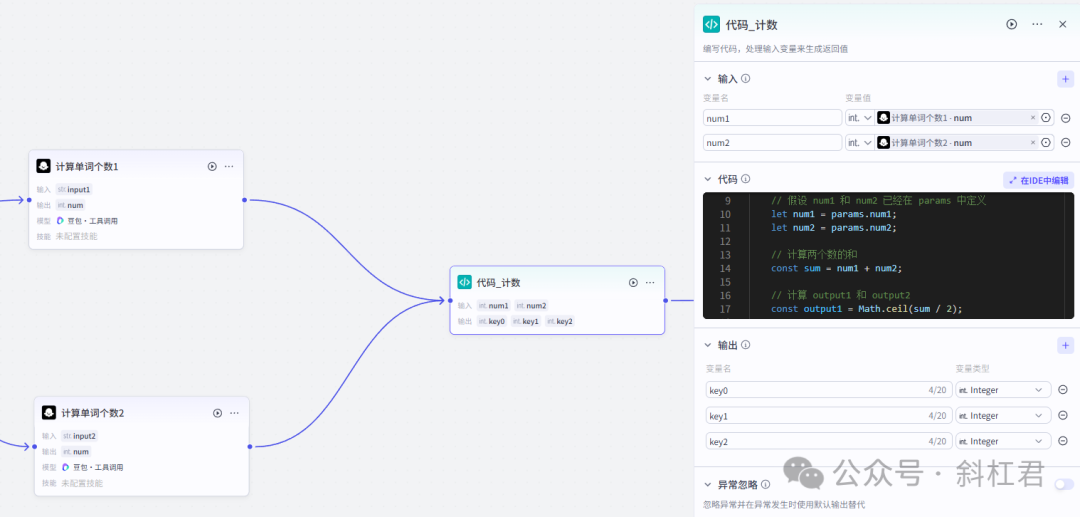
代码节点用来计算所有上传图片一共有多少个单词数量。
6、批处理节点
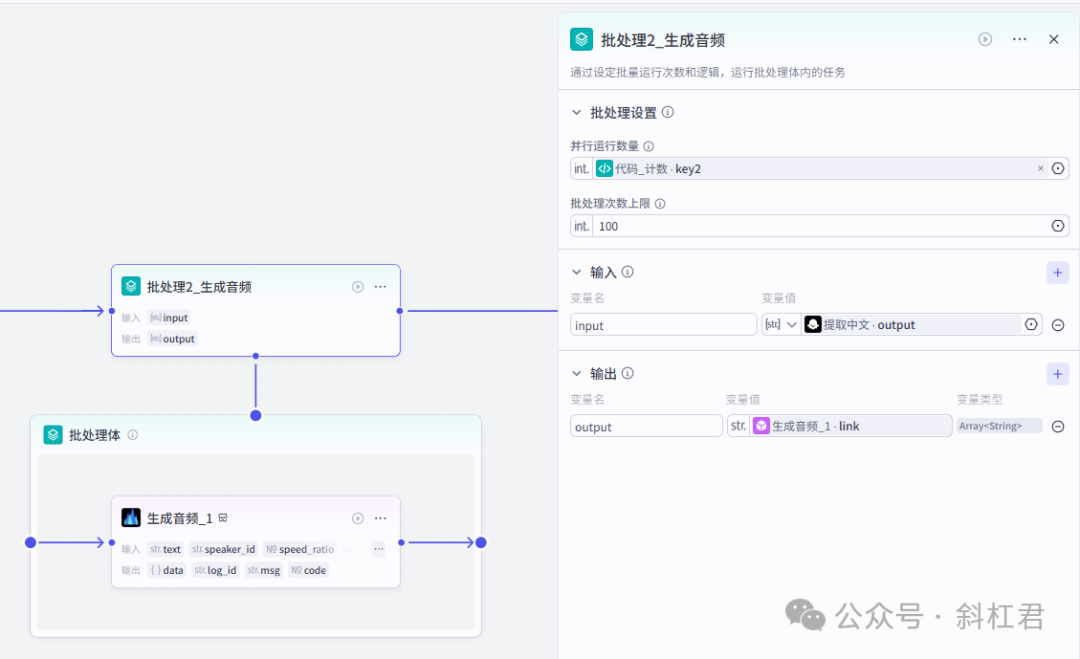
添加一个批处理节点,使用批处理节点生成所有单词的音频文件。
7、代码节点
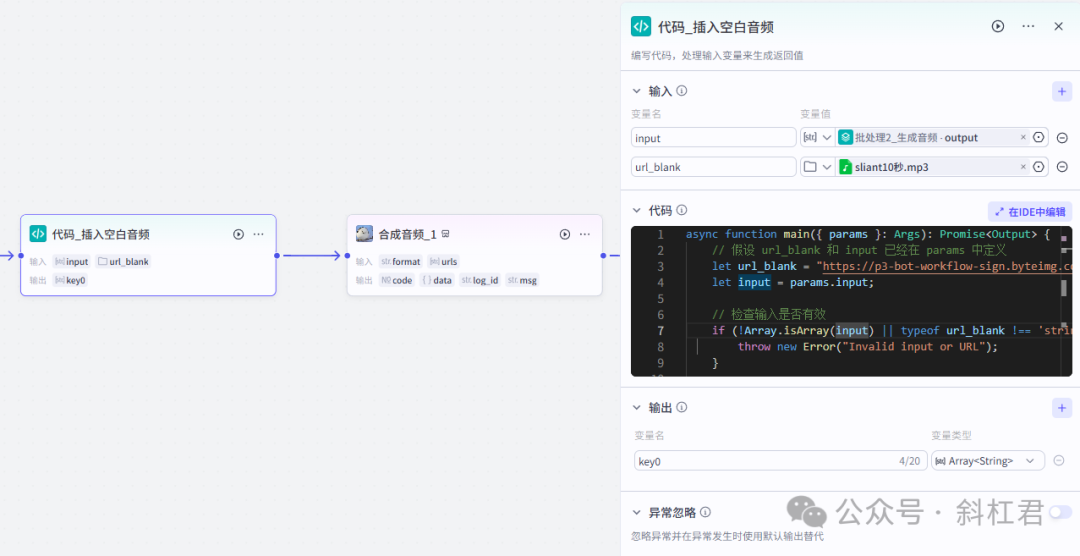
使用一个代码节点导入一段空白音频,把每个单词中间插入一个单词听写的留白时间,然后输出一个单词音频数组。
8、合成音频
使用「音频处理工具」对单词音频数组进行合成,合成一整段音频,每个音频之间听写的留白时间。
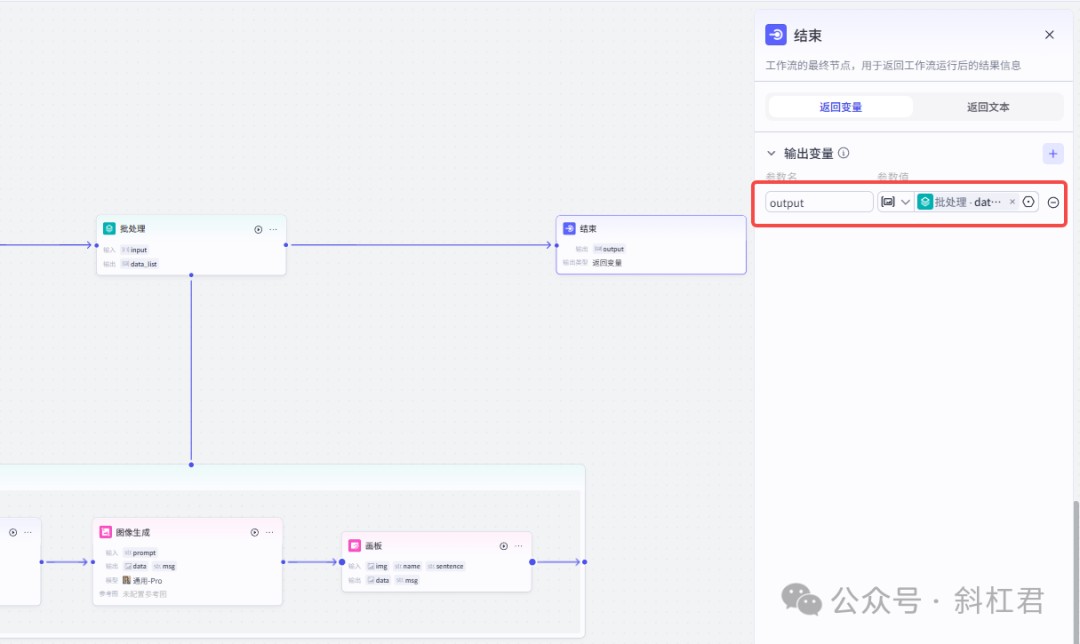
9、结束节点
最后,使用结束节点输出合成后的音频文件。