大语言模型训练:什么是RLHF?
本指南详解RLHF的三个关键阶段:监督微调(SFT)、奖励模型训练、PPO策略优化,并深入分析奖励模型设计、RLHF与DPO的对比,以及ChatGPT等产品背后的RLHF实践。
什么是RLHF
RLHF(Reinforcement Learning from Human Feedback,基于人类反馈的强化学习)是让大语言模型与人类偏好对齐的核心技术。
RLHF的定义
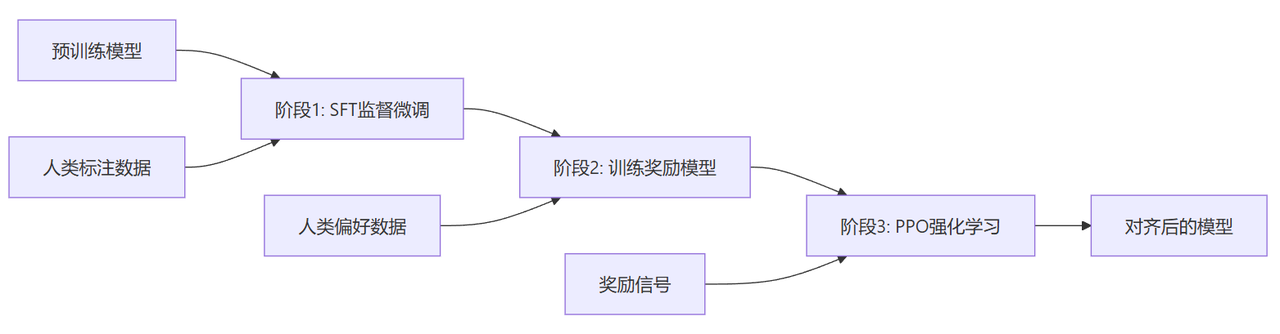
RLHF是一种结合强化学习和人类反馈的模型训练方法。它的核心思想是:通过人类对模型输出的偏好判断,训练一个奖励模型来评估输出质量,然后用强化学习优化语言模型,使其生成能获得高奖励的内容。
RLHF的核心优势
与传统训练方法相比,RLHF具有独特优势:
捕捉隐性偏好:人类很难明确描述什么是"好回答",但可以轻松比较两个回答的优劣
持续改进:可以根据新的人类反馈不断优化模型
安全对齐:有效减少有害输出,提高模型安全性
用户体验优化:生成更符合用户期望的内容
RLHF三阶段详解
阶段一:监督微调(SFT)
监督微调是RLHF的第一步,目的是让预训练模型学会按照指令格式生成回答。
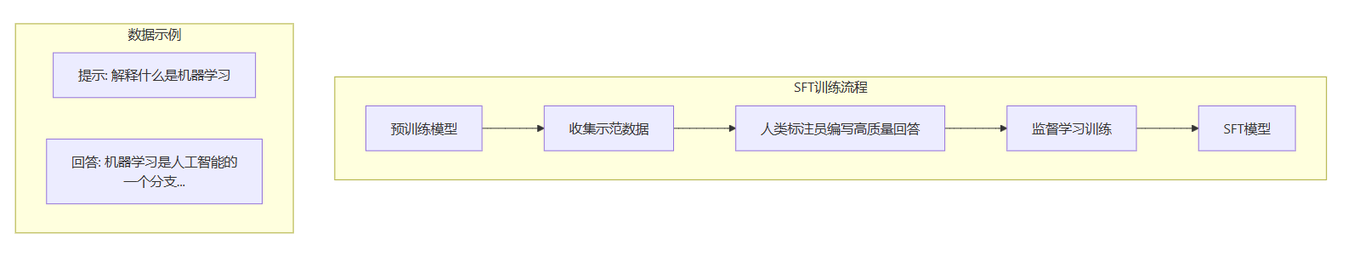
SFT数据准备要点:
代码块
Python
sft_data_example = {
"prompt": "请用简单的语言解释什么是量子计算",
"response": """量子计算是一种利用量子力学原理进行计算的新型计算方式。
与传统计算机使用0和1的比特不同,量子计算机使用量子比特(qubit),
它可以同时处于0和1的叠加状态,这使得量子计算机在某些特定问题上
具有指数级的计算优势。
SFT训练的关键参数:
#wFxldWbSViUJ text { white-space: pre; }#wFxldWbSViUJ .fb0 { stroke: var(--N900-FG, 0.15); }#wFxldWbSViUJ .fb0 {stroke: rgba(31,35,41, 0.15)}#wFxldWbSViUJ .fx0 { stroke-miterlimit: 10; }#wFxldWbSViUJ .fx0 {stroke-miterlimit: 10}#wFxldWbSViUJ .fa1 { fill: rgb(187, 191, 196); }#wFxldWbSViUJ .fa1 {fill: rgb(187, 191, 196)}#wFxldWbSViUJ .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#wFxldWbSViUJ .fx1 {font-style: normal}#wFxldWbSViUJ .fx2 { text-anchor: middle; }#wFxldWbSViUJ .fx2 {text-anchor: middle}#wFxldWbSViUJ .fx3 { dominant-baseline: central; }#wFxldWbSViUJ .fx3 {dominant-baseline: central}#wFxldWbSViUJ .fx4 { stroke: none; }#wFxldWbSViUJ .fx4 {stroke: none}#wFxldWbSViUJ .fc0 { fill: var(--text-caption); }#wFxldWbSViUJ .fc0 {fill: #646a73}#wFxldWbSViUJ .fa2 { fill: var(--text-link-disabled); }#wFxldWbSViUJ .fa2 {fill: rgb(187, 191, 196)}#wFxldWbSViUJ .fa3 { fill: rgb(246, 248, 250); }#wFxldWbSViUJ .fa3 {fill: rgb(246, 248, 250)}#wFxldWbSViUJ .fx5 { font: 400 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#wFxldWbSViUJ .fx5 {font-style: normal}#wFxldWbSViUJ .fx6 { text-anchor: start; }#wFxldWbSViUJ .fx6 {text-anchor: start}#wFxldWbSViUJ .fx7 { dominant-baseline: alphabetic; }#wFxldWbSViUJ .fx7 {dominant-baseline: alphabetic}#wFxldWbSViUJ .fc1 { fill: rgb(51, 51, 51); }#wFxldWbSViUJ .fc1 {fill: rgb(51, 51, 51)}#wFxldWbSViUJ .fb1 { fill: var(--N900-FG, 0.15); }#wFxldWbSViUJ .fb1 {fill: rgba(31,35,41, 0.15)}#wFxldWbSViUJ .fb2 { fill: rgb(225, 228, 232); }#wFxldWbSViUJ .fb2 {fill: rgb(225, 228, 232)}#wFxldWbSViUJ .fa4 { fill: var(--bg-body); }#wFxldWbSViUJ .fa4 {fill: #fff}ABC1234参数学习率训练轮次数据量推荐值1e-5 ~ 5e-51-3 epochs10K-100K说明较小学习率避免遗忘预训练知识防止过拟合高质量示范数据
阶段二:奖励模型训练
奖励模型(Reward Model)是RLHF的核心组件,它学习人类的偏好来评估模型输出的质量。
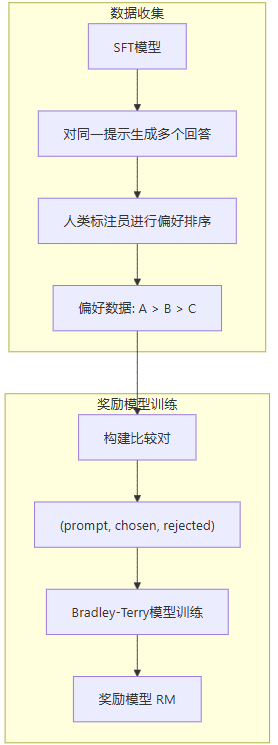
奖励模型的数学原理:
奖励模型基于Bradley-Terry模型,给定两个回答,模型学习预测人类更偏好哪一个:
代码块
Plain Text
P(y_chosen > y_rejected | x) = σ(r(x, y_chosen) - r(x, y_rejected))
其中:
•
r(x, y) 是奖励模型对输入x和输出y的评分
•
σ 是sigmoid函数
•
训练目标是最大化这个概率
奖励模型训练代码示例:
代码块
Python
import torch
import torch.nn as nn
from transformers import AutoModelForSequenceClassification
class RewardModel(nn.Module):
def __init__(self, model_name):
super().__init__()
self.model = AutoModelForSequenceClassification.from_pretrained(
model_name,
num_labels=1
)
def forward(self, input_ids, attention_mask):
outputs = self.model(
input_ids=input_ids,
偏好数据收集的最佳实践:
多样化标注员:避免单一视角的偏见
清晰的标注指南:定义什么是"更好"的回答
质量控制:定期检查标注一致性
数据量:通常需要50K-500K比较对
阶段三:PPO策略优化
PPO(Proximal Policy Optimization)是RLHF中最常用的强化学习算法,用于优化语言模型以获得更高的奖励。
PPO在RLHF中的目标函数:
代码块
Plain Text
maximize E[r(x, y) - β * KL(π || π_ref)]
其中:
•
r(x, y) 是奖励模型的评分
•
KL(π || π_ref) 是当前策略与参考策略的KL散度
•
β 是KL惩罚系数,防止模型偏离太远
为什么需要KL散度约束:
PPO训练的关键超参数:
代码块
Python
ppo_config = {
"learning_rate": 1e-5,
"batch_size": 64,
"mini_batch_size": 16,
"ppo_epochs": 4,
"kl_penalty": "kl",
"init_kl_coef": 0.2,
"target_kl": 6.0,
"clip_range": 0.2,
"value_clip_range": 0.2,
"gamma": 1.0,
"lam": 0.95,
}
奖励模型深入解析
奖励模型的架构设计
奖励模型通常基于与策略模型相同的预训练模型,但输出层改为标量奖励值:
代码块
Plain Text
┌─────────────────────────────────────────────┐
│ 奖励模型架构 │
├─────────────────────────────────────────────┤
│ 输入: [prompt + response] │
│ ↓ │
│ Transformer编码器(共享预训练权重) │
│ ↓ │
│ 最后一个token的隐藏状态 │
│ ↓ │
│ 线性层 → 标量奖励值 │
└─────────────────────────────────────────────┘
奖励模型的常见问题
奖励黑客攻击(Reward Hacking)
模型可能学会利用奖励模型的漏洞,生成获得高奖励但实际质量差的输出。
解决方案:
•
增加KL散度惩罚
•
使用多个奖励模型集成
•
定期更新奖励模型
分布外泛化
奖励模型在训练分布外的输入上可能表现不佳。
解决方案:
•
扩大训练数据的多样性
•
使用不确定性估计
•
限制策略模型的探索范围
RLHF vs DPO对比
DPO(Direct Preference Optimization)是RLHF的一种简化替代方案,它直接从偏好数据优化策略,无需训练单独的奖励模型。
详细对比
DPO的数学原理
DPO的核心洞察是:最优策略可以直接用偏好数据表示,无需显式的奖励模型:
代码块
Plain Text
其中 y_w 是偏好的回答,y_l 是不偏好的回答。
如何选择
选择RLHF:
•
需要精细控制奖励函数
•
有足够的计算资源
•
追求最佳效果
•
奖励模型需要复用
选择DPO:
•
计算资源有限
•
快速迭代验证
•
偏好数据充足
•
追求训练稳定性
InstructGPT和ChatGPT的RLHF实践
InstructGPT的三阶段训练
OpenAI在2022年发布的InstructGPT论文详细描述了RLHF的实践:
关键数据统计:
ChatGPT的改进
ChatGPT在InstructGPT基础上进行了多项改进:
对话格式优化:专门针对多轮对话场景训练
安全性增强:更严格的有害内容过滤
持续迭代:根据用户反馈不断更新
规模扩大:更大的模型和更多的训练数据
RLHF的挑战与局限性
主要挑战
人类反馈的质量和一致性
代码块
Plain Text
┌─────────────────────────────────────────────┐
│ 人类反馈的挑战 │
├─────────────────────────────────────────────┤
│ • 标注员之间的不一致性 │
│ • 标注员的个人偏见 │
奖励模型的局限性
•
可能无法捕捉所有人类偏好维度
•
容易被策略模型利用(reward hacking)
•
分布外泛化能力有限
训练不稳定性
•
PPO训练需要精细调参
•
多个模型协同训练的复杂性
•
计算资源需求大
解决方案和未来方向
常见问题
RLHF和普通微调有什么区别?
普通微调(如SFT)直接从标注数据学习,模型学习的是"标准答案"。而RLHF通过人类偏好比较学习,模型学习的是"什么样的回答更好"。RLHF能够捕捉难以明确描述的隐性偏好,比如回答的有用性、安全性和风格。
训练奖励模型需要多少偏好数据?
数据量取决于任务复杂度和期望效果。OpenAI的InstructGPT使用了约33,000对比较数据。一般建议至少准备10,000-50,000对高质量的偏好比较数据。关键是数据的多样性和标注质量,而非单纯追求数量。
PPO训练不稳定怎么办?
PPO训练不稳定是常见问题。建议:1)使用较小的学习率(1e-6到1e-5);2)增加KL惩罚系数;3)使用梯度裁剪;4)从小规模实验开始调参;5)考虑使用DPO等更稳定的替代方案。
RLHF能完全解决AI安全问题吗?
RLHF是提高AI安全性的重要技术,但不能完全解决所有安全问题。它依赖于人类反馈的质量,而人类标注员可能有偏见或遗漏某些风险场景。RLHF应该与其他安全措施(如内容过滤、红队测试)结合使用。
小团队能实施RLHF吗?
可以,但需要根据资源调整方案。建议:1)使用较小的基础模型(7B-13B);2)考虑使用DPO替代完整RLHF流程;3)利用开源工具如TRL库;4)从小规模实验开始;5)使用QLoRA等技术降低显存需求。
总结
RLHF是让大语言模型与人类偏好对齐的核心技术,它通过三个阶段实现模型的对齐优化:
监督微调(SFT):让模型学会遵循指令格式
奖励模型训练:将人类偏好转化为可量化的奖励信号
PPO优化:通过强化学习最大化奖励,同时保持模型稳定性
理解RLHF不仅有助于你更好地使用ChatGPT等AI产品,也为你进入AI对齐研究领域奠定基础。随着DPO等新技术的出现,模型对齐正变得更加高效和易于实施。
掌握RLHF技术,你将能够训练出更安全、更有用、更符合人类期望的AI模型,在AI应用开发中占据技术优势。