大语言模型训练:什么是模型量化?
本指南涵盖量化核心原理、主流量化方法(GPTQ、AWQ、GGUF)、训练后量化与量化感知训练的区别,并提供llama.cpp和bitsandbytes的实战代码。
什么是模型量化
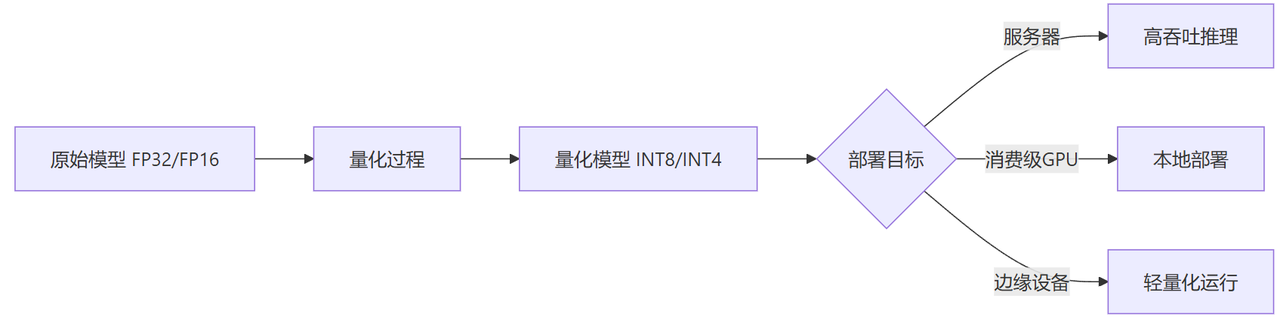
模型量化是将大语言模型的权重从高精度(如FP32、FP16)转换为低精度(如INT8、INT4)的技术,可大幅减少模型体积和推理所需显存,同时保持较好的模型性能。
量化的基本概念
模型量化是一种模型压缩技术,通过降低模型权重和激活值的数值精度来减少模型大小和计算需求。简单来说,就是用更少的比特位来表示原本需要更多比特位的数值。
为什么需要量化
#PgUqiBEOMcUA text { white-space: pre; }#PgUqiBEOMcUA .fb0 { stroke: var(--N900-FG, 0.15); }#PgUqiBEOMcUA .fb0 {stroke: rgba(31,35,41, 0.15)}#PgUqiBEOMcUA .fx0 { stroke-miterlimit: 10; }#PgUqiBEOMcUA .fx0 {stroke-miterlimit: 10}#PgUqiBEOMcUA .fa1 { fill: rgb(187, 191, 196); }#PgUqiBEOMcUA .fa1 {fill: rgb(187, 191, 196)}#PgUqiBEOMcUA .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#PgUqiBEOMcUA .fx1 {font-style: normal}#PgUqiBEOMcUA .fx2 { text-anchor: middle; }#PgUqiBEOMcUA .fx2 {text-anchor: middle}#PgUqiBEOMcUA .fx3 { dominant-baseline: central; }#PgUqiBEOMcUA .fx3 {dominant-baseline: central}#PgUqiBEOMcUA .fx4 { stroke: none; }#PgUqiBEOMcUA .fx4 {stroke: none}#PgUqiBEOMcUA .fc0 { fill: var(--text-caption); }#PgUqiBEOMcUA .fc0 {fill: #646a73}#PgUqiBEOMcUA .fa2 { fill: var(--text-link-disabled); }#PgUqiBEOMcUA .fa2 {fill: rgb(187, 191, 196)}#PgUqiBEOMcUA .fa3 { fill: rgb(246, 248, 250); }#PgUqiBEOMcUA .fa3 {fill: rgb(246, 248, 250)}#PgUqiBEOMcUA .fx5 { font: 400 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#PgUqiBEOMcUA .fx5 {font-style: normal}#PgUqiBEOMcUA .fx6 { text-anchor: start; }#PgUqiBEOMcUA .fx6 {text-anchor: start}#PgUqiBEOMcUA .fx7 { dominant-baseline: alphabetic; }#PgUqiBEOMcUA .fx7 {dominant-baseline: alphabetic}#PgUqiBEOMcUA .fc1 { fill: rgb(51, 51, 51); }#PgUqiBEOMcUA .fc1 {fill: rgb(51, 51, 51)}#PgUqiBEOMcUA .fx8 { font: 700 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#PgUqiBEOMcUA .fx8 {font-style: normal}#PgUqiBEOMcUA .fb1 { fill: var(--N900-FG, 0.15); }#PgUqiBEOMcUA .fb1 {fill: rgba(31,35,41, 0.15)}#PgUqiBEOMcUA .fb2 { fill: rgb(225, 228, 232); }#PgUqiBEOMcUA .fb2 {fill: rgb(225, 228, 232)}#PgUqiBEOMcUA .fa4 { fill: var(--bg-body); }#PgUqiBEOMcUA .fa4 {fill: #fff}ABC123456挑战原始模型的问题7B模型FP16需要14GB大模型推理延迟高需要昂贵的GPU服务器高精度计算能耗大模型传输和加载慢量化的解决方案INT4量化后仅需约4GB量化后计算量减少,速度提升可在消费级硬件上运行低精度计算更节能模型体积小,加载快显存占用推理速度部署成本能耗带宽
量化的权衡
量化本质上是精度与效率的权衡。降低精度会带来一定的精度损失,但通过合理的量化策略,可以将这种损失控制在可接受范围内。
代码块
Plain Text
┌─────────────────────────────────────────────────────┐
│ 量化精度与效率权衡 │
├─────────────────────────────────────────────────────┤
│ 精度类型 │ 比特位 │ 模型大小 │ 推理速度 │ 精度损失 │
├─────────────────────────────────────────────────────┤
│ FP32 │ 32 │ 100% │ 基准 │ 无 │
│ FP16 │ 16 │ 50% │ ~2x │ 极小 │
│ BF16 │ 16 │ 50% │ ~2x │ 极小 │
│ INT8 │ 8 │ 25% │ ~3x │ 小 │
│ INT4 │ 4 │ 12.5% │ ~4x │ 中 │
│ INT2 │ 2 │ 6.25% │ ~5x │ 大 │
└─────────────────────────────────────────────────────┘
量化类型详解
浮点精度:FP32、FP16、BF16
FP32(单精度浮点):标准的32位浮点数,提供最高精度,但占用空间最大。
FP16(半精度浮点):16位浮点数,精度略有损失,但模型大小减半,是目前LLM训练和推理的主流格式。
BF16(Brain Float 16):Google提出的16位格式,保留了FP32的指数范围,在深度学习中表现优异。
代码块
Python
import torch
fp32_tensor = torch.randn(1000, 1000, dtype=torch.float32)
fp16_tensor = fp32_tensor.to(torch.float16)
bf16_tensor = fp32_tensor.to(torch.bfloat16)
print(f"FP32 内存: {fp32_tensor.element_size() * fp32_tensor.numel() / 1024:.2f} KB")
print(f"FP16 内存: {fp16_tensor.element_size() * fp16_tensor.numel() / 1024:.2f} KB")
print(f"BF16 内存: {bf16_tensor.element_size() * bf16_tensor.numel() / 1024:.2f} KB")
整数精度:INT8、INT4
INT8量化:将权重映射到-128到127的整数范围,模型大小减少到原来的1/4,是生产环境中最常用的量化精度。
INT4量化:将权重映射到-8到7的整数范围,模型大小减少到原来的1/8,适合显存极度受限的场景。
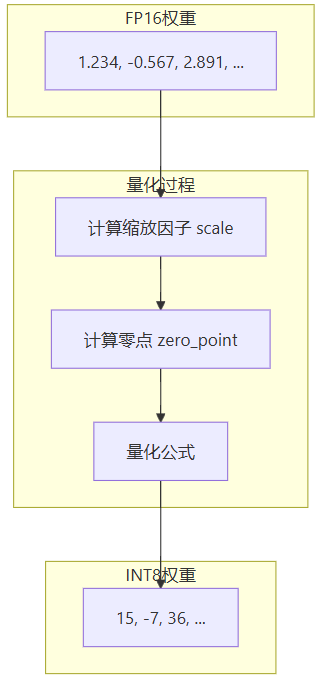
量化公式
对称量化公式:
代码块
Plain Text
q = round(x / scale)
x_dequant = q * scale
非对称量化公式:
代码块
Plain Text
q = round(x / scale) + zero_point
x_dequant = (q - zero_point) * scale
训练后量化 vs 量化感知训练
训练后量化(PTQ)
训练后量化(Post-Training Quantization)是在模型训练完成后直接对权重进行量化,无需重新训练。
优点:
•
简单快速,无需训练
•
不需要原始训练数据
•
适合大多数场景
缺点:
•
低比特量化(如INT4)可能精度损失较大
•
对某些模型结构效果不佳
量化感知训练(QAT)
量化感知训练(Quantization-Aware Training)在训练过程中模拟量化效果,让模型学会适应量化带来的精度损失。
优点:
•
量化后精度损失更小
•
适合低比特量化
缺点:
•
需要重新训练
•
计算成本高
•
需要训练数据
PTQ vs QAT 对比
主流量化方法详解
GPTQ量化
GPTQ(GPT Quantization)是一种基于二阶信息的训练后量化方法,专为大语言模型设计。
核心原理:
•
逐层量化,最小化量化误差
•
使用Hessian矩阵的近似来指导量化
•
支持INT4/INT3/INT2等低比特量化
代码块
Python
from transformers import AutoModelForCausalLM, AutoTokenizer, GPTQConfig
model_id = "meta-llama/Llama-2-7b-hf"
AWQ量化
AWQ(Activation-aware Weight Quantization)是一种激活感知的权重量化方法,通过保护重要权重来减少精度损失。
核心原理:
•
观察激活值分布,识别重要权重
•
对重要权重使用更高精度或特殊处理
•
在精度和效率间取得更好平衡
代码块
Python
from awq import AutoAWQForCausalLM
from transformers import AutoTokenizer
model_path = "meta-llama/Llama-2-7b-hf"
quant_path = "./llama-2-7b-awq"
model = AutoAWQForCausalLM.from_pretrained(model_path)
tokenizer = AutoTokenizer.from_pretrained(model_path)
quant_config = {
GGUF格式
GGUF(GPT-Generated Unified Format)是llama.cpp项目使用的量化格式,专为CPU推理优化。
特点:
•
支持多种量化级别(Q2_K到Q8_0)
•
针对CPU推理高度优化
•
支持内存映射,加载速度快
•
跨平台兼容性好
常见GGUF量化级别:
量化方法对比
llama.cpp量化实战
安装llama.cpp
代码块
Bash
git clone https://github.com/ggerganov/llama.cpp
cd llama.cpp
make -j
make LLAMA_CUBLAS=1 -j
转换和量化模型
代码块
Bash
python convert_hf_to_gguf.py /path/to/llama-2-7b --outfile llama-2-7b-f16.gguf --outtype f16
./llama-quantize llama-2-7b-f16.gguf llama-2-7b-q4_k_m.gguf q4_k_m
使用量化模型推理
代码块
Bash
./llama-cli -m llama-2-7b-q4_k_m.gguf \
-p "What is machine learning?" \
-n 256 \
--temp 0.7 \
--top-p 0.9
Python绑定使用
代码块
Python
from llama_cpp import Llama
llm = Llama(
model_path="./llama-2-7b-q4_k_m.gguf",
n_ctx=2048,
n_threads=8,
n_gpu_layers=35,
)
output = llm(
"Q: What is model quantization?\nA:",
max_tokens=256,
temperature=0.7,
top_p=0.9,
stop=["Q:", "\n\n"],
)
bitsandbytes量化实战
安装bitsandbytes
代码块
Bash
8-bit量化加载
代码块
Python
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
4-bit量化加载(NF4)
代码块
Python
量化模型推理
代码块
Python
量化对模型性能的影响
精度影响评估
代码块
Python
from datasets import load_dataset
from evaluate import load
import numpy as np
def evaluate_quantized_model(model, tokenizer, dataset, num_samples=100):
perplexity_metric = load("perplexity", module_type="metric")
texts = dataset["text"][:num_samples]
results = perplexity_metric.compute(
predictions=texts,
model_id=model,
add_start_token=False,
性能基准测试
量化模型部署
使用vLLM部署量化模型
代码块
Python
from vllm import LLM, SamplingParams
使用Ollama部署GGUF模型
代码块
Bash
ollama create mymodel -f Modelfile
ollama run mymodel "What is model quantization?"
Modelfile示例:
代码块
Plain Text
FROM ./llama-2-7b-q4_k_m.gguf
PARAMETER temperature 0.7
PARAMETER top_p 0.9
PARAMETER num_ctx 2048
SYSTEM You are a helpful AI assistant.
部署架构选择
常见问题
量化会损失多少精度?
精度损失取决于量化方法和比特位。INT8量化通常精度损失极小(<1%),INT4量化精度损失约2-5%。使用GPTQ、AWQ等先进方法可以将INT4的精度损失控制在3%以内。对于大多数应用场景,这种损失是可以接受的。
哪种量化方法最好?
没有绝对最好的方法,取决于你的需求。如果追求推理速度,AWQ是不错的选择;如果追求精度,GPTQ表现更好;如果需要在CPU上运行,GGUF格式是最佳选择。建议根据实际场景进行测试对比。
量化模型可以继续微调吗?
可以,但有限制。使用QLoRA技术可以在量化模型上进行参数高效微调。bitsandbytes的4-bit量化模型配合LoRA是目前最流行的低资源微调方案,可以在单张消费级GPU上微调7B甚至13B模型。
INT4和INT8该选哪个?
如果显存充足,优先选择INT8,精度损失更小。如果显存紧张或需要在消费级GPU上运行,INT4是更好的选择。对于13B以上的模型,INT4几乎是必选项,否则显存需求过高。
量化后推理速度一定会提升吗?
不一定。量化后模型体积变小,内存带宽需求降低,但需要额外的反量化计算。在GPU上,INT8/INT4量化通常能提升速度;在CPU上,GGUF格式的量化模型速度提升更明显。实际效果需要根据硬件和模型进行测试。
如何评估量化模型的质量?
常用评估方法包括:困惑度(Perplexity)测试、下游任务基准测试(如MMLU、HellaSwag)、人工评估输出质量。建议准备一个与实际应用场景相关的测试集,对比量化前后的输出差异。
总结
模型量化是将大语言模型部署到资源受限环境的关键技术。通过本指南,你已经了解了:
量化原理:通过降低数值精度减少模型大小和计算需求
量化类型:FP16、BF16、INT8、INT4各有适用场景
PTQ vs QAT:训练后量化快速便捷,量化感知训练精度更高
主流方法:GPTQ精度好、AWQ速度快、GGUF适合CPU部署
实战代码:llama.cpp和bitsandbytes的完整使用示例
部署方案:根据并发需求和硬件环境选择合适的部署架构
掌握模型量化技术,你就能够在有限的硬件资源上部署强大的AI能力,让大语言模型真正走进千家万户。