LLM大语言模型微调方法对比:全量微调、LoRA与QLoRA
本指南涵盖全量微调与参数高效微调(PEFT)的核心原理,详解LoRA、QLoRA等主流技术,提供完整的Hugging Face实战代码,并帮助你在微调、RAG和提示工程之间做出正确选择。
微调的定义添加图标
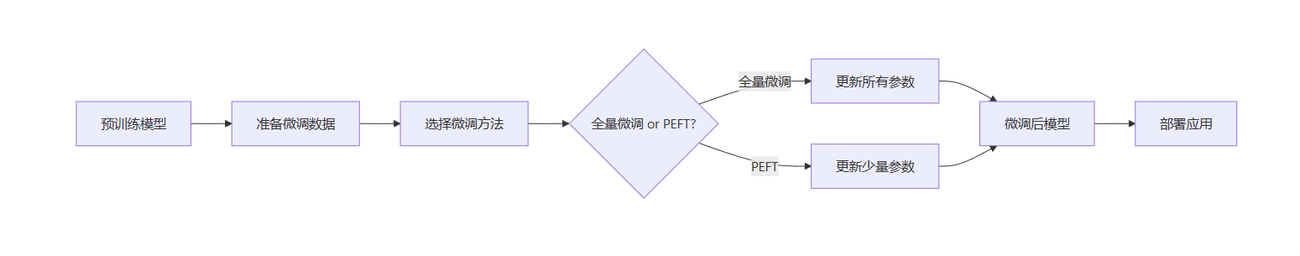
LLM微调是在预训练模型的基础上,使用特定领域或任务的数据继续训练,使模型更好地适应目标场景。这个过程会调整模型的部分或全部参数,让模型"学会"新的知识和能力。
全量微调(Full Fine-tuning)
全量微调更新模型的所有参数,能够最大程度地适配目标任务,但计算资源需求巨大。
优点:
•
适配能力最强、可以学习复杂的新知识
缺点:
•
需要大量GPU显存(7B模型约需60GB+)、训练时间长、容易过拟合、存储成本高(每个任务一个完整模型)
参数高效微调(PEFT)
PEFT只更新模型的一小部分参数,大幅降低计算资源需求,同时保持较好的微调效果。
代码块
Plain Text
┌─────────────────────────────────────────────┐
│ 参数高效微调方法对比 │
├─────────────────────────────────────────────┤
│ 方法 │ 可训练参数 │ 显存需求 │ 效果 │
├─────────────────────────────────────────────┤
│ 全量微调 │ 100% │ 很高 │ 最佳 │
│ LoRA │ 0.1-1% │ 低 │ 优秀 │
│ QLoRA │ 0.1-1% │ 更低 │ 优秀 │
│ Prefix-tuning│ 0.1% │ 低 │ 良好 │
│ Adapter │ 1-5% │ 低 │ 优秀 │
└─────────────────────────────────────────────┘
60%
40%
LoRA技术详解
LoRA原理
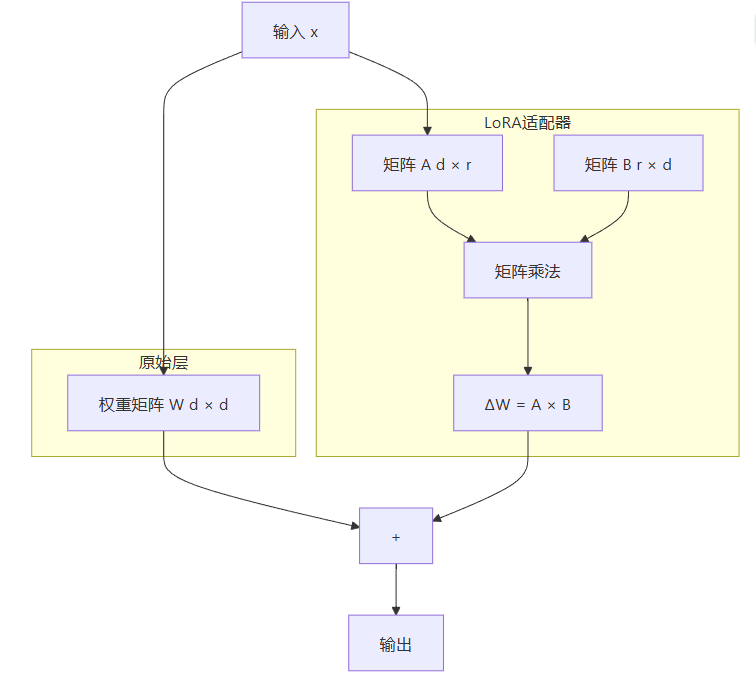
LoRA(Low-Rank Adaptation)的核心思想是:模型微调时的权重变化可以用低秩矩阵来近似表示。
原始权重更新:W' = W + ΔW
LoRA分解:ΔW = A × B,其中A是(d×r)矩阵,B是(r×d)矩阵,r远小于d
LoRA的优势
•
显存效率:只需存储和更新低秩矩阵,显存占用降低90%+
•
训练速度:可训练参数少,训练速度快
•
模块化:不同任务的LoRA适配器可以灵活切换
•
无推理延迟:推理时可将LoRA权重合并到原模型
QLoRA:量化+LoRA
QLoRA在LoRA基础上引入量化技术,进一步降低显存需求:
•
4-bit量化:将模型权重从FP16压缩到4-bit
•
NF4数据类型:专为正态分布权重设计的量化格式
•
双重量化:对量化常数再次量化
•
分页优化器:防止显存溢出
微调数据准备
数据格式
微调数据通常采用指令格式(Instruction Format):
代码块
JSON
{"instruction": "将以下英文翻译成中文","input": "Hello, how are you?","output": "你好,你好吗?"}
或对话格式(Conversation Format):
代码块
JSON
{"conversations": [{"role": "user", "content": "什么是机器学习?"},{"role": "assistant", "content": "机器学习是人工智能的一个分支..."}]}
数据质量要点
#PHWizKrEpUPC text{white-space:pre}.fb0{stroke:var(--N900-FG, 0.15)}.fx0{stroke-miterlimit:10}.fa1{fill:#bbbfc4}.fx1{font:normal 400 12px MonospacedNumber,LarkHackSafariFont,LarkEmojiFont,LarkChineseQuote,-apple-system,BlinkMacSystemFont,Helvetica Neue,Tahoma,PingFang SC,Microsoft Yahei,Arial,Hiragino Sans GB,sans-serif,Apple Color Emoji,Segoe UI Emoji,Segoe UI Symbol,Noto Color Emoji}.fx2{text-anchor:middle}.fx3{dominant-baseline:central}.fx4{stroke:none}.fc0{fill:var(--text-caption)}.fa2{fill:var(--text-link-disabled)}.fa3{fill:rgb(246, 248, 250)}.fx5{font:400 normal 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"}.fx6{text-anchor:start}.fx7{dominant-baseline:alphabetic}.fc1{fill:rgb(51, 51, 51)}.fx8{font:700 normal 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"}.fb1{fill:var(--N900-FG, 0.15)}.fb2{fill:rgb(225, 228, 232)}.fa4{fill:var(--bg-body)}ABC123456维度要求100-10000条高质量标注覆盖各种情况统一格式避免过长过短说明任务简单需求少,复杂任务需求多错误数据会严重影响效果避免模型只学会单一模式保持输入输出格式规范与目标应用场景匹配数量质量多样性格式一致长度适中
数据清洗流程
代码块
Python
import json
import re
def clean_training_data(data_path):
"""清洗微调训练数据"""
cleaned_data = []
with open(data_path, 'r', encoding='utf-8') as f:
raw_data = json.load(f)
Hugging Face微调实战
环境准备
代码块
Bash
pip install transformers datasets peft accelerate bitsandbytes
pip install trl # 用于SFT训练
使用LoRA微调LLaMA
代码块
Python
import torch
from datasets import load_dataset
from transformers import (
AutoModelForCausalLM,
AutoTokenizer,
TrainingArguments,
加载和使用微调模型
代码块
Python
from peft import PeftModel
base_model = AutoModelForCausalLM.from_pretrained(
"meta-llama/Llama-2-7b-hf",
device_map="auto",
torch_dtype=torch.float16,
微调 vs RAG vs 提示工程
选择正确的技术路线是成功的关键:
对比分析
选择建议
选择提示工程:
•
任务简单明确
•
快速验证想法
•
无敏感数据
选择RAG:
•
知识库频繁更新
•
需要引用来源
•
问答类应用
选择微调:
•
需要特定输出风格
•
专业领域深度适配
•
追求最佳性能
•
有足够的训练数据
微调最佳实践
超参数调优
代码块
Python
recommended_params = {
常见问题排查
评估指标
代码块
Python
from evaluate import load
def evaluate_model(model, test_dataset):
"""评估微调模型"""
bleu = load("bleu")
rouge = load("rouge")
predictions = []
references = []
for sample in test_dataset:
pred = generate_response(sample["instruction"])
predictions.append(pred)
references.append(sample["output"])
bleu_score = bleu.compute(predictions=predictions, references=references)
常见问题
微调需要多少数据?
数据量取决于任务复杂度。简单的风格迁移任务可能只需100-500条高质量数据,而复杂的领域知识学习可能需要5000-10000条。关键是数据质量,高质量的小数据集往往优于低质量的大数据集。
LoRA的r值如何选择?
r值决定了低秩矩阵的秩,影响模型的表达能力。一般建议:简单任务r=8,中等任务r=16-32,复杂任务r=64。可以从较小的r开始,根据效果逐步增加。
微调后模型效果变差怎么办?
可能原因包括:数据质量问题、过拟合、学习率不当。建议检查训练数据质量,使用验证集监控训练过程,适当降低学习率或增加正则化。
微调和RAG可以结合使用吗?
完全可以。一种常见模式是:用微调让模型学会特定的输出风格和推理模式,用RAG提供实时更新的知识。这种组合可以兼顾定制化和知识时效性。
如何评估微调效果?
除了自动化指标(BLEU、ROUGE)外,更重要的是人工评估。建议准备一个测试集,从准确性、相关性、流畅性、格式规范等维度进行评分。A/B测试也是验证微调效果的有效方法。
总结
LLM微调是将通用大模型转化为专业AI助手的关键技术。通过本指南,你已经了解了:
微调原理:在预训练基础上继续训练,适配特定任务
PEFT技术:LoRA、QLoRA等方法大幅降低资源需求
数据准备:高质量、格式规范的数据是成功的基础
实战代码:使用Hugging Face生态完成完整微调流程
技术选型:根据场景在微调、RAG、提示工程间做出选择
掌握LLM微调技术,你就能够为企业和产品打造专属的AI能力,在AI应用开发中获得竞争优势。