企业级 LLMOps 架构指南:从模型开发到生产监控的完整链路
核心摘要
🧥
随着生成式 AI 进入应用深水区,如何将原型 demo 转化为稳定、可控、可规模化的企业级应用成为核心挑战。LLMOps(大语言模型运维)应运而生,它不仅仅是模型的部署,更是一套涵盖 Prompt 管理、数据治理、持续评估、安全护栏和生产观测的工程化体系。本文将为你拆解企业级 LLMOps 的核心架构,助你构建稳健的 AI 生产流水线。
核心要点
•
从模型中心到流程中心:LLMOps 的核心在于管理 Prompt、知识库和评估链路的闭环。
•
自动化评估是生命线:通过 LLM-as-a-Judge 解决生成式内容的质量波动问题。
•
全链路观测性:不仅监控延迟和成功率,更要监控检索质量(RAG)和幻觉率。
•
安全与合规护栏:在输入与输出端建立敏感信息过滤与合规性检查机制。
什么是 LLMOps?
LLMOps(Large Language Model Operations)是指在大语言模型应用开发中,为了提高迭代效率、保障生产稳定性而建立的一系列实践、技术和文化。
如果说 MLOps = Data + Model + Code,那么 LLMOps = Prompt + RAG + Evaluation + Guardrails。
LLMOps vs. MLOps
#LveXKyraZQKX text { white-space: pre; }#LveXKyraZQKX .fb0 { stroke: var(--N900-FG, 0.15); }#LveXKyraZQKX .fb0 {stroke: rgba(31,35,41, 0.15)}#LveXKyraZQKX .fx0 { stroke-miterlimit: 10; }#LveXKyraZQKX .fx0 {stroke-miterlimit: 10}#LveXKyraZQKX .fa1 { fill: rgb(187, 191, 196); }#LveXKyraZQKX .fa1 {fill: rgb(187, 191, 196)}#LveXKyraZQKX .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#LveXKyraZQKX .fx1 {font-style: normal}#LveXKyraZQKX .fx2 { text-anchor: middle; }#LveXKyraZQKX .fx2 {text-anchor: middle}#LveXKyraZQKX .fx3 { dominant-baseline: central; }#LveXKyraZQKX .fx3 {dominant-baseline: central}#LveXKyraZQKX .fx4 { stroke: none; }#LveXKyraZQKX .fx4 {stroke: none}#LveXKyraZQKX .fc0 { fill: var(--text-caption); }#LveXKyraZQKX .fc0 {fill: #646a73}#LveXKyraZQKX .fa2 { fill: var(--text-link-disabled); }#LveXKyraZQKX .fa2 {fill: rgb(187, 191, 196)}#LveXKyraZQKX .fa3 { fill: rgb(246, 248, 250); }#LveXKyraZQKX .fa3 {fill: rgb(246, 248, 250)}#LveXKyraZQKX .fx5 { font: 400 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#LveXKyraZQKX .fx5 {font-style: normal}#LveXKyraZQKX .fx6 { text-anchor: start; }#LveXKyraZQKX .fx6 {text-anchor: start}#LveXKyraZQKX .fx7 { dominant-baseline: alphabetic; }#LveXKyraZQKX .fx7 {dominant-baseline: alphabetic}#LveXKyraZQKX .fc1 { fill: rgb(51, 51, 51); }#LveXKyraZQKX .fc1 {fill: rgb(51, 51, 51)}#LveXKyraZQKX .fx8 { font: 700 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#LveXKyraZQKX .fx8 {font-style: normal}#LveXKyraZQKX .fb1 { fill: var(--N900-FG, 0.15); }#LveXKyraZQKX .fb1 {fill: rgba(31,35,41, 0.15)}#LveXKyraZQKX .fb2 { fill: rgb(225, 228, 232); }#LveXKyraZQKX .fb2 {fill: rgb(225, 228, 232)}#LveXKyraZQKX .fa4 { fill: var(--bg-body); }#LveXKyraZQKX .fa4 {fill: #fff}ABC12345维度传统 MLOps结构化数据、模型权重准确率、召回率 (确定性)重新训练模型容器化、高性能推理现代 LLMOpsPrompt、知识库 (Vector DB)、Agent 工具语义相似度、LLM 打分 (概率性)调整 Prompt、优化检索、微调 (PEFT)缓存、安全防护、多模型路由核心资产评估方式反馈循环部署重点
LLMOps 全生命周期架构
一个成熟的企业级 LLMOps 架构通常由开发、实验、集成和生产四个阶段组成。
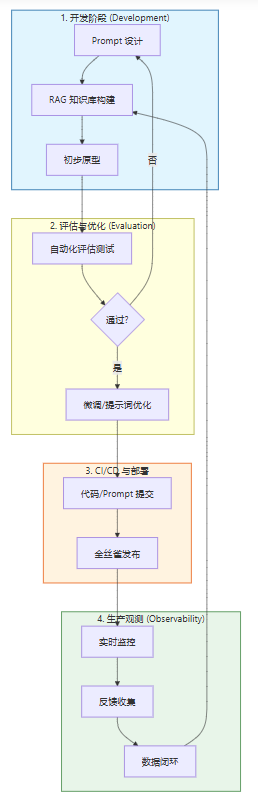
企业级架构核心组件
Prompt 管理系统 (Prompt Registry)
Prompt 已经成为企业的一等公民资产。一个好的 Prompt Registry 应该支持:
•
版本控制:像管理代码一样管理 Prompt。
•
AB 测试:在不同版本的 Prompt 之间切换流量。
•
变量解耦:将业务逻辑与具体的 Prompt 模板分离。
检索增强 (RAG) 运维
RAG 是目前企业落地最广泛的模式。LLMOps 需要管理:
•
数据清洗与切片:如何保证语义块的完整性。
•
向量数据库性能:索引更新频率、多模态支持。
•
检索质量评估:点击率、准确率以及上下文相关性。
模型评估中心 (Evaluation Center)
评估是 LLMOps 中最难的一环。目前主流方案包括:
•
确定性测试:正则匹配、JSON 格式检查。
•
语义相似度:BERTScore、Cosine Similarity。
•
LLM-as-a-Judge:使用更强的模型(如 GPT-4o)作为评委,对输出结果进行多维度打分。
实战:构建自动化评估流水线
在企业级流水线中,我们通常会在代码提交时自动触发评估。以下是一个基于 Python 的简化评估逻辑示例。
代码块
Python
# evaluation_pipeline.pyimport openai
from datasets import load_dataset
def llm_judge(prompt, response, ground_truth):
"""
使用 LLM 作为评委,对输出质量进行打分
"""
judge_prompt = f"""
请作为一名公正的评委,评估 AI 对以下问题的回答质量。
问题: {prompt}
回答: {response}
参考答案: {ground_truth}
请从 准确性、流畅性、相关性 三个维度给出 1-10 分的评分,并简述理由。
格式要求:评分: [分数], 理由: [理由]
"""
completion = openai.chat.completions.create(
LLMOps 最佳实践
先评估后微调 — 很多时候优化 Prompt 或改进 RAG 检索质量比盲目微调模型更有效。
建立语义缓存 — 对于重复性高的查询,使用语义缓存(Semantic Cache)可以节省 80% 以上的成本和延迟。
输出格式强约束 — 在生产环境,尽量要求模型返回 JSON 格式,并配合代码层面的 Schema 验证。
实施安全护栏 — 在用户输入端增加敏感词过滤(Pii Detection),在输出端增加合规性检查,防止模型“越狱”或产生有害内容。
重视反馈闭环 — 收集用户的“赞”和“踩”,这些数据是下一轮优化 RAG 或微调模型最宝贵的资源。
⚠️ 常见错误:
•
忽略推理延迟 → 在生产环境,过长的推理时间会导致用户流失。应考虑模型压缩或流式输出。
•
没有版本回滚机制 → Prompt 的细微修改可能导致下游业务逻辑崩溃,必须具备秒级回滚能力。
常见问题 (FAQ)
Q1: 我们的企业规模较小,有必要上完整的 LLMOps 吗?
如果你的应用只是简单的问答,初期可以从简单的 Prompt 管理和手动评估开始。但一旦涉及多模型切换、复杂的 RAG 链路或对输出质量有严格要求时,引入自动化的 LLMOps 流程将大幅降低长期维护成本。
Q2: 如何处理大模型的幻觉问题?
幻觉无法完全消除,但可以通过 LLMOps 流程来缓解:
•
RAG:提供外部事实依据。
•
Self-Correction:让模型自我检查。
•
Confidence Score:当模型置信度低时,返回默认回复或人工介入。
Q3: 向量数据库的选择对 LLMOps 影响大吗?
非常大。向量数据库的选型不仅要考虑搜索精度,更要考虑其在 LLMOps 流程中的易用性,如是否支持实时索引更新、元数据过滤以及与现有监控系统的集成。
总结
LLMOps 不仅仅是技术的堆砌,更是一种面向未来的生产方式。通过建立管理、评估、发布、观测的闭环,企业能够将不确定的生成式 AI 转化为确定的业务价值。