LLM大语言模型微调实战:LoRA微调
本指南深入解析LoRA的数学原理,详解rank、alpha、target_modules等关键参数,涵盖QLoRA量化优化、PEFT库实战代码,以及模型合并部署的完整流程。
什么是LoRA
LoRA(Low-Rank Adaptation)是一种革命性的参数高效微调技术,通过低秩矩阵分解将可训练参数减少99%,显存需求降低90%以上。
LoRA的核心思想
LoRA(Low-Rank Adaptation,低秩适应)的核心假设是:预训练模型在适应下游任务时,权重的变化量具有较低的"内在秩"(intrinsic rank)。这意味着我们不需要更新完整的权重矩阵,而是可以用低秩矩阵来近似这种变化。
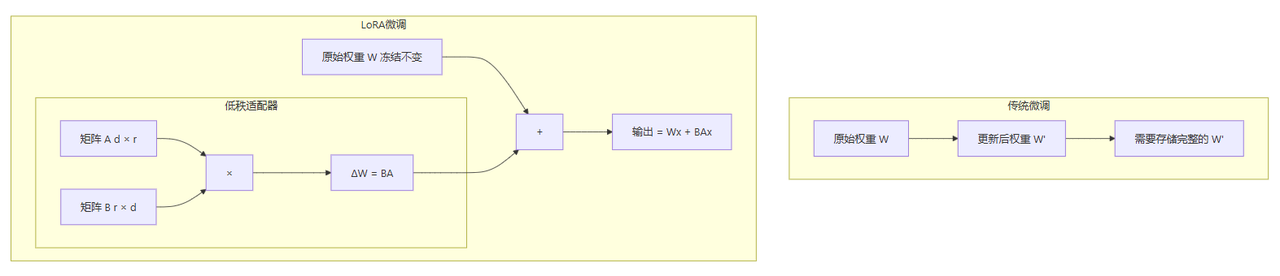
低秩分解的数学原理
假设原始权重矩阵 W 的维度为 d × d,传统微调会直接更新 W 得到 W':
W' = W + ΔW
LoRA的关键创新在于将权重变化 ΔW 分解为两个低秩矩阵的乘积:
ΔW = B × A
其中:
•
A 是 r × d 的矩阵(降维投影)
•
B 是 d × r 的矩阵(升维投影)
•
r 是秩(rank),远小于 d(通常 r = 4~64,而 d = 4096)
这样,可训练参数从 d² 降低到 2 × d × r,参数量减少了 d/(2r) 倍。
为什么低秩假设成立
研究表明,预训练模型已经学习了丰富的通用知识,微调只是在这个基础上做"微调整"。这种调整往往集中在某些特定的方向上,而不是在整个参数空间中均匀分布。
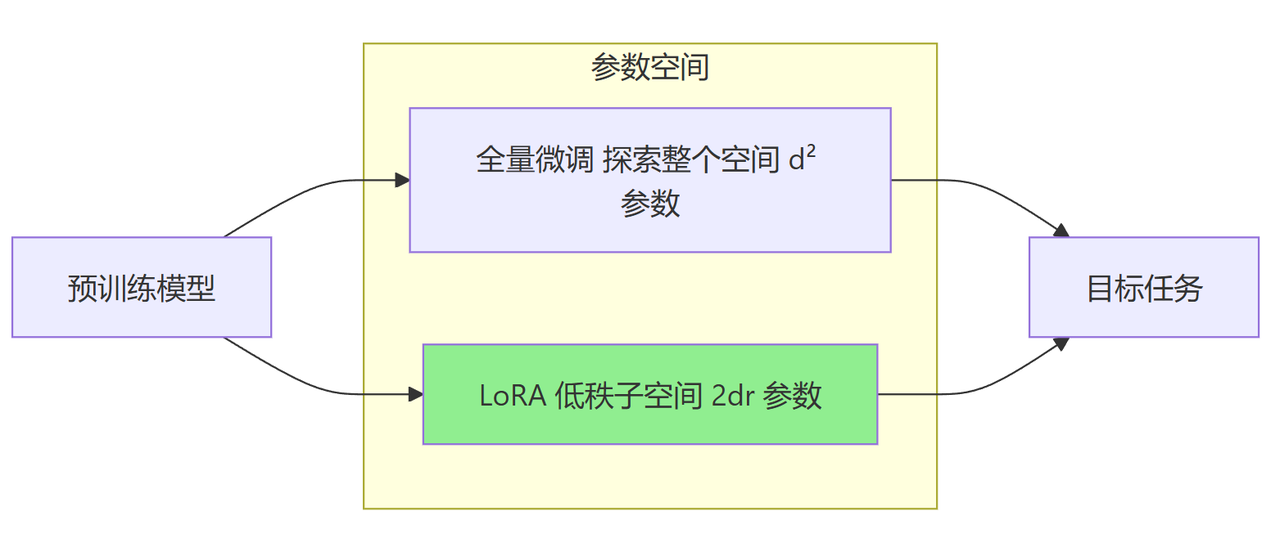
LoRA vs 全量微调
详细对比
#EKdtwypPZvve text { white-space: pre; }#EKdtwypPZvve .fb0 { stroke: var(--N900-FG, 0.15); }#EKdtwypPZvve .fb0 {stroke: rgba(31,35,41, 0.15)}#EKdtwypPZvve .fx0 { stroke-miterlimit: 10; }#EKdtwypPZvve .fx0 {stroke-miterlimit: 10}#EKdtwypPZvve .fa1 { fill: rgb(187, 191, 196); }#EKdtwypPZvve .fa1 {fill: rgb(187, 191, 196)}#EKdtwypPZvve .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#EKdtwypPZvve .fx1 {font-style: normal}#EKdtwypPZvve .fx2 { text-anchor: middle; }#EKdtwypPZvve .fx2 {text-anchor: middle}#EKdtwypPZvve .fx3 { dominant-baseline: central; }#EKdtwypPZvve .fx3 {dominant-baseline: central}#EKdtwypPZvve .fx4 { stroke: none; }#EKdtwypPZvve .fx4 {stroke: none}#EKdtwypPZvve .fc0 { fill: var(--text-caption); }#EKdtwypPZvve .fc0 {fill: #646a73}#EKdtwypPZvve .fa2 { fill: var(--text-link-disabled); }#EKdtwypPZvve .fa2 {fill: rgb(187, 191, 196)}#EKdtwypPZvve .fa3 { fill: rgb(246, 248, 250); }#EKdtwypPZvve .fa3 {fill: rgb(246, 248, 250)}#EKdtwypPZvve .fx5 { font: 400 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#EKdtwypPZvve .fx5 {font-style: normal}#EKdtwypPZvve .fx6 { text-anchor: start; }#EKdtwypPZvve .fx6 {text-anchor: start}#EKdtwypPZvve .fx7 { dominant-baseline: alphabetic; }#EKdtwypPZvve .fx7 {dominant-baseline: alphabetic}#EKdtwypPZvve .fc1 { fill: rgb(51, 51, 51); }#EKdtwypPZvve .fc1 {fill: rgb(51, 51, 51)}#EKdtwypPZvve .fx8 { font: 700 16px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#EKdtwypPZvve .fx8 {font-style: normal}#EKdtwypPZvve .fb1 { fill: var(--N900-FG, 0.15); }#EKdtwypPZvve .fb1 {fill: rgba(31,35,41, 0.15)}#EKdtwypPZvve .fb2 { fill: rgb(225, 228, 232); }#EKdtwypPZvve .fb2 {fill: rgb(225, 228, 232)}#EKdtwypPZvve .fa4 { fill: var(--bg-body); }#EKdtwypPZvve .fa4 {fill: #fff}ABC12345678维度全量微调100%(数十亿)~60GB慢每任务一个完整模型风险较高需要加载不同模型最高LoRA微调0.1-1%(数百万)~16GB快3-5倍每任务仅需几MB适配器风险较低热切换适配器接近全量微调可训练参数显存需求(7B)训练速度存储成本灾难性遗忘多任务切换效果上限
LoRA的独特优势
模块化设计:LoRA适配器独立于原模型存储,可以像"插件"一样灵活切换:
代码块
Python
from peft import PeftModel
base_model = load_base_model()
model_task_a = PeftModel.from_pretrained(base_model, "lora-adapter-task-a")
model_task_b = PeftModel.from_pretrained(base_model, "lora-adapter-task-b")
无推理延迟:训练完成后,可以将LoRA权重合并到原模型中,推理时无额外计算开销。
LoRA关键参数详解
rank(秩)
rank是LoRA最核心的超参数,决定了低秩矩阵的秩,直接影响模型的表达能力和参数量。
代码块
Plain Text
┌─────────────────────────────────────────────────┐
│ rank 参数选择指南 │
├─────────────────────────────────────────────────┤
│ rank值 │ 参数量 │ 适用场景 │
├─────────────────────────────────────────────────┤
│ 4 │ 最少 │ 简单任务、快速实验 │
│ 8 │ 少 │ 一般任务、资源受限 │
│ 16 │ 中等 │ 推荐默认值、平衡选择 │
│ 32 │ 多 │ 复杂任务、追求效果 │
│ 64 │ 较多 │ 高复杂度、接近全量微调 │
│ 128+ │ 很多 │ 特殊需求、充足资源 │
└─────────────────────────────────────────────────┘
选择建议:
•
从 r=16 开始实验
•
如果效果不佳,尝试增加到 32 或 64
•
如果资源紧张,可以降到 8
•
rank 过大会增加过拟合风险
alpha(缩放因子)
alpha用于控制LoRA更新的缩放比例,实际应用中的缩放公式为:
代码块
Plain Text
ΔW = (alpha / rank) × B × A
常用配置:
•
alpha = rank:缩放因子为1,最常用
•
alpha = 2 × rank:放大更新幅度,学习更激进
•
alpha = rank / 2:缩小更新幅度,学习更保守
代码块
Python
lora_config = LoraConfig(
target_modules(目标模块)
target_modules指定对哪些层应用LoRA。不同模型架构的命名不同:
LLaMA/Qwen系列:
代码块
Python
target_modules = ["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"]
GPT系列:
代码块
Python
target_modules = ["c_attn", "c_proj", "c_fc"]
选择策略:
表格加载中...
dropout
LoRA的dropout应用在低秩矩阵上,用于防止过拟合:
代码块
Python
lora_config = LoraConfig(
建议:
•
数据量充足:dropout=0 或 0.05
•
数据量较少:dropout=0.1
•
数据量很少:dropout=0.1-0.2
QLoRA:量化+LoRA
QLoRA原理
QLoRA(Quantized LoRA)在LoRA基础上引入量化技术,将基础模型量化到4-bit,进一步降低显存需求。
QLoRA的关键技术
NF4量化:专为正态分布权重设计的4-bit数据类型,比传统INT4精度更高。
双重量化:对量化常数再次量化,进一步节省显存。
分页优化器:使用CPU内存作为GPU显存的扩展,防止OOM。
显存对比
PEFT库实战
环境准备
代码块
Bash
pip install torch transformers datasets peft accelerate bitsandbytes
pip install trl
完整LoRA微调代码
代码块
Python
import torch
from datasets import load_dataset
from transformers import (
AutoModelForCausalLM,
AutoTokenizer,
TrainingArguments,
BitsAndBytesConfig,
)
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training
from trl import SFTTrainer
model_name = "Qwen/Qwen2-7B"
bnb_config = BitsAndBytesConfig(
load_in_4bit=True,
bnb_4bit_quant_type="nf4",
查看可训练参数
代码块
Python
model.print_trainable_parameters()
LoRA模型合并与部署
合并LoRA权重
训练完成后,可以将LoRA适配器合并到基础模型中:
代码块
Python
from peft import PeftModel
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
base_model = AutoModelForCausalLM.from_pretrained(
"Qwen/Qwen2-7B",
torch_dtype=torch.float16,
device_map="auto",
trust_remote_code=True,
)
model = PeftModel.from_pretrained(base_model, "./qwen-lora-adapter")
merged_model = model.merge_and_unload()
merged_model.save_pretrained("./qwen-merged")
tokenizer = AutoTokenizer.from_pretrained("./qwen-lora-adapter")
tokenizer.save_pretrained("./qwen-merged")
推理使用
代码块
Python
动态加载适配器
如果不合并,可以动态加载不同任务的适配器:
代码块
Python
常见问题
LoRA的rank值如何选择?
rank值决定了低秩矩阵的表达能力。一般建议从r=16开始实验。如果任务简单(如风格迁移),r=8可能就足够;如果任务复杂(如专业领域知识学习),可能需要r=32或更高。关键是在效果和效率之间找到平衡点。
alpha和rank应该如何配合?
最常用的配置是alpha = 2 × rank,这样缩放因子为2,能够让LoRA更新有足够的影响力。也可以设置alpha = rank(缩放因子为1)作为保守选择。不建议alpha远小于rank,这会导致LoRA更新被过度压制。
应该对哪些层应用LoRA?
对于Transformer模型,至少应该对注意力层的q_proj和v_proj应用LoRA。推荐配置是对所有注意力投影(q、k、v、o)都应用。如果资源允许,还可以扩展到FFN层的gate_proj、up_proj、down_proj。
QLoRA和LoRA如何选择?
如果显存充足(如A100 80GB),使用FP16的LoRA可以获得最佳效果。如果显存有限(如RTX 3090 24GB),QLoRA是更好的选择,它能在消费级显卡上微调7B甚至13B模型,效果损失很小。
LoRA微调后效果不好怎么办?
首先检查数据质量,这是最常见的问题。然后尝试:增加rank值、扩展target_modules、调整学习率、增加训练轮次。如果仍然不理想,可能需要更多高质量训练数据,或者考虑任务本身是否适合用LoRA解决。
如何避免LoRA微调过拟合?
可以采取以下措施:使用适当的dropout(0.05-0.1)、减小rank值、使用早停策略、增加数据多样性、使用较小的学习率。监控验证集loss是发现过拟合的最有效方法。
总结
LoRA作为参数高效微调的代表性技术,通过低秩分解的数学技巧,实现了微调效率的革命性提升。通过本指南,你已经掌握了:
核心原理:低秩假设和矩阵分解的数学基础
关键参数:rank、alpha、target_modules的配置策略
QLoRA优化:量化技术进一步降低资源门槛
实战代码:使用PEFT库完成完整微调流程
部署方案:模型合并和动态适配器加载
掌握LoRA技术,你就能够在有限的硬件资源下,高效地定制专属AI模型,为各种应用场景提供强大的智能能力。