实战一:Claude+Obsidian 搭建自己的AI知识库
把我自己从零搭这套系统的全过程拆成一步一步,每一步具体到打开哪个软件、点哪个按钮、复制哪段话给Claude。你跟着走,不到2小时能跑通一个最小闭环。
一、动手之前,先想清楚工具各自在干什么
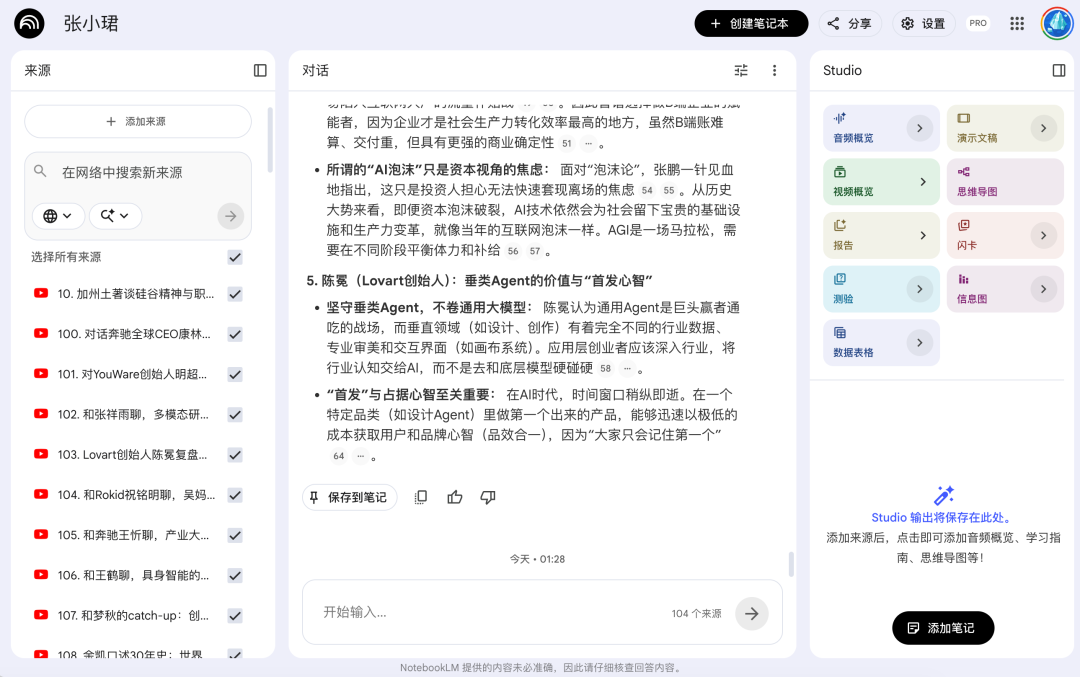
NotebookLM= 矿场
你可以把它理解成一个专门干粗加工的地方。你从YouTube看到一个好视频、从公众号读到一篇好文章、从Twitter刷到一段好观点,都先往这里扔。它的任务是帮你做第一轮提炼,把原始内容变成摘要和关键主题。
注意,它是矿场,不是仓库。挖出来的矿要运走,不是堆在矿场里。
Obsidian = 仓库
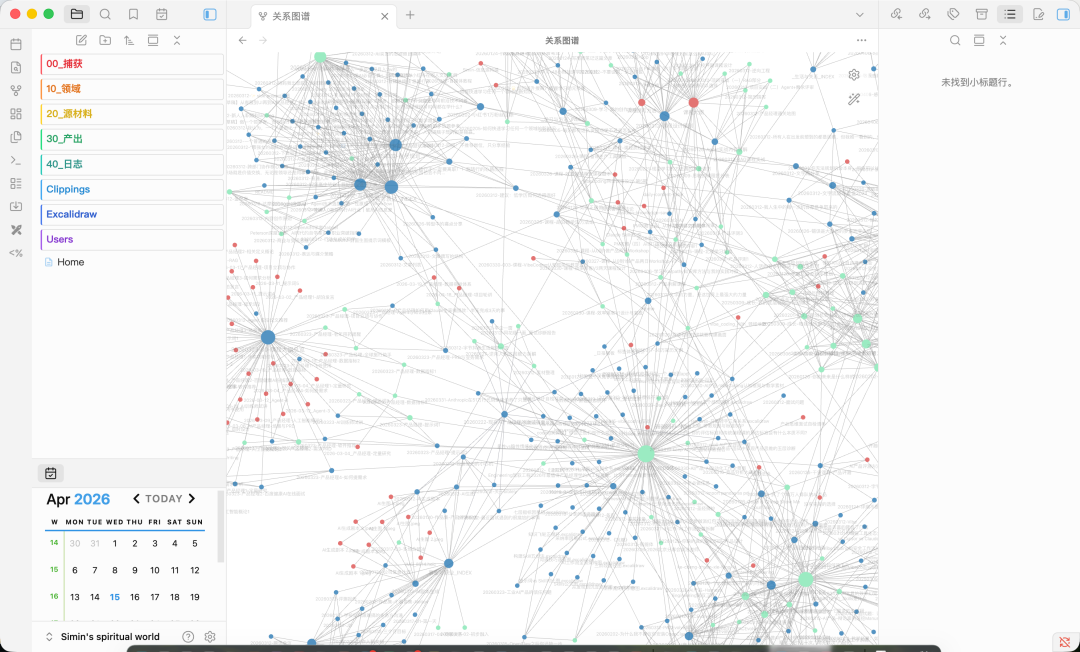
这是你自己的知识仓库,所有结构化的笔记都存在这里。而且是存在你自己电脑上,不依赖任何云服务,Claude封号、软件倒闭都跟你无关。
仓库分两个区:输入区放你从外面学来的、消化过的知识;输出区放你自己产出的内容,比如文章、PRD、方案。
为什么要分开,后面章节会详细讲
Claude = 搭档
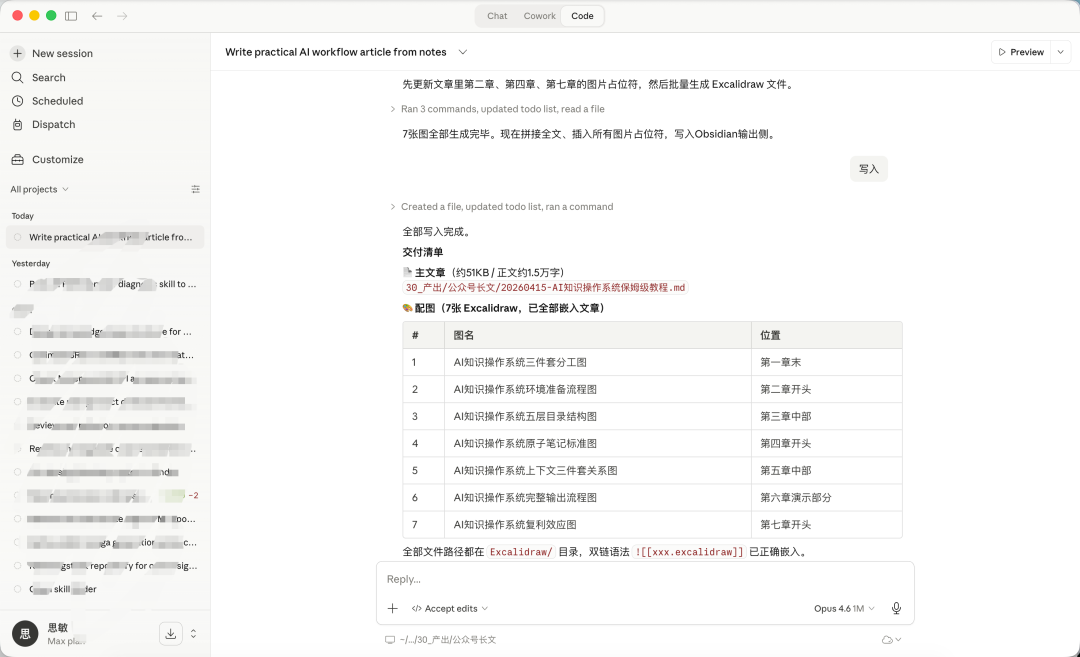
它是那个真正帮你干活的人。读你仓库里的上下文,跟你讨论方向,帮你写初稿,帮你做决策。它不需要每次从零认识你,因为它每次都在读你的仓库。
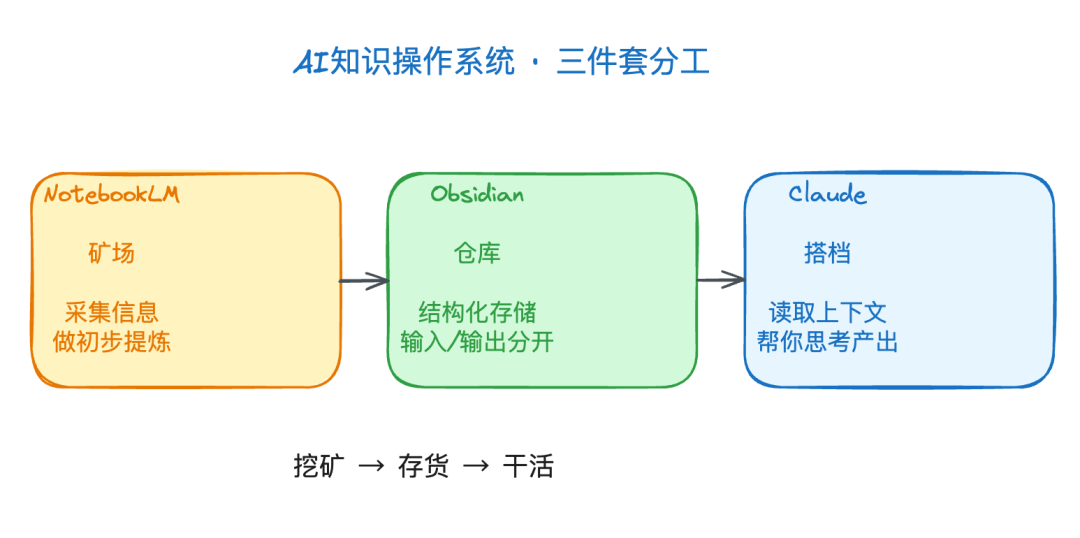
三者的关系可以用一句话说清楚:
矿场挖矿,仓库存货,搭档干活。
为什么非得三个工具?能不能只用Claude?
不能。因为Claude的记忆是当前对话的记忆,窗口一关,上下文就散了。如果你把所有东西都存在Claude对话里,下次新开窗口你又得重新铺一遍。只有Obsidian这种本地化、结构化、可检索的仓库,才能真正沉淀你的知识。
为什么非要NotebookLM?我直接把文章扔给Claude不行吗?
行,但效率不高。NotebookLM有两个优势:一是能直接接收YouTube视频/网页文章,自动转文字+做摘要,这是Claude做不到的;二是它能同时装几十个源,做跨源的综合分析。它是专门干采集和初加工这件事的,术业有专攻。
想清楚了这三个角色,接下来装软件就变得简单,你是在给自己搭一个矿场+仓库+搭档的工作台,不是随便装几个软件。
二、环境准备:半小时装完所有工具
这一章是纯体力活,没什么技术含量,跟着做就行。我把所有步骤拆成了6个小任务,每个任务后面都有一个验证标志,你看到那个标志就说明这一步做对了,可以进下一步。
建议你打开这篇文章的时候,同时打开你的电脑,边看边装。
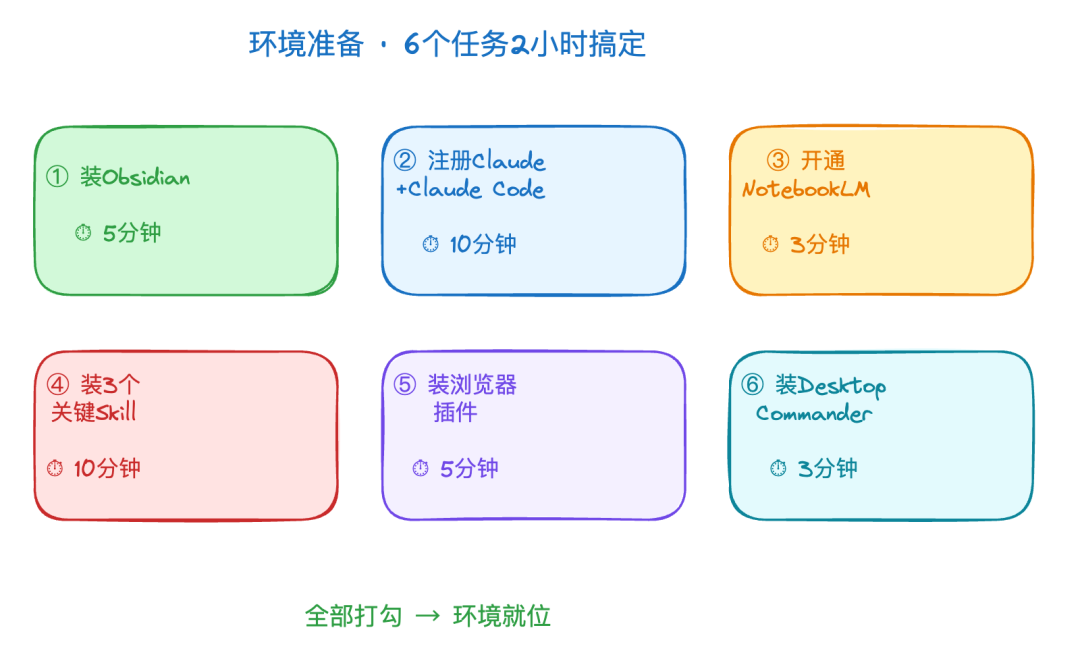
任务一:装Obsidian(5分钟)
Obsidian是那个仓库。
操作步骤:
根据你的系统(Mac / Windows)下载对应的安装包
安装,打开软件
4.第一次打开会让你选择创建一个Vault(仓库)。点 Create new vault
5.给仓库起个名字,比如 我的知识库,选一个你以后能找得到的存储位置(建议不要放在iCloud或OneDrive这种云同步目录下,容易冲突)
6.点 Create 验证标志:你能看到一个空的Obsidian界面,左边是文件列表(现在是空的),右边是编辑区域。
这一步做完先别急着往里面塞东西。目录结构我们下一章统一搭。
任务二:注册Claude并安装Claude Code(10分钟)
Claude是那个搭档。
这里要装两个东西:
第一个:Claude网页版
直接去 https://claude.ai 注册账号。免费版可以起步,但如果你打算认真用,建议升级Pro版,对话次数和记忆功能都强很多。
第二个:Claude Code
Claude Code是Claude的命令行版本。你可以把它理解成一个能直接操作你电脑文件的Claude。网页版的Claude只能聊天,Claude Code能直接读你的Obsidian笔记、帮你建文件夹、改文档。
装法看这个文档就行,一步步跟着走:
https://code.claude.com/docs/en/overview
ClaudeCode & Claude客户端使用文档(可以在官网搜到最新版)
验证标志:
•
你能在网页版 claude.ai 正常对话
•
你能在电脑的终端里输入 claude --version,能看到版本号
如果 claude --version 这一步卡住了,不用紧张。网页版先用起来就行,Claude Code是后面提效用的,不是必需品。
任务三:开通NotebookLM(3分钟)
NotebookLM是那个矿场。
操作步骤:
打开 https://notebooklm.google.com
用Google账号登录(没有Google账号需要先注册一个)
点 New Notebook 创建一个笔记本
随便上传一个文档或粘贴一段文字,确认能正常使用
验证标志:你能创建Notebook,上传文档后能看到NotebookLM自动生成的摘要。
任务四:装三个关键Skill(10分钟)
这一步是把Claude变成懂你仓库的搭档。
什么是Skill?简单说,Skill就是一份预设好的工作指南。Claude默认什么都不懂你的仓库,装了Skill之后,Claude就知道该去哪里读你的笔记、怎么帮你存笔记、用什么格式存。
需要装的三个Skill:
Skill一:连接NotebookLM
作用:让Claude能直接读你NotebookLM里的内容。
把下面这句话复制,粘贴给Claude Code:
作用:让Claude能自动帮你把内容提炼成原子笔记、归类、打标签、建双向链接,然后写进Obsidian。这个是我自己写的,专门为知识沉淀场景做的。
代码块
Plain Text
帮我安装这个skill:https://github.com/chusimin/AIPM-Skills/tree/main/obsidian-knowledge-saver
Skill二:知识沉淀(Obsidian Knowledge Saver)
Skill三:Obsidian操作
作用:让Claude能直接读写你的Obsidian仓库(搜笔记、读笔记、建新笔记、追加内容)。这个是Obsidian创始人亲自写的Skill,直接调用Obsidian的命令行。
代码块
Plain Text
帮我安装这个skill:https://github.com/kepano/obsidian-skills
验证标志:安装完之后问Claude Code一句:
代码块
Plain Text
我的skill有哪些
它会把上面三个Skill都列出来。
任务五:装浏览器插件(5分钟)
这一步是让信息从网页一键进到系统里。不装也能用,但每次复制粘贴会很烦。
插件一:YouTube to NotebookLM
作用:看到好视频,一键扔进NotebookLM。
去Chrome网上应用店搜 YouTube to NotebookLM,点安装。
插件二:Obsidian Web Clipper
作用:看到好文章,一键剪藏成Obsidian笔记。
去Chrome网上应用店搜 Obsidian Web Clipper,点安装。安装后要在插件设置里配置你的Obsidian仓库路径。
安装方式:
1.chrome浏览器右上角有一个插件图标
2.点击管理扩展程序
3.进入应用商店
4.找到要安装的两个插件
验证标志:
•
打开任意一个YouTube视频,能在右上角看到插件图标,点击能送到NotebookLM
•
打开任意一个网页文章,能用Web Clipper保存到Obsidian
任务六:装Desktop Commander(3分钟)
这一步是让Claude chat(不是Claude Code)也能操作你的Obsidian。
如果你已经装好Claude Code,这一步可以先跳过。如果你主要用chat,就需要这个。
装法:在Claude的MCP配置里加入Desktop Commander这个插件。具体配置方法搜一下Desktop Commander官方文档,一步步跟着走。
1.进入插件市场
2.搜索desktop commder,点击加号
3.点击 downlad
验证标志:在Claude对话时,你让它帮你创建一个Obsidian笔记,它真的能建出来。
环境准备checklist
全部做完,对着下面这个清单打勾:
•
Obsidian已安装,能打开空的Vault
•
Claude账号能正常对话
•
Claude Code终端能运行 claude --version
•
NotebookLM能创建Notebook并上传文档
•
三个Skill全部装好(notebooklm / obsidian-knowledge-saver / obsidian-skills)
•
YouTube to NotebookLM 插件已装
•
Obsidian Web Clipper 插件已装
•
(可选)Desktop Commander 已配置
全部打勾,环境就准备好了。
到这一步,你已经把矿场、仓库、搭档三个角色都请到位了,但他们还不认识彼此。下一章我们来设计目录结构,告诉仓库怎么摆货,也告诉搭档去哪里找东西。
三、目录结构:为什么输入和输出必须分开
工具都装好了,接下来要做的事情是在Obsidian里搭一个合理的目录结构。这一步看起来不起眼,但它决定了你的整套系统能不能真正跑起来。
我见过很多人知识库里塞了几百条笔记,但每次想找东西还是在翻文件夹,找不到就干脆重新问Claude一遍。问题不在笔记数量,在目录设计。
目录不是凭感觉建的
大多数人建目录的方式是想到什么建什么。今天学RAG,建一个RAG文件夹;明天要写PRD,建一个PRD文件夹;后天看了篇行业分析,又建一个行业洞察文件夹。
建着建着你会发现两个问题:
一是分类越来越乱。PRD是产品方法论的一部分,还是工作产出的一部分?RAG是技术笔记,还是AI产品笔记?每次都得想一下,久而久之就不想建了。
二是Claude找不到东西。你让Claude帮你写一篇文章,它要去哪里找素材?你让它帮你查一下你之前学过的某个概念,它要去哪里翻?目录一乱,Claude也懵。
所以目录的设计逻辑不能靠感觉,必须有一条主线。
核心原则:输入侧和输出侧分开
这条主线就一句话:
输入和输出分开。输入侧放你学来的知识,输出侧放你产出的成品。
📌
为什么非要这么分?因为这两类内容的用途完全不同:
•
当你让Claude帮你写一篇文章,它需要去输出侧学你的风格(你之前文章怎么写的、用什么结构、什么语气)
•
当你让Claude帮你做一次调研,它需要去输入侧找你积累的素材(你之前学过的概念、读过的文章、记过的观点)
如果你把两种东西混在一起,Claude就要两个地方都翻,而且分不清哪些是你自己写的、哪些是你引用别人的。结果就是它写出来的东西要么没你的风格,要么引用不准确。
分开存,Claude找得更准,你也找得更快。
我推荐的五层结构
光说原则太空,我给你一套可以直接照搬的结构模板。这是我自己用了大半年、也推荐给我课程里学员的结构:
第一层:收件箱(输入侧)
所有原始素材先进这里。网上看到的好文章、听完的一节课、读了一本书、跟Claude聊完的一段有价值对话,全部先丢到收件箱。
这一层的原则是只进不改。保留原始信息,方便以后回溯。不用管结构,不用管标签,就扔进来。
二级分类建议:
•
文章剪藏(用Web Clipper保存的网页文章)
•
课程笔记(听课的原始记录)
•
会议记录(工作会议、面试记录等)
•
读书笔记(读书时的原始摘录)
•
对话记录(和Claude或别人的有价值对话)
第二层:知识卡片(输入侧,核心区)
这是知识库真正的核心。每张卡片只讲一件事,一个概念、一个方法、一个决策、一个经验教训。这些卡片就是原子笔记(下一章会重点讲怎么写)。
这一层的内容主要由Claude帮你从收件箱里提炼出来。你不用手动写,你只需要审核。
二级分类建议(按你的身份和阶段调整):
•
产品方法论
•
AI技术认知
•
行业洞察
•
工具与效率
•
职业发展
•
项目经验
•
思维模型
•
个人成长
第三层:输出文档(输出侧)
你自己产出的成品。文章、PPT、简历、作品集、PRD、方案。
这些和知识卡片的区别是:卡片是给自己看的半成品,输出文档是给别人看的成品。成品是你对外的脸,风格、质量、版本都要可追溯。
二级分类建议:
•
文章与内容(发布的文章、公众号稿件)
•
简历与求职
•
产品文档(PRD、竞品分析、方案)
•
演示材料(PPT、分享稿、课程材料)
第四层:索引(自动维护)
一个 _index.md 文件,自动记录知识库里所有卡片的目录。你不用管它,Claude每次帮你存笔记时会自动更新。
第五层:日志(自动维护)
一个 _log.md 文件,自动记录每次操作——什么时候新增了什么笔记、更新了什么。Claude也会自动维护。
为什么是五层,不是三层或七层
你可能会想:收件箱和知识卡片不都是输入侧吗,合成一层不行吗?
不行。因为它们的加工程度完全不同。收件箱里的东西是生的,是原作者的话;知识卡片是熟的,是你消化过的话。如果你混在一起,三个月后你自己也分不清哪些是你的思考、哪些是别人的原话。
为什么索引和日志要单独算两层?因为它们是系统自动维护的,不是你自己要管的内容。分开是让你看的时候一目了然:哪些我要动,哪些我不用动。
一句话让Claude帮你建好整个结构
说了这么多原则,你不用手动一个个建文件夹。直接把下面这段话复制,发给Claude:
代码块
Plain Text
我想搭建自己的Obsidian个人知识库。
请帮我设计知识体系结构并完成初始化。
## 我的背景- 身份:AI产品经理
Claude会跟你来回对话几轮,确认你的偏好,然后直接在你的Obsidian里建好所有文件夹。你只需要在Obsidian里刷新一下,就能看到整个结构已经就位。
命名建议
文件夹命名中文还是英文?我自己用中文,因为找东西更快、一眼就懂。但如果你有英文习惯(比如在外企工作),英文也行。一致就好,不要混用。
笔记文件名的格式建议:YYYYMMDD-主题.md。比如 20260415-GraphRAG核心原理.md。日期前缀让你一眼能看到时间线。
小白常见问题
Q:我不知道我的二级分类该放什么怎么办?
A:不要纠结,先按推荐结构建出来。空文件夹没关系,等你开始沉淀笔记的时候,自然就会往里面填东西。你会在用的过程中发现某些分类不合适,那时再调整。完成比完美重要。
Q:我之前在Notion/Flomo()/印象笔记里有很多笔记,要不要全搬过来?
A:不要全搬。搬旧笔记是最常见的拖延症。正确的做法是:新的笔记用Obsidian存,旧笔记用到的时候再搬。你一搬就是一周,搬完发现90%的旧笔记你再也用不上。
Q:双向链接、标签这些我看不懂怎么办?
A:现在可以完全不用管。标签和双向链接是进阶功能,等你有50+条笔记之后再开始用。先把笔记存进正确的文件夹就够了。
到这里,你的仓库已经搭好了骨架。但骨架是空的,还需要有东西往里面放。下一章讲最关键的一件事,原子笔记。这是整套系统能不能真正发挥作用的分水岭。做得好,知识库越用越聪明;做不好,知识库就是一堆堆积的垃圾。
四、原子笔记:知识库能不能用起来的胜负手
目录搭好了,接下来要往里面放东西。放什么?怎么放?
这一章是整套系统的分水岭。很多人搭完知识库用了一个月就放弃了,不是因为工具难,而是因为笔记写得不对。写错的笔记越存越多,下次打开还是找不到自己想要的东西,最后干脆不用了。
而写对了笔记的人,知识库会形成一个正反馈:笔记越多→AI找得越准→产出越快→你越愿意存笔记→笔记越多。
这个正反馈的起点,就是原子笔记。
先看一个常见的坏笔记
很多人第一次存笔记是这样的:
标题:Dan Koe 关于个人品牌的观点
内容:Dan Koe 认为,大多数人都是内容消费者,被困在无休止的消费而不创造的循环中。他建议,建立个人品牌的真正途径是学习、构建和教学,将你的学习转化为有形的项目,并公开分享你的见解。关键洞见是,创造能够以被动消费无法实现的方式迫使思维清晰。
这条笔记看起来很完整,其实是一条无效笔记。问题在哪?
问题一:它是别人的话,不是你的话
"内容消费者"、"学习、构建和教学"这些都是Dan Koe的表达方式。你存下来只是搬运,没有消化。三个月后你打开这条笔记,看到的还是Dan Koe,不是你自己的思考。
问题二:它依赖原文上下文
这条笔记里提到的"建议"、"关键洞见",你得记得这是Dan Koe在哪个视频哪段话里说的,才能真的用起来。一旦你忘了原文,这条笔记就成了一堆漂亮的废话。
问题三:它塞了太多东西
这条笔记其实讲了三件事:消费陷阱、学习构建教学方法、创造迫使思维清晰。三个观点混在一条笔记里,以后你想引用其中一个,Claude也不好精准抓取。
这就是大多数人的知识库变成垃圾场的原因。看起来存了很多,其实都是别人的话的搬运,关掉笔记就忘。
原子笔记的三个标准
真正有用的笔记,叫原子笔记。一条原子笔记必须同时满足三个标准:
标准一:去掉原作者的表达风格,只留底层逻辑
原作者用什么金句、用什么比喻、用什么口头禅,都跟你没关系。你要提取的是他为什么这么想,而不是他说了什么。
拿刚才Dan Koe那条笔记举例,去风格化之后应该是这样:
创作倒逼思考清晰度
看出区别了吗?去掉了"内容消费者"、"learn, build, and teach"这些Dan Koe的说法,只留下最核心的那个逻辑:创作倒逼清晰度。以后你自己在别的场景里也能直接用这个逻辑,不需要记得它来自Dan Koe。
标准二:一条笔记只解决一个问题
刚才那个Dan Koe的例子其实讲了三件事。正确的做法是拆成三条笔记:
•
一条讲"消费陷阱"
•
一条讲"创作倒逼清晰度"
•
一条讲"学习-构建-教学的闭环"
每条笔记只解决一个问题,好处是以后引用时Claude能精准抓取你要的那一条,不会把其他两条也拖出来混淆。
标准三:未来的你看到这条笔记,不需要回忆原文上下文就能用
这是最硬的标准。三个月后你打开这条笔记,不需要记得这是谁说的、在哪个视频、哪个场景,你也能看懂、也能直接用。
判断方法很简单:把这条笔记单独拎出来,删掉所有来源信息,你自己还看得懂吗?看得懂就是合格的原子笔记,看不懂就说明你没真正消化,只是搬运。
怎么判断一个观点值不值得存
并不是所有信息都值得存进知识库。宁可少存高质量的,不要多存低质量的。
判断标准一句话:三个月后我还用得上吗?
用得上的就存:
•
你觉得会影响你做决策的方法论
•
你能在工作中直接套用的框架
•
你反复会用到的判断标准
•
让你改变了认知的观点
用不上的就过:
•
一次性的新闻和热点
•
跟你的领域不相关的泛泛之谈
•
没有底层逻辑的金句和鸡汤
•
你认同但永远不会用的道理
存之前问自己这个问题,你的知识库质量会直接拉高一个等级。
手动提炼太慢?用Skill一句话搞定
讲了这么多原子笔记的标准,你可能会想:这要求这么高,我每次都得自己琢磨半天,是不是太累了?
累。所以我自己写了一个Skill专门干这件事,前面第二章环境准备里让你装的 obsidian-knowledge-saver 就是这个Skill。装好之后,不管你扔给Claude什么内容(一篇公众号文章、一段视频字幕、一场和朋友的对话记录),你只要加上一句话:
代码块
Plain Text
帮我分析可以提炼出哪些原子笔记,并且存到我的obsidian中
这个Skill会自动帮你做7件事:
去掉原作者的表达风格,只保留底层思考逻辑
每条笔记只解决一个问题
每条笔记脱离原文上下文也能看懂
用中文输出
格式统一(标题用一句话概括问题,正文3-5句话说清逻辑)
笔记之间自动建立双向链接
保留引用来源
你只需要在它提炼完之后审核一下,觉得OK就确认存入,觉得不对就让它重写。整个过程从你看完一篇文章到存下3-5条原子笔记,不超过5分钟。
一个真实的案例:我怎么把这篇文章里的一段存成原子笔记
我用这篇文章刚才讲的"三个月后我还用得上吗"这段内容示范一下。
原始内容(我文章里刚写的那段):
🤔
并不是所有信息都值得存进知识库。宁可少存高质量的,不要多存低质量的。判断标准一句话:三个月后我还用得上吗?用得上的就存:你觉得会影响你做决策的方法论、你能在工作中直接套用的框架、你反复会用到的判断标准、让你改变了认知的观点。用不上的就过:一次性的新闻和热点、跟你的领域不相关的泛泛之谈、没有底层逻辑的金句和鸡汤、你认同但永远不会用的道理。
让Skill提炼之后存成的原子笔记:
代码块
Plain Text
## 用"三个月有效期"判断一条信息该不该存知识库的质量比数量重要。
判断一条信息要不要存的方法是:想象三个月后的自己,还会用到这条信息吗?
用得上的特征:能影响决策的方法论、能直接套用的框架、反复使用的判断标准、让你改变认知的观点。
用不上的特征:一次性的热点、无关领域的泛泛之谈、没有底层逻辑的金句、你认同但不会用的道理。
相关笔记:[[原子笔记的三个标准]]、[[知识库和收藏夹的区别]]
对比一下,你会发现几件事:
•
标题是一句话,点明这条笔记解决什么问题
•
正文3-4句话,不依赖原文
•
自动建了双向链接到其他相关笔记
•
保留了来源但不依赖来源
这就是一条合格的原子笔记。
标签怎么打
原子笔记存完之后,还有一个小动作:打标签。
标签的作用是让你以后搜得到这条笔记。建议:
•
每条笔记打1-3个标签,不要贪多
•
标签用中文,简洁明了
•
可以用 / 建层级,比如 #AI产品/Agent架构
•
不用追求完美的标签体系,先用起来,用着用着自然会发现该怎么调整
Skill提炼笔记时会自动帮你打标签,你审核一下就行。
🌌
到这一步,你的知识库已经开始真正活起来了。有骨架(目录),也有血肉(原子笔记)。接下来要解决一个问题:怎么让Claude变成越用越懂你的搭档,而不是每次都要重新认识你?
下一章讲上下文工程。
五、让Claude成为你的默认工作入口
仓库搭好了,笔记也会写了,系统已经能用了。但到这一步,你的知识库跟Claude还是两个分开的东西。你需要主动去Obsidian找笔记,再复制给Claude。
想让这套系统真正发挥威力,需要做一件事:把Claude变成你的默认工作入口。
什么意思?
所有事都过Claude这件事
大多数人用Claude的方式是需要的时候才打开。想写文章了,打开一下;查个问题,打开一下;不用就关掉。
我现在的用法完全不是这样。我几乎所有工作场景都先过Claude:
•
写文章找它
•
做产品决策找它
•
学新东西找它
•
理清思路找它
•
写邮件、列提纲、复盘、甚至做旅行计划都找它
为什么所有事都要过Claude?三个原因:
原因一:Claude会越来越懂你
Claude有Memory功能,会记住你聊天过程中提到的长期信息。你的职业、你的项目、你的写作风格、你的偏好。你跟它聊得越多,它越准。
如果你只在需要的时候才打开,它记不住你。如果你日常所有工作都过它,两三周后你会发现它的回答开始越来越像你会说的话。
原因二:你的思考过程变成了可沉淀的素材
自己闷头想一个问题,想完就散了,什么也没留下。跟Claude讨论同一个问题,讨论的过程和结论都可以一句话存进Obsidian。你的思考从一次性变成了可复用。
原因三:快
跟Claude聊完直接沉淀,比你自己闷头想再手动记笔记,效率高一个量级。
上下文工程三件套
让Claude越来越懂你,靠的不是每次对话时临时塞背景,而是靠三层持久化的上下文。我把它叫上下文工程三件套:
•
Claude Memory:Claude内部的长期记忆
•
Claude Project:特定项目的共享上下文
•
Obsidian沉淀:跨工具的本地持久化
三层的关系是由浅到深、由窄到宽。Memory管你这个人整体是谁,Project管某个具体项目,Obsidian管跨项目跨工具的所有积累。
下面一个个讲。
第一件套:Claude Memory(长期记忆)
Memory是Claude官方内置的功能。你在对话中提到的长期信息,Claude会自动记住,下次开新对话时自动调用。
怎么用:
打开Claude网页版,点右上角的头像 → Settings → Personalization → Memory。你会看到一个输入框,可以直接写你希望Claude长期记住的事情。
要写什么:
不用写太多,建议就三类信息:
你是谁:职业、当前阶段、主要在做什么
你的偏好:写作风格、语言偏好、沟通习惯
你不喜欢什么:让你反感的表达方式、你不想看到的建议类型
举个例子,我的Memory里有这么几条:
我是AI产品经理,在做AI PM课程和内容创作。
我写文章喜欢口语化、实战派,不喜欢AI腔。禁止使用破折号和大量引号。
我沟通偏好是先告诉我方向,等我确认再执行,不要一次性做完一整件事。
就这么简单。每次新开对话,Claude会自动带上这些信息,不需要你重新解释一遍。
一个小技巧:你也可以在对话过程中直接让Claude记住某件事。比如你刚跟它讨论完一个方案,觉得里面某个判断标准以后还会用到,就说一句:
记住这个判断标准,以后做类似决策时自动应用。
Claude会自动把这条写进你的Memory。
第二件套:Claude Project(项目空间)
Memory管的是你这个人整体,但你手头可能同时在做好几件事,每件事都有自己的背景资料。这时候Project就派上用场了。
Project是Claude里的一个概念,你可以理解成为某个项目专门开的一个房间。房间里你可以上传相关资料,房间里的所有对话都能自动访问这些资料。
怎么用:
在claude.ai左侧栏点 Projects
创建一个新Project,比如"Q2竞品分析"、"新产品PRD"、"AI PM课程第三期"
在Project里上传相关背景资料(可以是PDF、文档、你从Obsidian导出的笔记)
在这个Project里的所有对话,都能访问这些资料
什么时候用Project:
•
一个项目会持续好几周,你不希望每次对话都重新铺背景
•
项目有一批核心资料(产品文档、用户调研、竞品信息),你希望Claude始终参考
•
你想让同一个项目的讨论在一个空间里闭环,不要散落在不同对话里
什么时候不用Project:
•
一次性的问题,用完就散
•
跟你当前所有工作都相关的底层偏好(这种放Memory)
第三件套:Obsidian沉淀(本地持久化)
Memory和Project都在Claude里面。但你需要意识到一件事:Claude是一个平台,它可能会封号,可能会改规则,可能哪天就不能用了。
Obsidian是你自己的。跨项目、跨工具、永久保留。
所以最底层的沉淀,一定要放在Obsidian里。关键产出一定要存回Obsidian,而不是留在Claude对话里:
•
做了一个关键决策 → 存一条笔记
•
产出了一个有价值的框架 → 存一条笔记
•
讨论改变了你的认知 → 存一条笔记
•
这次对话里Claude给的某个建议你觉得特别好 → 存一条笔记
这样做的好处是:即使Claude的对话窗口关了、对话历史丢了、账号被封了,你的上下文还在Obsidian里。随时能喂给新的对话,重新建立上下文。
三件套之间的关系
你可能会问:这三个东西功能有点重叠,我到底该怎么分配?
一张表说清楚:
💪
实际使用的时候不用刻意去想"这个该放哪"。你先形成一个默认习惯:
•
短信息顺手告诉Claude让它记→Memory
•
项目资料打包上传→Project
•
有价值的结论沉淀下来→Obsidian
一段时间之后,你会自然知道什么东西该放哪。
一个常见的认知误区:窗口关了怎么办
很多人刚用Claude的时候有个焦虑:这个对话窗口会不会丢?我花了一小时讨论出来的结论,关了就没了吗?
这个焦虑本身是对的。对话窗口确实不稳定,可能某天真的就打不开了。但解决方法不是不要关窗口,而是让你的上下文不在窗口里。
具体做法:
跟Claude讨论完一个有价值的问题,立刻花30秒存一条笔记到Obsidian
笔记内容是结论+关键论据,不是完整对话
下次想接着讨论,新开一个窗口,把这条笔记贴进去,Claude瞬间恢复上下文
一句话:窗口会断,笔记不会断。你的上下文在Obsidian里,不在Claude里。
这也是为什么第三章我强调要把输出侧做好,你产出的每一条结论都是你下一次对话的起点。
到这里你已经掌握了这套系统的三分之二:仓库搭好了(第三章),原子笔记会写了(第四章),Claude变成默认入口了(第五章)。
🔔
最后一个问题:具体要产出一样东西的时候,应该怎么跟Claude协作?是直接扔一句话让它写,还是有更高效的方式?下一章讲拆角色协作,以及用这套系统完整写一篇文章的五步流程。
六、拆角色协作:跑通一次完整的输出
到这一步,准备工作都做完了。现在要解决最后一个问题:具体产出一样东西的时候,怎么跟Claude配合最高效?
大多数人用Claude产出内容的方式都是一气呵成,打开一个对话窗口,先铺背景、再讨论方向、然后让它写初稿、再反复修改。一通操作下来,窗口里堆了几十条消息,Claude写出来的东西越来越跑题,最后你自己都不知道它在参考什么。
问题不在Claude笨,在你的工作方式。
一个窗口只干一件事
跟Claude协作有一条铁律:
一个窗口只干一件事。需求和执行必须分开。
什么是需求,什么是执行?
需求窗口:用来讨论方向、策略、选择。充满试探、否定、修改。目标是搞清楚要做什么。
我想写一篇关于XX的文章,你觉得从哪个角度切入?
这三个选题哪个更有价值?
帮我分析一下这个方向的可行性。
执行窗口:用来让Claude基于已经确认好的方向产出成品。目标是把确认好的事情做出来。
基于这个选题和这些素材,帮我写初稿。
按照这个框架,帮我生成竞品分析报告。
用这个结构,帮我写一份PPT逐页文案。
为什么必须分开?
因为需求窗口里充满了噪音。你在讨论方向的时候会说"我不想这么写"、"这个角度不对"、"再换一个思路试试"。这些话是思考过程,不是最终结论。
如果你在同一个窗口里直接让Claude写初稿,它会把这些讨论过程也当成指令的一部分,产出的内容会混入你否定过的、修改过的、试探过的各种版本。信号和噪音混在一起,初稿质量就下降了。
📌
分开窗口的好处是:执行窗口拿到的是你确认过的、干净的上下文。它只知道你最终要的是什么,不知道你中间试错过什么。产出质量会好很多。
需求窗口和执行窗口的桥梁:一条Obsidian笔记
问题来了:你在需求窗口讨论了半天,最终得出了一个方向。怎么把这个方向干净地交给执行窗口?
直接复制所有对话过去不行,那就把噪音也带过去了。只复制结论也不行,结论可能只是一句话,信息量不够。
正确的做法是:把讨论结果沉淀成一条Obsidian笔记,这条笔记就是两个窗口之间的桥梁。
笔记只写三件事:
选定的方向是什么
核心论点/关键要点
目标产出的要求(字数、风格、结构)
2-3句话写清楚就够了。不要把讨论过程也写进去。
然后开一个新窗口,把这条笔记贴进去作为上下文,让Claude执行产出。
完整演示:我怎么用这套系统写这篇文章
光说不练还是抽象。我直接用你现在正在读的这篇文章做演示,把整个流程一步一步还原给你看。
Step 1:从Obsidian输入侧找素材
写这篇文章之前,我的输入侧已经有一些相关的原子笔记:
•
关于"知识库不是收藏夹"的笔记
•
关于"Obsidian输入输出侧分开"的原则笔记
•
关于"Claude上下文工程三件套"的笔记
•
关于"拆需求窗口和执行窗口"的笔记
•
还有上一篇文章的成稿(在输出侧)
我打开Obsidian,按标签 #AI产品/工作流 搜了一下,找到这些相关笔记。复制到剪贴板。
Step 2:开需求窗口,定选题方向
我新开一个Claude对话窗口,输入:
代码块
Plain Text
以下是我知识库里关于AI工作流主题的几条原子笔记,以及上一篇爆款文章《AI工作流完整拆解》的成稿。
我想基于这些积累写一篇新文章,和上一篇形成"道"+"术"的配套。
你觉得从哪个角度切入比较好?
给我3个选题方向,每个方向说明切入角度、目标读者、和上一篇的关系。
[粘贴原子笔记和上一篇文章]
Claude给了三个候选方向:
•
方向A:完整的保姆级教程(手把手搭系统)
•
方向B:聚焦在Skill开发(怎么封装自己的方法论)
•
方向C:真实案例集合(看别人怎么搭的)
我选了方向A。
Step 3:把方向存进Obsidian
这一步最关键,很多人会跳过。我在Obsidian输出侧新建一条笔记:
文件名:20260415-保姆级教程选题方向.md
方向:完整的保姆级教程,和上一篇形成"道+术"配套
目标读者:看过上一篇、认同思路但还没动手的AI产品经理
核心观点:搭这套系统只要2小时,关键是输入输出分开+原子笔记+拆角色协作
锚定场景:用我自己的经历,从环境准备到跑通最小闭环
字数:不限制,把事情讲清楚就行
风格:口语化、实战派,保留排除法+类比降维的DNA
2-3句话说清楚。这条笔记就是桥梁。
Step 4:开执行窗口,出初稿
我新开另一个对话窗口(注意,是新窗口,不是原来那个),调用我的文章共创Skill,输入:
代码块
Plain Text
然后Skill就开始工作了。你从第一条消息到现在看到的所有内容,都是这个流程跑出来的。我给你大纲、你审、逐章节写、每章停下来让你审、你说OK继续、我继续。
Step 5:审稿、调整、存回Obsidian输出侧
这篇文章写完之后,我会把成稿存到:
/Users/mac/Desktop/Simin's spiritual world/30_产出/20260415-AI知识操作系统保姆级教程.md
这条文件会变成输出侧的新成员。下一次我写类似主题的文章时,Claude会自动参考它的风格和结构。
一个闭环就这样跑完了:输入侧素材 → 需求窗口 → 桥梁笔记 → 执行窗口 → 输出侧成稿。
其他场景:同样的流程能用在哪
上面演示了写文章。但这个流程不只能写文章。几乎所有内容产出的场景,流程都是一样的:
写项目文档(PRD、方案)
代码块
Plain Text
输入侧准备:
→ 把项目相关的调研资料、竞品信息、需求记录
存进 输入/[项目名]/
文件夹输出流程:
→ 需求窗口:讨论文档的框架和重点
→ 桥梁笔记:把框架存进Obsidian
→ 执行窗口:基于框架+素材生成文档
→ 成稿存到 输出/产品文档/
准备面试
代码块
Plain Text
输入侧准备:
→ 目标公司的调研信息存进 输入/面试/[公司名]/
→ 常见面试问题和你的回答框架存进
写一份PPT
代码块
Plain Text
输入侧准备:
→ 内容素材、核心观点、案例故事存进 输入/
→ 公司VI或模板规范存进
输入/品牌规范/输出流程:
→ 需求窗口:确定PPT的主线和节奏
→ 桥梁笔记:写下每页大致讲什么
→ 执行窗口:基于桥梁笔记生成逐页文案
→ 成稿存到 输出/演示材料/
逻辑完全一样:输入侧素材 → 需求窗口 → 桥梁笔记 → 执行窗口 → 输出侧成稿。
你会发现一个有意思的现象:当你把这个流程跑熟之后,你的产出质量不再取决于Claude有多强,而是取决于你的输入侧有多丰富。原子笔记越多,桥梁笔记写得越准,产出质量就越高。
这就是知识库作为地基的真正价值。
一个关键提醒:不要偷懒跳过桥梁笔记
新手最容易偷懒的地方,就是跳过桥梁笔记那一步。觉得反正我脑子里都记着,直接复制两个窗口的对话不就行了。
不行。原因我前面讲了:直接复制会带噪音。而且还有一个更隐蔽的问题:你脑子里记的东西也会变。今天你觉得方向是A,明天拿去执行的时候可能脑子里已经歪到A'了,你自己都没意识到。
📌
桥梁笔记的作用是把方向固定下来。写在Obsidian里,2-3句话,清清楚楚。执行窗口拿到的是这个固定版本,不是你脑子里的浮动版本。
30秒写一条桥梁笔记,省下来的是你后续改稿的半小时。这笔账很划算。
到这里,整套系统的运行方式你都看完了。剩下一个问题:这套系统跑起来之后,到底能带来什么?下一章讲复利效应,用我自己的真实数据告诉你,坚持几个月之后这套系统会变成什么样。
七、系统跑通之后:你会得到什么
到这里,所有操作步骤都讲完了。我知道你现在可能还在想一个问题:这一切值得吗?花2小时搭系统、以后每天要做原子笔记、要拆窗口、要走5步流程,真的比我直接跟Claude聊天效率高吗?
短期看,未必。如果你只是写一份周报、问一个技术概念,直接打开Claude一句话搞定,比走完整个流程快多了。
但这套系统真正的价值,不在单次效率,在复利效应。
复利是什么意思
简单说就是:你今天的每一次产出,都在给你明天的产出铺路。
我用自己的真实数据给你看:
数据一:写文章的时间
半年前我写一篇干货长文,从选题到定稿大概要10-15小时。反复查资料、反复改框架、跟Claude来回聊上百条消息。
现在写同样长度的文章,大概3-4小时搞定。不是因为我变聪明了,而是因为输入侧已经有几十条原子笔记、输出侧有十几篇成稿。Claude写初稿时能直接参考我之前的结构、口吻、案例库,不需要从零开始。
这篇文章本身就是一个证据。从开工到现在,你看到的完整成稿,总共花了不到3小时,其中一大半时间还是在等你看完、回复OK。
数据二:做一个Skill的时间
半年前我想让Claude按我的方式做产品拆解,每次都要花2小时铺上下文,告诉它我的拆解框架、我关注哪些维度、我习惯的输出格式。下次开新窗口,再来一遍。
现在我做一个新Skill20分钟搞定。因为我的方法论已经在Obsidian里沉淀得很清楚,我只需要让Claude读我已有的笔记,它就能帮我生成Skill文件。
同样的事情,效率差了6倍。差别不在Claude,在我的系统。
数据三:学一个新领域的起点
研究Graph RAG。打开Claude,它不是从"我是AI PM,帮我学Graph RAG"开始,它是从我之前已经学过传统RAG、知识图谱、工厂根因分析项目这个位置开始教我。
因为我的知识库里已经有这些基础,Claude能看到。它不用重复讲我已经懂的部分,直接从我的认知边界往外推。我学新东西的起点不是零,是我上次学到的地方。
三个复利场景
具体来说,系统跑通之后你会在三个场景里感受到复利:
场景一:写第二篇类似文章时
第一篇文章是从0写的。第二篇Claude会直接参考第一篇的结构、口吻、案例库,从半成品开始改,不是从零写。到第五篇、第十篇的时候,你的风格DNA已经固化,Claude能100%模仿你。
场景二:每一次学习都在垫高你的起点
每学一个新概念,就是在输入侧多一条原子笔记。这些笔记之间通过双向链接形成网络。当你学下一个概念时,Claude会自动把它链接到你已有的知识上,让新知识嵌入你的认知网络,而不是漂在外面。
学得越多,下一次学得越快。这就是认知复利。
场景三:每一次求职/项目经验都在帮下一次
每次面试完,你把复盘写成笔记存进去。下次准备面试时,Claude会告诉你:上次你在XX问题上答得不好,这次我们专门练一下。你的面试经验不再是散落的记忆,是可检索、可复用的资产。
做项目也一样。每个项目的踩坑记录、成功经验、关键决策都沉淀成笔记。做下一个项目时,Claude能提醒你这种情况你三个月前踩过坑,当时是这么解决的。
不要用单次效率衡量这套系统
很多人放弃这套系统的原因是:用了两周没看到明显的效率提升,觉得不值。
这是用错了衡量标准。
这套系统不是一个省时工具,是一个认知资产。前两个月你感觉不到太大差别,因为积累还不够厚。但如果你坚持3-6个月,你会突然发现:
•
你的产出速度是同事的3-5倍
•
你写的东西越来越像你自己,而不是AI腔
•
你学新东西的速度明显变快
•
你开始能看到别人看不到的关联
这些都是复利的表现。你不是在使用一套工具,你是在积累一笔资产。
结尾:今天就跑通最小闭环
文章看到这里,你可能已经有点信息过载了。别急。我不是让你今天把所有事都做完,我是让你今天就动手做第一步。
本周行动清单
这是我建议的节奏,按这个走就行:
今天(30分钟)
•
装好Obsidian,建第一个Vault
•
注册Claude,设置好Memory(就写3条:你的职业、写作偏好、沟通习惯)
明天(30分钟)
•
装好三个Skill(notebooklm、obsidian-knowledge-saver、obsidian-skills)
•
装好YouTube插件和Web Clipper
•
让Claude帮你按五层结构建好目录
后天(1小时)
•
用NotebookLM+Claude提炼你人生中第一条原子笔记,存进Obsidian
•
感受一次"从信息源到原子笔记"的完整流程
本周末(2小时)
•
走一次完整的输出流程:选一个小话题,从输入侧找素材 → 需求窗口定方向 → 写桥梁笔记 → 执行窗口出初稿 → 存回输出侧
•
不用追求成品质量,只求跑通流程
之后每天(10分钟)
•
至少往Obsidian存1条原子笔记
•
所有思考和决策都过Claude
•
关键产出随时沉淀
这个节奏不激进,但足够让你在一周内真的跑通一次。跑通之后你就会有正反馈,正反馈会推着你继续走。
回到开头那个问题
文章开头我说:这篇文章本身就是用这套系统写出来的。
👀
现在你读完了,可以回头看一眼:
•
第四章那个原子笔记的例子,就是从我输入侧的笔记调出来的
•
第六章那个"我怎么写这篇文章"的五步流程,就是我写这篇文章本身的真实过程
•
这篇成稿现在已经躺在我Obsidian的输出侧 30_产出/公众号长文/20260415-AI知识操作系统保姆级教程.md
•
下次我再写类似主题的文章时,Claude会自动参考这一篇的风格
你现在看到的不是一篇教你搭系统的文章,你看到的是一个搭好的系统跑出来的产物。
你要做的,就是今天晚上打开电脑,开始搭你自己的那一套。
两个月后回头看,你会感谢今天动手的自己。