Claude Code 项目的 MEMORY.md 使用指南
CLAUDE.md 文件给 AI 提供上下文,是 Claude Code 开始处理项目时读的第一个文件。而 MEMORY.md 是一个 Markdown 文件,存的是跟项目相关的信息,能让 Claude Code 跑得更顺。
MEMORY.md 的位置
CLAUDE.md 通常放项目根目录,方便 AI 发现。MEMORY.md 不一样,它放在 ~/.claude/projects/
代码块
Markdown
~/.claude/projects/
└── MEMORY.md # 简洁索引,每个 session 都加载
其中
如果想换个位置存储,可以在 settings.json 里用 autoMemoryDirectory 自定义路径:
代码块
JSON
{
"autoMemoryDirectory": "~/my-custom-memory-dir"
}
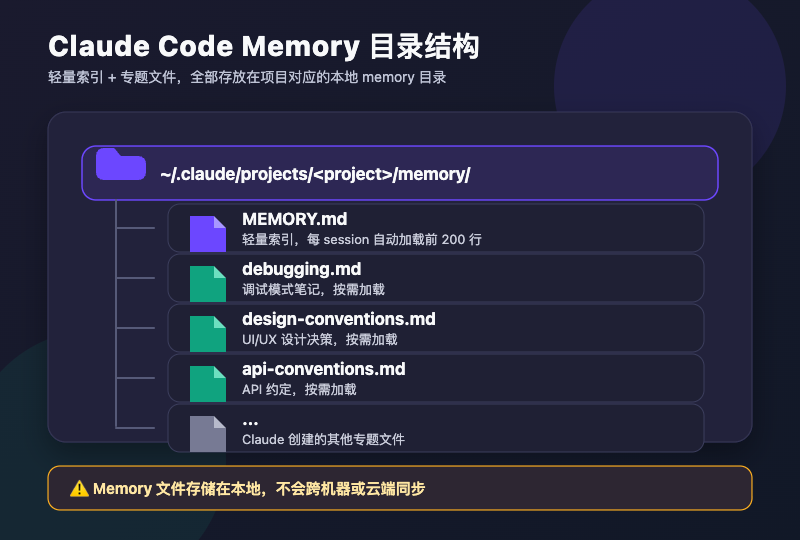
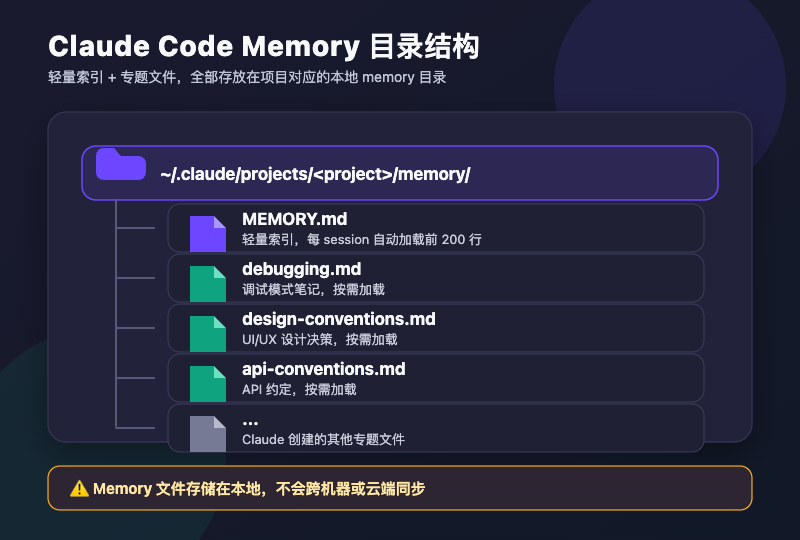
项目变大以后,memory 目录会积累越来越多对 Claude Code 有用的资料,全放一起好管理:
代码块
Markdown
~/.claude/projects/
├── MEMORY.md # 简洁索引,每个 session 自动加载
├── debugging.md # 调试模式笔记
├── design-conventions.md # UI/UX 设计决策
└── ... # Claude 创建的其他专题文件
MEMORY.md 的角色
😀
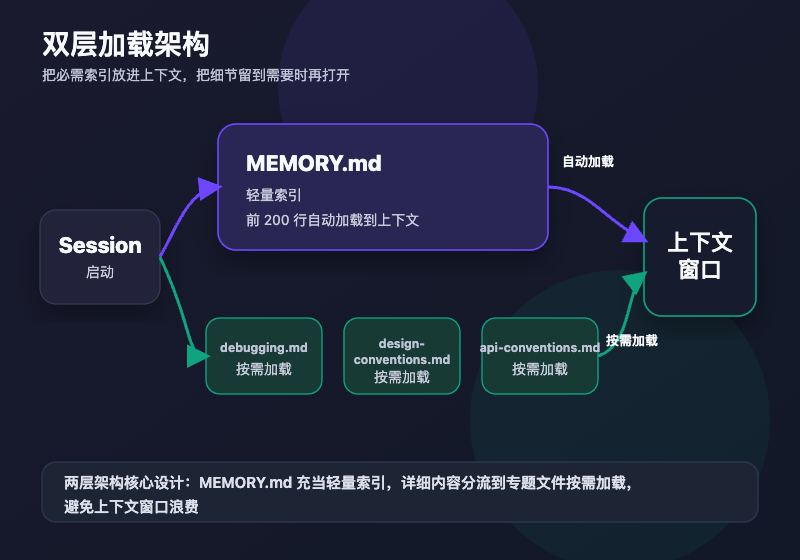
MEMORY.md 是 memory 目录的索引 / 目录。Claude 在整个 session 过程中读写这个目录里的文件,靠 MEMORY.md 追踪每样东西存在哪。
加载机制
✍️
每次对话开始,MEMORY.md 的前 200 行(或前 25KB,哪个先到算哪个) 会被自动加载到上下文。超过这个阈值的内容不会被加载。
此限制仅适用于 MEMORY.md。专题文件(如 debugging.md、api-conventions.md 等)不会在启动时加载——它们由 Claude 按需读取,仅在需要时才会打开。
这就是两层架构的核心设计:MEMORY.md 充当轻量索引,详细内容分流到专题文件里按需加载,避免了上下文窗口浪费。
谁写 MEMORY.md
在 AI 优先的工作流里,MEMORY.md 主要由 Claude 自己 写。
启用 Auto Memory
Claude Code 的 autoMemoryEnabled 设置控制是否启用自动记忆。默认开启:
代码块
JSON
{
"autoMemoryEnabled": true
}
配置位置可以是:
•
~/.claude/settings.json(全局关闭)
•
.claude/settings.json(单个项目关闭)
也可用环境变量强制控制:
代码块
Bash
export CLAUDE_CODE_DISABLE_AUTO_MEMORY=1 # 强制关闭
export CLAUDE_CODE_DISABLE_AUTO_MEMORY=0 # 强制开启
版本要求
Auto Memory 需要 Claude Code v2.1.59 或更高版本。运行 claude --version 确认你的版本。
已知限制:无法独立关闭 CLAUDE.md 或 MEMORY.md
据社区用户报告,autoMemoryEnabled 开关可能同时影响 CLAUDE.md 的加载和 MEMORY.md 的记忆功能。比如只想禁用 auto memory 但保留 CLAUDE.md,目前没有独立的开关来做到这一点。
什么时候写入?
Claude 不会每个 session 都写。它自己判断信息是否值得记住,判断标准是「这条信息在未来的对话中是否有用」。
写入的常见触发场景:
•
你纠正了 Claude 的某个行为(比如「别用 npm,用 pnpm」)
•
你告诉它一条项目知识(比如「API 测试需要本地 Redis」)
•
Claude 在调试过程中发现了值得记录的模式
•
你主动说「记住这个」
当 Claude 在写入或读取 memory 时,界面会显示 「Writing memory」 或 「Recalled memory」。
手动管理:/memory 命令
在 Claude Code 会话中输入 /memory 可以:
•
查看当前加载的所有 CLAUDE.md、CLAUDE.local.md 和 rules 文件
•
开关 auto memory
•
打开 memory 文件夹浏览所有文件
•
直接编辑 MEMORY.md
所有 memory 文件都是普通 Markdown,随时可以手动编辑或删除。
CLAUDE.md 与 MEMORY.md 与 CLAUDE.local.md
除了 CLAUDE.md 和 MEMORY.md,Claude Code 还有一个常被忽视的文件:CLAUDE.local.md。
三者的关系如下:
CLAUDE.md = 指令手册
CLAUDE.md 告诉 AI 怎么干活:
•
怎么表现
•
遵守什么规则
•
输出什么风格
•
首选什么工具和工作流
CLAUDE.md 示例:
markdown
代码块
Markdown
# Role
You are a senior product engineer working on a SaaS dashboard application.
# Tech Stack
- TypeScript
- Next.js App Router
- Tailwind
- shadcn/ui
# Rules
- Prefer server components unless interactivity is required
- Never introduce new dependencies without approval
CLAUDE.local.md = 你的私人偏好
CLAUDE.local.md 放在项目根目录,跟 CLAUDE.md 并列加载。适合放不想提交到 Git 的个人设置,比如本地沙箱 URL、常用测试数据等。/init 命令选择 personal 选项可以自动创建并写入 .gitignore。
CLAUDE.local.md 和 MEMORY.md 的区别
CLAUDE.local.md 是你写的(跟 CLAUDE.md 一样是指令),MEMORY.md 是Claude 写的(是知识笔记)。别把两者搞混 — 你想给 Claude 下指令,写到 CLAUDE.local.md 里;你想让 Claude 记住某些事,让它自己写到 MEMORY.md。
MEMORY.md = Claude 的笔记本
MEMORY.md 是用来保存知识的文件,Claude 自己写。
它存的是:
•
已经做过的决策
•
重要的历史上下文
•
稳定的项目知识
•
反复出现的经验教训
•
假设和取舍
把它当成项目的长期记忆。
MEMORY.md 示例:
代码块
Markdown
# Product Decisions
一句话总结:
代码块
Markdown
CLAUDE.md = AI 该怎么干活
CLAUDE.local.md = 你私人的额外指令
最佳实践
只存长期知识
MEMORY.md 应该放那些跨很多个 session 仍然有价值的东西。
值得存:
•
核心架构决策
•
反复出现的UX发现
•
集成限制
•
性能发现
不要存:
•
临时待办
•
冲刺任务
•
随机调试日志
•
短期实验
每次往里加东西前问一句:「一个月后这信息还有用吗?」
别放操作指令
别把 MEMORY.md 变成第二个 CLAUDE.md。
想告诉 Claude Code 用什么技术栈,写到 CLAUDE.md 或 CLAUDE.local.md 里:
markdown
代码块
Markdown
Always use TypeScript.
Never edit migrations.
上面这些是 CLAUDE.md 的内容。
MEMORY.md 存知识,不存行为规则。如果某个信息是「Claude 应该遵守的指令」,它不属于 MEMORY.md。
解释为什么,不只做了什么
最有价值的记忆是推理过程。
与其只记结论:
markdown
代码块
Markdown
切换到 Redis。
不如加够上下文让 AI 理解原因:
markdown
代码块
Markdown
切换 Redis 是因为 serverless 内存重置导致 session 不稳定。
推理比实现细节存得更久。
条目简短、能扫读
MEMORY.md 是给 AI agent 处理的,要保持短小精炼。AI agent 擅长处理列表、简洁说明、分类结构,不擅长吃长文和时间线堆砌的日志。
为什么要在意 200 行限制: MEMORY.md 只有前 200 行会被加载。如果你手动往里塞了太多内容,Claude 会自动把详细笔记移到专题文件里,但你自己也应该有这个意识。当条目变多时,主动拆到 debugging.md、architecture.md 等专题文件。
定期清理: 不手动审查的话,记忆质量会慢慢变差。建议每月 review 一次,具体做法:
打开 MEMORY.md,逐条目过一遍
已经解决的问题 → 删掉或加 (已解决) 标记
废弃的架构 → 删掉
重复的发现 → 合并为一条
使用 git log 查看 ~/.claude/projects/
小而高信号的记忆,好过大而嘈杂的。
记录失败和死路
记忆里最有价值的一类信息是死路记录。比如:
markdown
代码块
Markdown
尝试用 WebSocket 推送通知。
放弃,移动端重连稳定性太差。
有了这些信息,就能避免重复踩同一个坑,省下 agent 大量时间。
善用 /memory 命令
不要等 Claude 自动写 — 你可以主动触发。对 Claude 说「记住这个:API 测试需要本地 Redis 实例」,Claude 会把这条信息写入 MEMORY.md。不确定 Claude 记住了什么?跑 /memory 打开文件夹直接看。
实战案例
下面是一个真实场景,展示 MEMORY.md 的价值。
场景:调试一个棘手的构建问题
没有 MEMORY.md 的时候:
你:上次构建失败是因为 sharp 的 native 模块在 ARM Mac 上有兼容性问题,试一下降级版本。Claude:让我查一下……(开始从头排查,尝试各种版本,最终花了 10 分钟找到正确方案)
有 MEMORY.md 的时候:
代码块
Markdown
# Build Issues
- `sharp@0.33.x` 在 Apple Silicon 上构建失败 → 降级到 `0.32.6` 解决
- CI 中 `pnpm install` 超时 → 加了 `--frozen-lockfile --prefer-offline`
- `postinstall` 脚本需要 Node 20+,低于 20 直接跳过
你:构建又失败了。Claude:(读取 MEMORY.md,发现 sharp 兼容性记录)上次 sharp@0.33.x 在 Apple Silicon 上有兼容问题。你的环境是 M 系列芯片,我用 0.32.6 试试?(30 秒解决)
场景:项目迁移后避免回退
代码块
Markdown
markdown
# Technical Decisions
- 2026 年 4 月评估过 Vite vs Turbopack → 选 Vite,因为 Turbopack 当时缺 CSS Module HMR
- 讨论过把 monorepo 拆成 polyrepo → 暂缓,等待 PNPM Workspace Catalogs 稳定
有新成员问「为什么不用 Turbopack?」Claude 能从 MEMORY.md 里翻出当时的决策依据,而不是建议你「再评估一次」。
速查表