Agent Loop中的 Jev:决策层自动化的完整指南
找出您的代理为每一种叉子支付前沿价格的情况,将其移至专门用于决策的模型中,并证明其有效
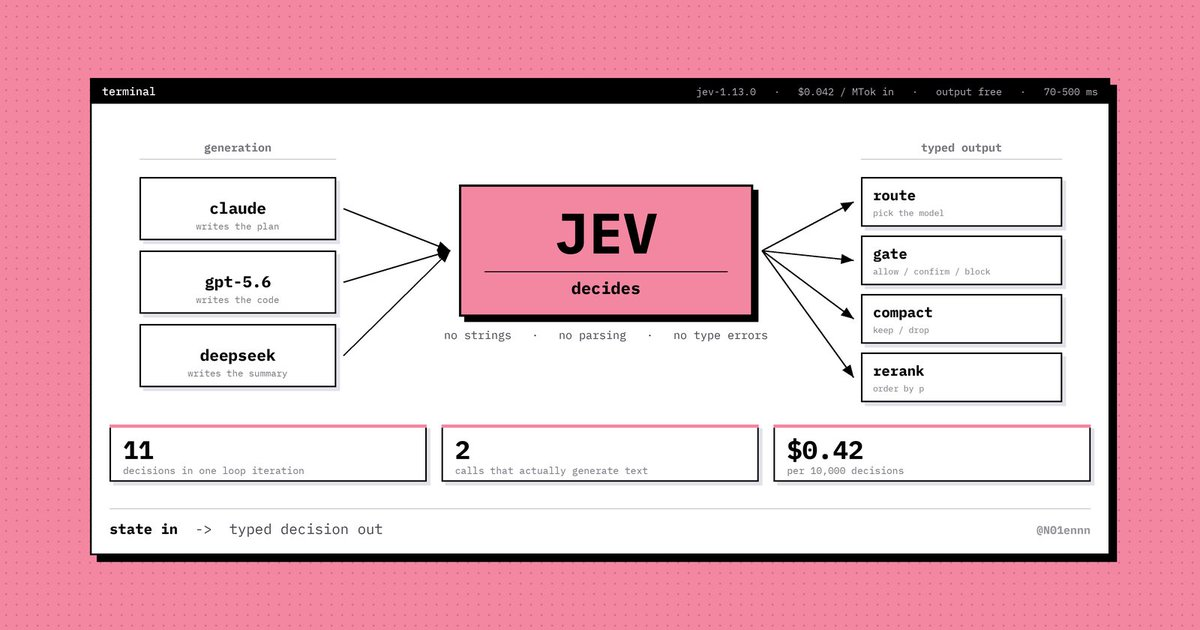
问题的表述一次
您的智能体运行一个循环。由模型决定做什么,工具执行相应操作,再由某一方评估结果,循环持续进行,直到任务完成。
统计该循环一次迭代中未生成任何保留文本的模型调用次数:
•
下一个由哪个工作者或子智能体执行
•
此工具调用是否安全可执行
•
应由哪个模型处理此步骤
•
这个上下文片段是否仍然相关
•
任务是否已完成
•
这需要人类吗
•
智能体是否陷入循环
•
这件物品有多紧急
•
这篇检索到的文档有多相关
其中每一个都会按前沿费率计费,增加几毫秒的延迟,返回一个需要你解析的字符串,甚至可能凭空捏造出一个字段名,让你的流水线在凌晨三点就崩溃。
它们都不需要生成过程。
Jev 是由 TypeSafe AI 构建的 System One 模型,专为这类对话场景而设计。您只需向其提供状态信息和类型化的提问,它便会返回带有校准概率的类型化答案。无需字符串处理,无需解析,从设计上杜绝了类型错误,端到端响应时间仅 70 至 500 毫秒,每百万个输入 token 收费 0.042 美元,且输出免费。
本指南介绍该组件在智能体中的作用、安装方法,以及如何评估其是否确实发挥了作用。
第一部分:智能体循环的结构解析,各分支已标注
以下是一个通用的智能体迭代过程。标有[D]的行表示决策,标有[G]的行表示生成,而标有[C]的行则是普通的代码,本不应涉及模型调用。
代码块
Plain Text
两代人的呼唤。十一条决策。两条硬性规定。
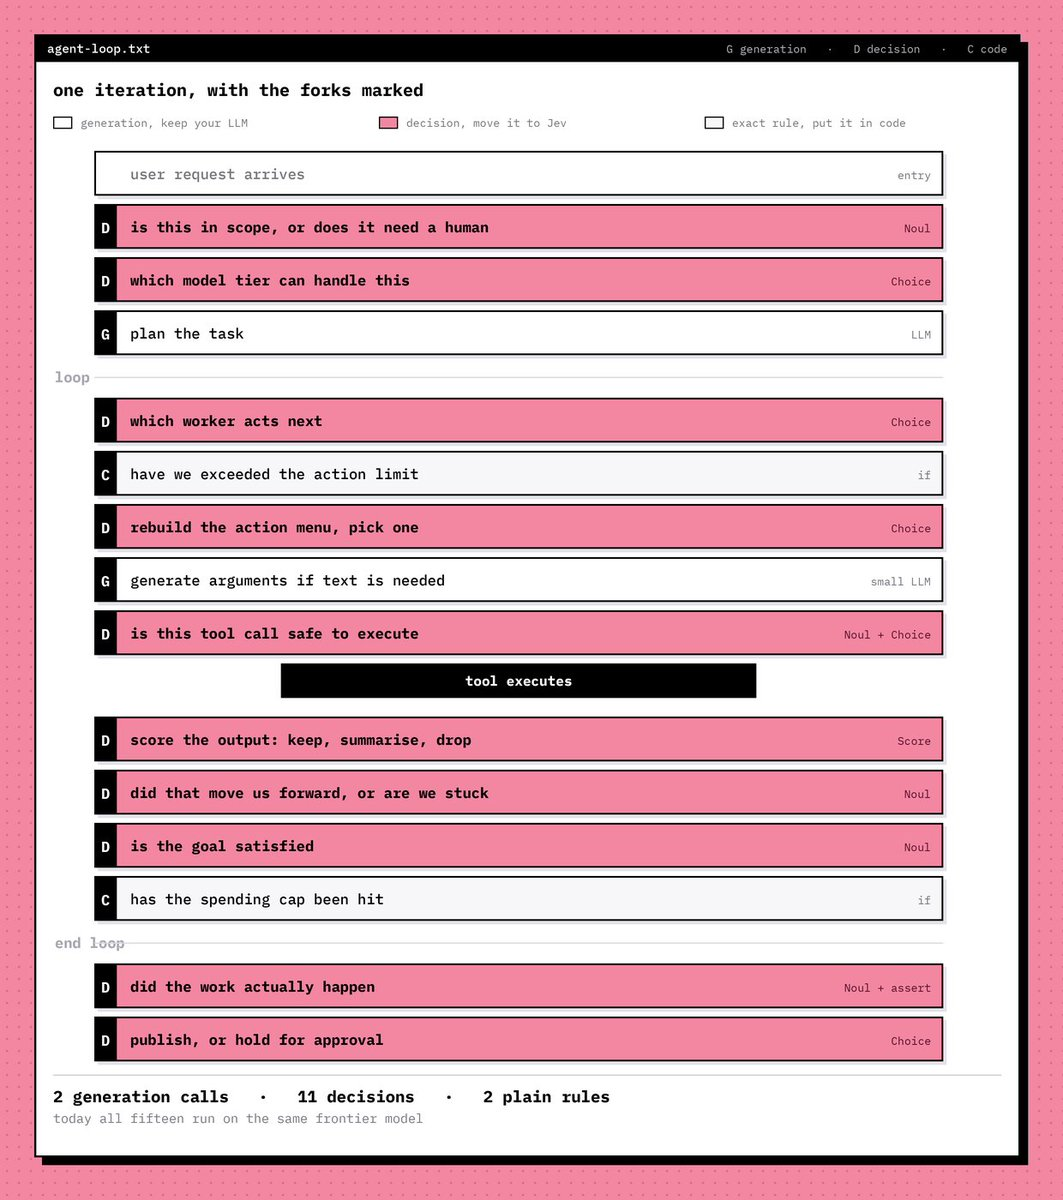
在当今典型的模型栈中,所有十三条模型形状的流水线都运行在同一张前沿模型上。本指南所描述的重组方案表述起来十分简单,但要妥善实施则需要一定时间:
代码块
Plain Text
[G] generation -> your LLM, unchanged
[D] decisions -> Jev
[C] exact rules -> code
请注意,哪些内容保持不变:您的规划模型不变,您的写作模型不变,您的编码模型不变。这并非一次迁移,而是在一个本就不适用于此的模型中进行工作量的削减。
值得强调的是,这更像是一项工程事实而非口号:所有已上线的 Jev 集成在实际应用中,都与他人的模型并行运行。浏览器端的使用将其与一款小型 LLM 配合用于打字;论文分类则将其与 DeepSeek V4 Flash 配合用于摘要生成。欺诈检测将其与Kimi K3搭配,用于应对不确定性较高的尾部场景。LangChain的中间件则将其与GPT-5.6 Luna和Sol搭配。Jev无法生成内容,因此它不可能成为智能体本身,而只能充当智能体中负责决策的部分。
第二部分:作为循环组件的三种原语
每次调用都包含状态以及一个命名问题的映射。单个请求中可以混合使用多种类型。
类型 循环角色 返回值 选项分派、路由、动作选择,最多255个选项,获胜关键、各选项概率、置信度 得分相关性、紧急程度、风险、进展,2至10级评分体系的数值得分、分布、置信度 新值门禁与守卫,一个介于[0, 1]之间的“是/否”陈述的概率
您的代码负责定义各项阈值。Jev 负责报告置信度和确定性。将置信度转化为具体操作属于业务逻辑,而保持这种职责分离,正是确保系统日后可审计性的关键。
一个包含三个评分等级的分数会返回0到2之间的值,包括小数。接近0.5的Noul并不意味着硬币抛掷的结果不好,而是模型在提示您的状态并未区分这两种情况。在自动化流程中,这一信号的价值远胜于最终的数值结果,因为它正是您触发升级处理的依据。
当前模型为 jev-1.13.0 / jev-latest。上下文总大小为 64KB,其中状态部分占 32KB,另加最长的单条问题。仅支持文本输入。接口端点为 POST
https://api.typesafe.ai/v1/systemone,提供适用于 Python 的 typesafe-sdk 和适用于 JS/TS 的 @typesafe
-ai/sdk 两个 SDK,两者均需读取 TYPESAFE_API_KEY。如果您不想添加供应商,也可以通过 Vercel AI 网关和 OpenRouter 访问它。
第三部分:十一处决策点,附代码
这是本指南的实践部分。每个小节都是对上述循环的分支。
模型路由
选择能够完成该步骤的最便宜的模型。
代码块
Python
from langchain.agents import create_agent
from langchain_typesafe.experimental.middleware import (
ModelChoice, ModelRouterMiddleware,
)
router = ModelRouterMiddleware(
choices={
"fast": ModelChoice(
model="openai:luna",
criteria="Direct lookups, extraction, localized changes.",
),
"powerful": ModelChoice(
model="openai:sol",
criteria="Architecture and high-stakes decisions.",
),
},
instructions="Choose the least costly model that can complete the task.",
路由是经济逻辑最为隐晦的分支。第四部分将阐明为何它在长达两年的时间里始终未能奏效,以及为何一种非情境化的决策模型会改变其背后的数学逻辑。
工具调用准入控制
每个值得信赖的编码代理在执行危险操作前都会先对其进行分类。这一步骤过去一直存在于闭源系统中,如今则被整合为一行中间件代码。
代码块
Python
from langchain_typesafe.experimental.middleware import AutoModeMiddleware
guardrail = AutoModeMiddleware(tools=["bash"])
agent = create_agent("openai:gpt-5.6-luna", middleware=[guardrail])
用 JavaScript 自己实现:
代码块
JavaScript
两个问题,一次往返,大约100毫秒,且在您的安全路径上不产生任何生成令牌。
如果可能,应深入到命令字符串之外。在执行脚本之前先读取其内容并将其存入状态中,能够捕获一类仅凭文件名无法发现的问题。
作为相关性过滤器的上下文压缩
如今的压缩本质上是一种摘要提示。这很奇怪,因为摘要本身就是一种通用的压缩,而通用的压缩是很难的。相比之下,基于查询的压缩要容易得多:只要你知道自己在寻找什么,决定该舍弃哪些内容就变得轻而易举。
因此,直接对各块进行评分,而不是重新编写它们。
代码块
Python
questions = {
f"chunk_{i}": Score(
instructions="How relevant is this to the current goal?",
对每一次工具调用的输入、每一次工具调用的输出以及每一部分内部推理都进行打分,并剔除未达标准的内容。由于不进行重写,因此不会因不当的改写而丢失任何信息。
在实际环境中测得:将一个 Claude 会话从近 100 万个标记缩减至 8.6 万个标记,仅需 1 秒。
深度版本用按块的显示策略替换了二进制表示:不显示、简要摘要、详细摘要、全文。至此,上下文不再是一份静态日志,而成为一种依赖于查询的视图。
僵局检测
代理商在看似内部高效的周期中消耗预算。
代码块
Python
result = client.system_one(
state={
"goal": goal,
"last_5_actions": recent_actions,
"last_5_observations": recent_observations,
},
questions={
"progressing": Noul(
instructions="The last five actions moved measurably closer to the goal.",
),
"repeating": Noul(
instructions="The agent is repeating an action that already failed.",
),
},
)
if result.nouls["repeating"] > 0.7 or result.nouls["progressing"] < 0.3:
escalate()
每N次迭代运行一次。这几乎不耗费任何资源,也是应对整夜运行却把全部预算都花在原地打转上的最廉价保险。
下一个工作线程调度
经典的编排器分叉机制。
代码块
Python
from typesafe_sdk import Choice, TypeSafeClient
with TypeSafeClient(model="jev-1.13.0") as client:
result = client.system_one(
state={
"goal": goal,
"completed_work": notes,
"available_workers": available_now,
"constraint": "Save drafts for review. Do not publish.",
},
questions={
"next_worker": Choice(
instructions="Choose the next step for a research briefing.",
请看默认设置:当存在不确定性时,系统会将其置于“待审核”状态,而要覆盖这一状态则必须给出明确的肯定答复。这种设计并非偶然:在自动化领域,最易于应对的故障恰恰是停机过于频繁的情况。
0.85 只是一个占位值,请根据您自身流量中的标注样本进行调整。置信度并非准确率百分比。它是一种经过校准的确定性信号,您需通过经验设定其阈值。
从实时菜单中选择操作
从浏览器使用中汲取的最佳灵感。
浏览器的可用操作在每次点击后都会发生变化,因此与其一次性描述一个固定的操作空间,其智能体会实时构建一份当前可识别的控件列表,并让Jev从中进行选择。只有当某个输入框需要输入文本时,小型语言模型才会被调用。
将其应用于您自己的调度器:
在任何工具的状态发生改变后,请刷新选项。否则,您的决策模型将仍基于昨日的菜单进行选择,而即便答案再自信,一旦其所选的选项已不复存在,也毫无意义。
代码块
Python
# wrong: the menu was built at startup
criteria = {w.name: w.description for w in ALL_WORKERS}
# right: the menu is built from what exists and is free right now
criteria = {
w.name: w.description
for w in ALL_WORKERS
if w.is_available() and w.can_handle(current_state)
}
对于超大规模的候选集合:先在代码中筛选出明显不匹配的项,对留下的候选进行打分,再从入围名单中进行选择。选择功能最多支持255个选项,而TypeSafe正是采用这种两阶段模式来应对高基数问题。
完成检查
一个自信的答案并不能证明文件已被保存或消息已被发送。
这句话应该被印在每一位从事夜间自动化工作的员工的墙上。把这两项检查分开:
代码块
Python
# Jev decides the work looks done
done = client.system_one(
state={"goal": goal, "artifacts": artifact_list},
questions={
"complete": Noul(
instructions="Every deliverable named in the goal now exists.",
),
},
)
# then code proves it independently
if done.nouls["complete"] > 0.8:
assert draft_path.exists(), "model believes it saved a draft, filesystem disagrees"
assert draft_path.stat().st_size > 500
浏览器使用正是如此:在Jev选择“完成”后,会由另一项独立的检查来验证结果。借鉴这种分离机制。决定一项任务是否已完成的主体,绝不应是唯一确认该任务已结束的依据。
上报至人工处理
这正是决定您的自动化是否值得信赖的分叉。
代码块
Python
result = client.system_one(
state={"action": proposed_action, "context": context},
questions={
"reversible": Noul(instructions="This action can be undone without cost."),
"touches_money": Noul(instructions="This action moves money or changes billing."),
"external_reach": Noul(instructions="This action is visible outside the organisation."),
"risk": Score(
instructions="Blast radius if this is wrong.",
criteria=["Local and trivial", "Recoverable with effort", "Irreversible or public"],
),
},
)
四个问题、一次通话,以及一条写在代码里的政策,而非仅凭提示中的某种感觉。一直让我受益匪浅的准则就是:凡是不可逆、需要成本或对外可见的事项,无论信心多足,都必须交由人工处理;其余一切则按不确定性程度逐级上报。
检索作为决策
参见第六部分。在检索阶段,大多数人将点积视为语义的近似表示,而这也是整个流程中最容易停止这样做的环节。
基于轨迹的在线评估
对已完成的运行进行评估,并将结果反馈至路由决策中。
代码块
JavaScript
result = client.system_one(
state={"goal": goal, "trace": trace, "final_output": output},
questions={
"satisfied": Noul(instructions="The final output satisfies the original goal."),
"efficiency": Score(
以这个价格,您可以对每一次运行都进行完整评估,而无需抽样,这意味着您的路由阈值将不再依赖猜测。
在整个流程中的任意位置进行分类
工单、邮件、文档、日志行,任何需要分支的入站数据流。其结构始终相同:项目即状态,目标即条件。
来自生产的参考指标:500封邮件在数秒内完成分类,每封仅需3.5美分;1,018篇研究论文被归纳为24个主题,总费用仅为0.08美元,平均每篇耗时256毫秒,且由DeepSeek V4 Flash率先生成摘要。此外,一条反欺诈流水线在1.42秒内处理了100封邮件,将不确定的尾部转交给Kimi K3,并以约7美分的成本实现了96%的准确率。
最后这一点正是大多数生产级分类应有的形态:由廉价模型做出决策,昂贵模型负责处理尾部情况,而升级阈值则是一个经过调优的数值,而非凭空臆想。
第四部分:为什么路由需要一种不依赖上下文的模型
模型路由是廉价决策模型最显而易见的应用,但也是那个在两年间悄然失效的领域。弄清其中缘由,有助于我们更好地理解智能体架构的诸多问题。
算术
两种模型。Opus 的输入为每百万个词 5 个,输出为每百万个词 25 个。Sonnet 的输入为每百万个词 3 个,输出为每百万个词 15 个。
方案:把简单的部分交给Sonnet,把难的部分留给Opus。
设X为数以百万计的上下文标记,Y为数以百万计的生成输出标记,Z为在该输出中额外生成的标记,例如Shell命令和文件读取等。
纯Opus:
代码块
Plain Text
25 * Y generation
5 * Z reading
-------
25Y + 5Z
Opus → Sonnet → Opus:
代码块
Plain Text
3 * X Sonnet loads the context
15 * Y Sonnet generates
3 * Z Sonnet reads
5 * (Y + Z) Opus reloads everything Sonnet produced
-------
在X = 0.65、Y = 0.12、Z = 0.23的现实分配下:
代码块
Plain Text
(25 * 0.12 + 5 * 0.23) / (3 * 0.65 + 20 * 0.12 + 8 * 0.23)
Pure Opus 的成本约为路由路径的三分之二。
路由一次再回退的代价,比完全不进行路由还要高,因为当控制权重新回到该模型时,它必须重新读取整个上下文。重建 KV 缓存是其中最主要的开销,而在定价页面上却难以察觉。
一种从不参与对话的决策模型会彻底消除该术语。Jev 不加载历史,不生成标记,也不留下需要重建的缓存。决策在循环之外完成,并返回一个类型化的值,供您的代码据此进行分支处理。
这就是决策层与更廉价模型之间的架构差异,也是为什么如今路由能够正常工作、而此前却无法实现的原因。
缓存税还打破了另外五件事
一旦税收变得显而易见,许多代理设计就不再像设计,而更像是一道道疤痕。
工具调用是一种糟糕的交易。无论这些工具在本轮是否相关,都必须在系统消息中提前声明。这是一种永久性的上下文开销,而且模型本身在高基数的策略外工具选择方面也并不擅长。
压缩依赖于一个假设。即每个未来的轮次都希望使用同一个共享状态。一旦放弃这一假设,基于查询的过滤性能将始终优于通用压缩。
子代理的表现不佳。它们的大部分开销都花在了决定传入何种上下文以及如何将结果合并回外部,而非实际的工作本身。如果能降低这一决策的成本,那么创建子代理就变得值得了。
重启是必要的,因为状态被视为有状态且最终会损坏。按需加载相关旧状态是另一种方案,但没人负担得起。
电池被排除在外是因为每个包含的电池都会永久性地增加上下文成本。如果提示能够廉价且按需加载模式,你就能以接近零成本的方式发布数百种工具。
第五部分:安装它
步骤1:在编写代码之前,先在 Playground 中测试一个 fork
打开 console.typesafe.ai/playground。请使用您自己代理的真实状态对象,而非示例数据:
代码块
JSON
{
"goal": "Compare three AI-agent tools in a morning briefing.",
"completed_work": "No sources collected yet.",
"available_workers": ["Researcher", "Writer"],
"constraint": "Save drafts for review. Do not publish."
}
先运行调度问题,再用真实的调研笔记替换 completed_work,然后再次运行。观察决策的流转过程,比任何文档都更能揭示你的状态设计是否合理。
步骤2:安装SDK
Python 3.12 或更高版本。
代码块
Bash
mkdir jev-starter && cd jev-starter
Windows:
代码块
PowerShell
mkdir jev-starter; cd jev-starter
py -3 -m venv .venv
.\.venv\Scripts\python.exe -m pip install --upgrade typesafe-sdk
在 console.typesafe.ai/settings/keys 获取密钥。向该账户发起计费请求。
如果您使用的是编码代理,请安装官方技能,以便其生成正确的集成方案,而非凭猜测:
代码块
Bash
# Claude Code
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
# anything else
该技能向智能体传授API以及将多个问题合并为一次调用的模式。它并不会让你的编码智能体变成Jev。
步骤3:在接触你的智能体之前,先构建一个独立的路由器
请勿在上线首日就将其接入生产环境。应将调度器作为独立脚本进行开发,先观察其运行决策过程,再将其正式接入。
代码块
Python
import json, os
from getpass import getpass
from pathlib import Path
from uuid import uuid4
from typesafe_sdk import Choice, TypeSafeAPIError, TypeSafeClient
if not os.environ.get("TYPESAFE_API_KEY"):
os.environ["TYPESAFE_API_KEY"] = getpass("TypeSafe API key: ").strip()
goal = input("Goal: ").strip()
if not goal:
raise SystemExit("Enter a goal.")
代码块
Plain Text
$ .venv/bin/python chief.py
TypeSafe API key: ••••••••••
Goal: Compare three AI-agent tools for tomorrow's briefing
Completed work: No sources collected yet
Saved handoff: /Users/you/jev-starter/queue/research/a3f8....json
每次运行都会在 queue/research、queue/write 或 queue/review 目录下生成一个 JSON 文件。这些是本地任务队列,已保存的作业会一直等待,直到有工作进程将其取出并处理。请针对待办事项中的真实目标重复执行二十次,并查看生成的文件。您将能在造成任何损失之前发现其中存在的不良标准文本。
步骤4 将其连接到您的工作人员
将这份简报交给您的编码代理:
代码块
Plain Text
步骤5 失败表
代码块
Plain Text
Symptom Fix
python not found finish the Python install, reopen the terminal
module not found rerun the SDK install with the same .venv interpreter
401 replace the API key and rerun
422 check the named request field against your code
429 / 529 allow backoff, retry later if it persists
SDK会进行重试。如果API错误在重试后仍未解决,脚本将停止。
第六部分:状态设计,成败往往在此
导致决策失误的原因很少是模型本身,通常是状态管理的问题。
请提供证据,而非结论
代码块
Python
# useless
state = {"status": "The researcher finished."}
# useful
state = {
"goal": goal,
"sources_collected": [
{"id": "s1", "title": "...", "published": "2026-09-14", "key_claim": "..."},
{"id": "s2", "title": "...", "published": "2026-09-16", "key_claim": "..."},
],
"findings": ["...", "..."],
"gaps_remaining": ["no pricing data for tool C"],
"actions_taken": 7,
}
第一种版本会迫使模型进行猜测,而第二种则让模型自行决定。请将原始请求、进展状态和约束条件分别置于不同字段中,以便模型能够加以区分。
字段名称毫无意义
杰夫看不到您的问题ID。为字段命名“safe_to_publish”并不会产生任何指令。相关要求体现在指令中,以及每个选项的描述里。
python
代码块
Python
# the name is for your code
"safe_to_publish": Noul(
# this is what the model actually reads
instructions="This content can be published externally without legal or "
"brand review, contains no customer data, and makes no "
"claims about unreleased products.",
)
按标准而非标签来描述选项
“研究”毫无意义。“为实现目标仍需收集证据”才真正有意义。判断标准的表述才是关键所在,一旦答案显得不合理,首先就应该修改这一部分。
将所有读取相同状态的问题批量处理
请求中的问题会并行针对同一状态进行评估。添加问题几乎不会增加延迟,且仅需支付其对应的token费用。
你还可以执行推测性分支:在一次调用中询问多个可能的下一步行动,并仅采用你所选择的分支对应的答案。未被采用的答案几乎不产生任何成本。
代码块
Bash
result = client.system_one(
state=state,
questions={
"next_worker": Choice(instructions="Choose the next step.", criteria={...}),
"urgency": Score(
instructions="Rate request urgency.",
labels=["low", "medium", "high", "critical"],
唯一的硬性限制: 问题之间不能互相查看对方的答案。如果某个决策依赖于新的搜索结果,请先进行一次搜索,然后再发送第二次请求。
在购买更快速的模型之前,请先审核您的工具调用
一个值得牢记的数字。Browser Use 的优化运行时将浏览器协议调用的中位数从 1,092 个降至 101 个,且在三组匹配样本中,任务耗时的中位数下降了 25%。在两端使用相同的模型的情况下,这一效果得以实现。其优势源于仅读取一次页面状态,并且不再对无关的动画进行重复预测。
代理的延迟通常是结构性的,而非模型固有的。在查看发票之前,请先检查循环。
第七部分:将检索视为智能体的决策
大多数检索代理通过嵌入相似度进行检索,并将点积作为语义的近似表示。根据语料库的规模,有两种更优的方案。
小型语料库:Jev 作为相似度度量
完全跳过嵌入。对每一对(查询,文档)进行打分,并按返回的概率排序。
代码块
Plain Text
无需调用N,无需嵌入模型,无需向量存储,无需维护索引的实时性,也无需调整分块策略。返回结果为:文档17,p=0.97;文档4,p=0.91;文档22,p=0.12。
对于几百份文档而言,这种方法更加简单且更优,因为它能够检索到那些与查询语义不相关、却能准确回答查询的文档。
大规模语料库:Jev 是重排序器
代码块
Plain Text
query ──> embeddings + dot product ──> top k ──> Jev (query, candidate) ──> reranked
millions of docs k calls, semantic match
cheap, approximate, recall not precision
嵌入向量擅长的正是低成本、高召回率的候选生成。而Jev则在筛选后的候选列表上执行语义匹配,这正是决定精确度的关键所在,也是点积方法表现最弱的环节。
规则:
•
小数据:直接以Jev作为相似度度量,对每一对进行打分,按概率排序。
•
大数据:通过嵌入向量筛选候选集,再由Jev进行重排序。
第八部分:发掘值得构建的模式
正是线束设计导致了同样的重量在一种配置下得分为78%,而在另一种配置下仅为42%。型号相同,但回路设计不同。一旦决策成本降低,此前不具经济性的多种线束设计方案便得以实现。
用元注意力取代压缩。对于任意给定的查询,重新评估当前上下文的质量,并构建一个更优的上下文。在最简单的情况下,每个分块生成一条新内容;在更复杂的情况下,则根据得分选择“不显示”、“简要摘要”、“详细摘要”或“全文”。上下文不再是一条日志,而变成了一种视图。
廉价的子代理。如果决定传入何种上下文并将其合并回主流程,这一过程被视为类型化的问题而非模型调用,那么同时启动大量并行子代理便变得切实可行,同时也继承了诸多棘手的问题:共享状态、写锁以及同步机制。
介于技能、MCP 与工具之间的折中方案。您同时需要三样东西:既能提示某项操作的存在,又能在需要时按需加载完整架构,同时还不能污染上下文。做到这一点,您就能以几乎零成本整合数百种工具和数千份文档。
条件性 AGENTS.md。 仅在前端开发时加载样式指南。仅在该子目录中加载注意事项文件。技能虽相近,但更倾向于表达“现在就做这件事”,而非“请记住这一点”;且已加载的技能会在下一次压缩时被自动汇总。 相关性评分上下文不存在该故障模式。
安全感知路由。路由的考量并不仅限于成本。如果子任务存在接触不同类别文件的风险,您可以针对每一类文件应用不同的策略,从而将敏感业务完全隔离于特定的服务提供商之外。
后台只读任务。在优秀的智能体工作流中,一种模式反复出现:仪表板并行更新、评估在后台生成、跨模型评审——即一个智能体对另一个智能体的输出进行审查。这些操作都只是基于当前仓库状态的只读功能。为一项变更找到相关信息是最耗费成本的环节,而如果这项工作能在每个后台任务中得到共享,那么同时运行多个任务就会变得经济实惠。
第九部分:自动化的经济学
每百万个输入标记0.042美元,输出免费。每次决策计费1,000个输入标记,一万次决策的费用为42美分。
现在请正确地进行比较。按照每轮迭代保守地设定为五个决策点、每个任务执行二十轮迭代、每天处理一百个任务的假设,从第三部分中提取出这十一个决策点:
代码块
Plain Text
5 * 20 * 100 = 10,000 decisions/day
10,000 * 1,000 tok = 10M input tokens/day
10M @ $0.042/MTok = $0.42/day
在前沿模型上,同样的上万次决策,即便以每兆瓦时1美元的廉价输入成本、且输出周期较短,其计算开销仍高出两到三个数量级,而且每一次决策耗费的都是秒级时间,而非毫秒级。
但真正关键的指标是每项完成任务的成本,而非每项决策的成本。一项代价低廉却导致员工误入歧途的决策,其实际成本远高于决策本身。仪器的完成次数。
参考点,每个均注明其适用范围:
•
浏览器在7秒内以0.0039美元的价格找到了航班,这一结果与记录的90,558个Jev输入令牌以及文本助手的费用相一致。浏览器基础设施的成本不包含在该费用中,计时从首次页面加载开始,且其功能仅限于搜索航班,而非实际预订。
•
1,018篇论文,总费用为0.08美元,平均每篇耗时256毫秒。
•
3.5美分即可完成500封邮件的分类处理。
•
一次Claude会话在1秒内将约100万令牌压缩至8.6万令牌。
•
Vercel的AI团队报告称,其安全分类速度比GPT-5.6 Luna快5到18倍,且准确率有所提升。这仅涉及分类器环节,并非整个智能体运行过程。
TypeSafe 官方主页上宣称的“快 193.6 倍、便宜 444.6 倍”的数据,源自其自身的工作流评测。该评测方法总体而言优于多数同类研究:每个模型均采用相同的工作流,且不允许进行任何专用工具或框架的开发;然而,这些工作流是由其自身的模型能力团队设计的,而参考答案则取自 GPT‑6 Astra 和 Fable 5.1 的平均值,这在一定程度上偏向于 OpenAI 和 Anthropic 的模型。TypeSafe 将其描述为更接近现实收益的高端水平。
第X部分:你会遇到的失效模式
这可能是字面意义上的。它执行的是标准所规定的内容,而不是你本意。在指责模型之前,请先重新审视标准。
计数、算术和日期相关的数学运算较弱。请在代码中完成这些计算。此功能不可通过提示词调用。
过度的间接引用和庞大的、杂乱的状态会使其性能下降。如果回答一个问题需要经过三次状态转换才能将问题与证据关联起来,那么请重构状态或拆分该问题。
提示注入依然有效。类型安全保证的是答案的形态,而非推理过程的完整性。如果不可信的内容存在于你的状态中,它就可能影响最终的判定结果。对于基于不可信输入的门控决策,应抱持与对待大型语言模型同样的谨慎态度。
校准是一项分布特性。在多次调用中,置信度越高,准确率也越高。但它并不能证明任何单个答案的可靠性。
仅支持文本输入。目前尚不支持图片、音频或视频,这一点在您的智能体以截图为主时尤为重要。
上下文大小为64KB,其中32KB用于存储状态,再加上最长的提问。大型轨迹在转化为状态之前需要进行过滤,而这本身也是一项艰巨的工作。
从哪里开始
请勿重构您的智能体。请选择它最常触发的分支,通常是工具调用分支或下一员工派发分支,并将该分支移至新位置。
然后在一周内测量三项指标:
每完成一项任务的成本,而非每次通话的成本
每完成一项任务的实时时长
升级路径触发的频率,以及它在多少情况下是正确的
如果三项指标均有所改善,则进入下一个分支。如果升级路径从未触发,则说明你的阈值设置过于宽松,你实际上已经悄然构建了一个无人监管的系统。
大多数建造者在每一个“是”、“否”、每条路线和每项得分上都会继续按前沿价格付费,因为这些调用单独来看都是不可见的,只有汇总后的账单才会显现。而少数能够将生成、决策与规则清晰分离的人,则会运行与他人相同的模型,且速度和成本都高出一个数量级。