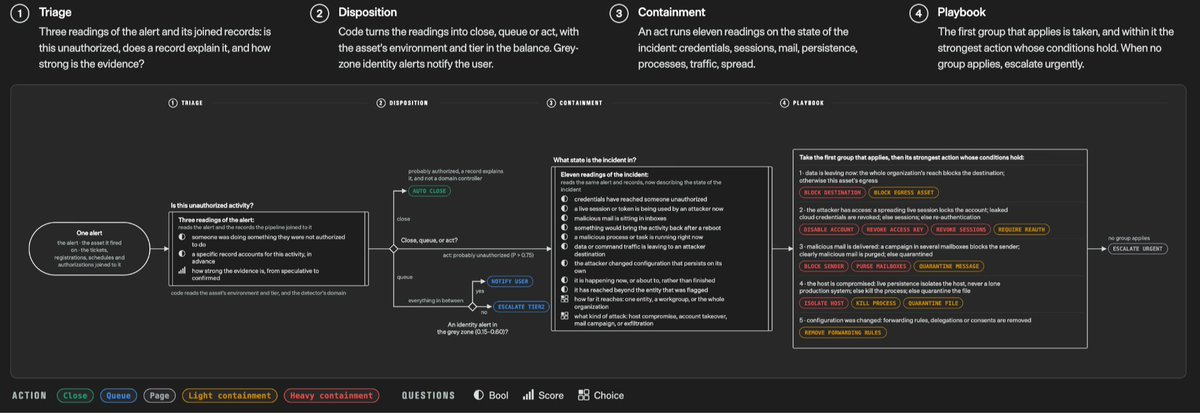
简介
Jev 是 TypeSafe 的旗舰模型,也是首款 System One 模型。发送状态和类型化的问题,即可获得您的代码可直接使用的结构化答案。
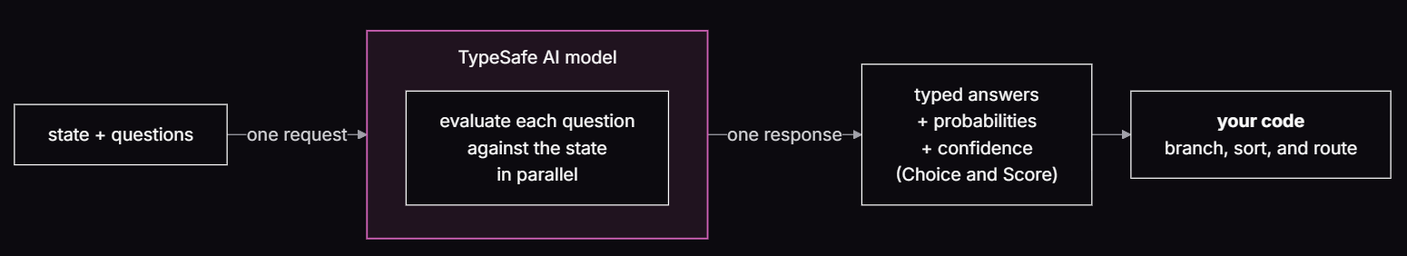
大型语言模型(LLMs)旨在生成供人类阅读的文本。而当你需要模型做出一种你的代码将直接使用的判断时,这就产生了不匹配:你实际上是在强迫一个文本生成系统输出结构化的决策,然后再将结果解析为你的代码能够依赖的形式。Jev 是 TypeSafe 的旗舰模型,也是首款System One 模型。System One 模型旨在做出快速、结构化的决策,供软件直接使用。Jev 会针对已类型化的问题在状态上进行评估,并直接返回结构化结果。无需文本生成,也无需解析。您将获得可由代码进行分支、排序和路由的已输入值与概率分布。Choice 和 Score 还会返回置信度,供您的代码据此决定是否以及如何对答案采取行动。
TypeSafe原语
TypeSafe 提供了三种AI 原语。与软件原语类似,我们的 AI 原语同样具备模块化、可组合、结构化、可靠且高效的特点。每种原语都针对不同类型的问题提出相应的问题,并返回相应类型的答案。
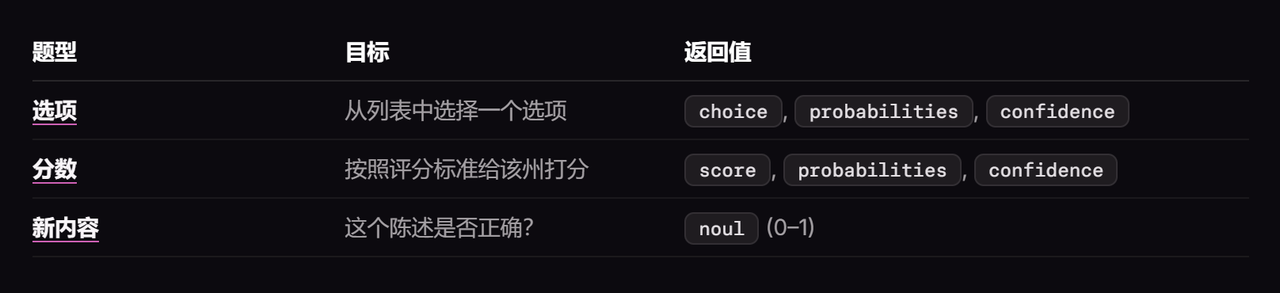
所有三种题型均可在一次 API 调用中混合使用。每一道题型题目都会在同一时刻、独立于其他题目,针对同一状态并行进行评估。新增题目几乎不会影响响应时间。由于每道题目均独立评估,因此增加题目数量也不会导致上下文污染。
以代码组合的原子问题
当每个问题仅聚焦于一个具体且范围明确的事项时,System One 模型的表现最为出色。不妨将每个问题视为一种“直觉性判断”:在恰当的情境下,一位知识渊博的人只需几秒钟便可作出这样的判断。
如果您的问题需要深入推理或涉及多个独立因素,请将其拆解。将每个因素分别作为单独的问题提出,然后在代码中通过逻辑对结果进行整合。这样既能确保每次单独评估的可靠性,又能让您完全掌控各维度的权重分配。
例如,与其问“给这个创业项目路演打分”,不如分别询问市场规模、技术可行性与差异化优势。再将各项得分按你自定义的公式进行加权汇总。当优先级发生变化时,只需修改代码中的某个系数,而无需重新撰写评分标准。