Jev工程:为您的客服人员打造决策大脑的十步指南
您构建的每个智能体都存在同样的性能瓶颈:一个昂贵的模型在循环中不断回答“是”或“否”,挑选下一个任务执行者,并评估相关性。而这些调用本无需生成环节。这就是将它们迁移到专门用于决策的模型上的方法。
LLM生成作品 → Jev决定下一步行动 → 代码执行该决策。这种拆分就是整个学科的核心。以下是将决策大脑部署到你现有智能体中的10步设置流程。步骤顺序至关重要:每一步都为下一步奠定基础。
步骤01 找到你的特工杰夫可以接管的部分
在编写任何代码之前,先将客服人员的通话分为两类。如果该操作生成文本,则归入LLM;如果该操作从列表中选择一项、对某个数值进行评分,或回答“是”或“否”,则归入Jev。
获取来源、撰写段落和保存文件等任务仍由您的工具与生成模型负责。“接下来由哪位工作者执行?”以及“该来源是否相关?”这类问题适合作为Jev的决策依据。而诸如“在执行十次操作后停止”之类的明确规则,则应写入代码,而非纳入任一模型之中。
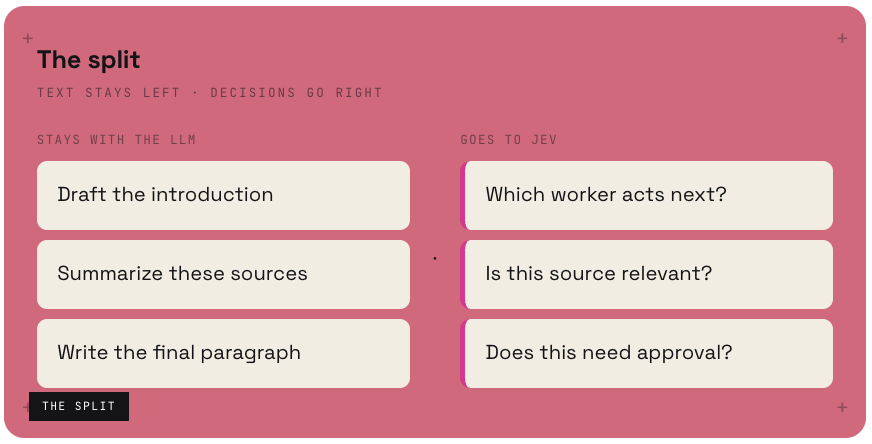
测试很简单。如果操作生成的是文本,则留在LLM中;如果是选择、打分或回答“是”或“否”,则转交给Jev。
步骤02 设计 Jev 读取的状态
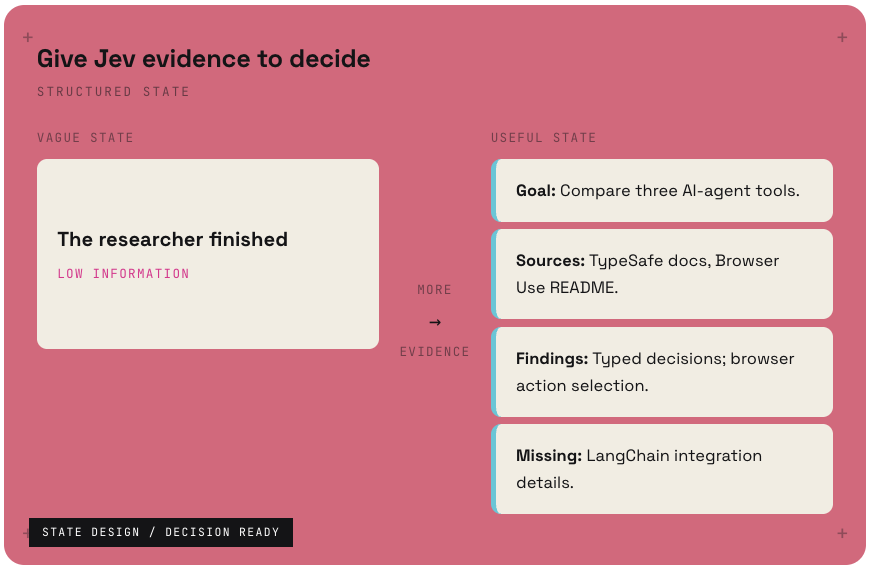
杰夫的性能完全取决于你赋予它的状态。它并不会主动去寻找上下文,而是根据你提供的内容做出判断,因此模糊的状态必然会导致模糊的决策。
请提供确凿证据,而非主观感觉。一个有效的状态报告应明确目标、列出信息来源、说明已发现的内容,并指出尚缺的部分。正是这种结构,才能使决策模型给出清晰明确的答案,而非凭空猜测。
代码块
JSON
state = {
"goal": "Compare three AI-agent tools in a morning briefing.",
"completed_work": "No sources collected yet.",
"available_workers": ["Researcher", "Writer"],
"constraint": "Save drafts for review. Do not publish."
}
步骤03 请先在Playground中测试一个问题
在观看Jev回答一次之前,请勿将其集成到代码中。打开TypeSafe Playground,粘贴您的状态,并提出一个简单的问题:“下一个该由哪位工作人员执行?”
将选项定义为预设列表。观察用户输入的答案返回时附带的置信度分数。如果答案错误,通常只需修正状态即可,无需调整模型。强化证据后再次提问。
代码块
Python
# three options, one decision
question = {
"type": "choice",
"prompt": "Which worker should act next?",
"options": [
"research", # missing evidence
"write", # enough evidence to draft
"review" # unclear request or completed work
]
}
# returns: option + confidence
步骤04 了解三种问题类型
Jev 为你提供了三种问题类型,每种都针对不同类型的决策而设计。你智能体中的每一个决策都会对应其中一种。
选择路径。评分排名。新门。在这些之间,你代理中的每一个二选一、单选或排序决策,都有一个不属于前沿模型的归宿。
步骤05 将庞大的列表缩小至一个
真正的威力体现在对类型进行链式组合时。单个 Choice 最多可容纳 255 个选项,但更简洁的模式是漏斗式:通过规则筛除显而易见的选项,再由 Score 对剩余选项进行排序,最后由 Choice 做出最终选择。
假设你要从一份包含数十人的名单中选出一名候选人。首先,根据资格规则筛除所有不符合条件的人;接着,通过杰夫评分对留下的候选人进行排序;最后,由杰夫选择做出最终的选定。每一层的成本都很低,而最终作出的决策也经得起推敲。
步骤06 与调度员协同作业
现在,把Jev放到代理团队中它应有的位置:介于共享状态与各工作线程之间。这就是“首席幕僚”模式。共享状态负责维护目标、进展以及已收集的证据;Jev读取这些信息并作出决策;随后,由调度器将决策传递给具体的工作线程。
工人、研究、写作、人工审核,都从同一个共享状态中获取任务并返回结果。循环就此闭合。Jev 从不生成任何内容,它仅负责决定由哪个工人在何时执行操作。
代码块
Python
decision = jev.choice(state, question) # which worker?
if decision.confidence >= 0.85:
dispatcher.send(decision.option, state)
else:
dispatcher.send("human_review", state) # escalate
步骤07 别再为等待彼此而付费提问了
您的调度器可能需要一名工作人员、一个紧急程度评分以及一项审批检查。如果这三项都能检查同一状态,请将它们一并发送。TypeSafe 支持并行提问,因此这三项决策可以同时作出,而无需按顺序逐一处理。
唯一一条规则:各查询不得读取彼此的答案。如果某个决策依赖于新的搜索结果,应先执行该搜索。不过,所有读取当前状态的查询均可并行执行。
代码块
Python
步骤08 添加线束:路由器和闸门
该工具链为您提供两层 Jev,且两者均不生成文本。位于顶部的模型路由器会挑选能够处理请求的最经济实惠的模型。底部的自动模式门禁则会在危险的工具调用执行前将其拦截。
两者都基于同一套决策定价机制运行。前沿模型绝不会仅仅为了询问“这个请求是否简单?”或“这条 Bash 命令是否安全?”而被调用。这些都属于决策范畴,而决策会交由 Jev 处理。
代码块
Python
python · harness.py
# Jev checks every tool call before execution
# blocks risky actions, approves safe ones
guardrail = AutoModeMiddleware(tools=["bash"])
agent = create_agent("openai:gpt-5.6-luna",
middleware=[guardrail])
步骤09 请使用 Jev 进行压缩,而非汇总
以下是令人大为惊讶的用例。一直以来,上下文压缩都是一种摘要式提示:让大模型对历史记录进行精简,并期望它保留关键信息。这本质上属于生成任务,既耗时又难免损失细节。
Jev 通过为每条输入打分并剔除无关内容,实现了即时处理。这并非简单的摘要,而是一种以决策速度运行的相关性过滤器。Alex Volkov 曾对其进行测试:仅需一秒,便能将一个近百万 tokens 的 Claude 对话会话压缩至 8.6 万 tokens。
摘要器负责改写,相关性过滤器则决定保留或舍弃。后者本质上是一种决策过程,这也是为什么Jev能在一秒钟内完成,而前沿模型却需要一分钟的原因。
压缩并非一种汇总提示。它是一种相关性过滤器——而过滤器本质上是一种决策。
第10步 统计你刚刚移除的成本
现在来衡量一下变化。Jev 的价格为每百万个输入 token 0.042 美元,且不收取输出 token 费用。按每次决策计费 1,000 个输入 token 计算,一万次决策的 Jev 推理成本约为 42 美分。
相比之下,若将同样的一万通“是”或“否”的呼叫通过前沿模型进行路由,其差距正是问题的关键所在。你并未让客服人员变得更智能,而是停止为那些本就不具世代意义的工作支付代价。
转变
大型语言模型创作作品 → 杰夫决定接下来的走向。
Jev 并非又一个聊天机器人。它是一个快速的决策层,能够读取您系统的当前状态,并在您所定义的选项中做出选择。真正的核心价值并不在于那场七秒的飞行演示,也不在于廉价的论文分类任务。
真正的价值在于意识到,你的智能体内部有多少昂贵的大型语言模型调用其实根本无需生成:
•
让大型语言模型进行研究、撰写和生成。
•
让Jev负责路由、评分、审批或升级处理。
•
让代码执行决策。
杰夫工程学就是将这三者各归其位的学科。只需安装一次决策大脑,对其进行测量,然后替换掉你发现的每一个昂贵的分叉。