Jev作为Agent评估的评判者
如今,智能体评估主要分为两种:基于代码的评估与以大语言模型为裁判的评估。这两种方法各有局限:基于代码的评估仅适用于输入固定、问题范围狭窄的场景,而以大语言模型为裁判的评估则往往速度慢、成本高且可靠性不足。
Jev是什么?
Jev是TypeSafe AI推出的一款全新模型。Jev其实并非传统意义上的大型语言模型,它并不生成文本。它被TypeSafe AI团队称为“系统一”模型:
System One 模型是一类专为做出快速、结构化决策而构建的人工智能模型,其输出可被软件直接使用。System One 模型会评估一个状态,并返回类型化的答案及相应的概率。
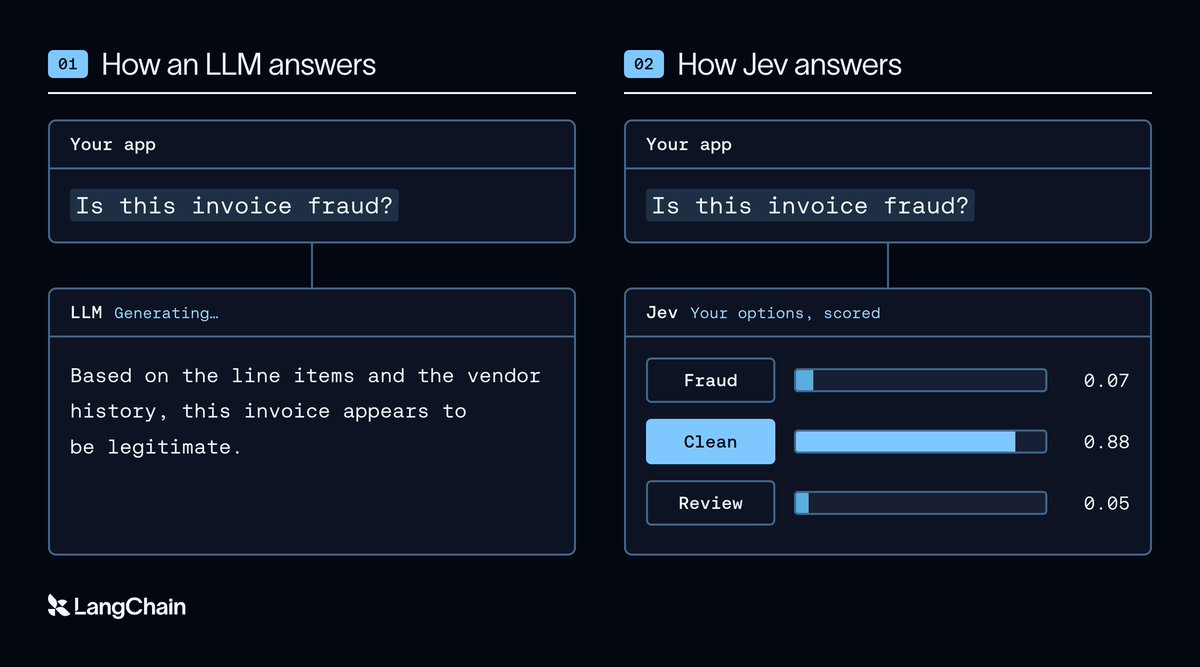
自回归型大型语言模型与系统一模型(Jev)如何回答同一个问题
据TypeSafe AI称,这使得Jev在分类任务上的推理速度比大型语言模型快高达200倍,成本低至400倍。
关键要点:
•
Jev 是一种截然不同的评估工具。它直接返回类型化的答案,而非像 LLM 评审那样生成文本。
•
杰夫在连续得分方面的表现显著更为稳定。其质量得分的方差比GPT-5.6、Luna、Terra以及Claude Sonnet 4.6低了92至913倍。
•
杰夫的速度也最快,费用也最低。其平均耗时为0.44秒,每通电话的费用为0.00035美元(总费用仅为0.34美元,而克劳德则高达28.17美元)。
•
结果令人鼓舞,但尚属早期。尽管这是一项范围有限的测试,Jev的表现却为智能体评估指明了一个引人注目的新方向。
为什么Jev可能是一位优秀的代理人评估员?
如今的智能体评估要么基于代码,要么采用大语言模型作为评判者,二者各有其优势、局限与权衡。
基于代码的评估与代码本身一样古老。它成本低廉、快速且可靠,但其主要缺点在于能力较为局限。由于传统函数需要确定性的输入集合,它在评估代理行为这一随机性极强的世界时显得力有未逮。例如,尽管一个传统函数能够在首次运行时判断某个智能体是否调用了某项工具,但要评估该智能体随后是否利用该工具的输出成功回答了用户的问题,则会更加困难。在开放式任务中,同一工具输出可能存在多种合理的使用方式,因此若将每一种可接受的答案都编码为确定性逻辑,很快就会遭遇基于代码的评估所固有的范围狭窄的局限。
引入LLM作为裁判,它利用大型语言模型对智能体轨迹中的非结构化输入进行推理并予以评分。LLM裁判能够将问题、轨迹和证据作为非结构化输入,随后通过提示词评估响应是否回应了用户的需求。
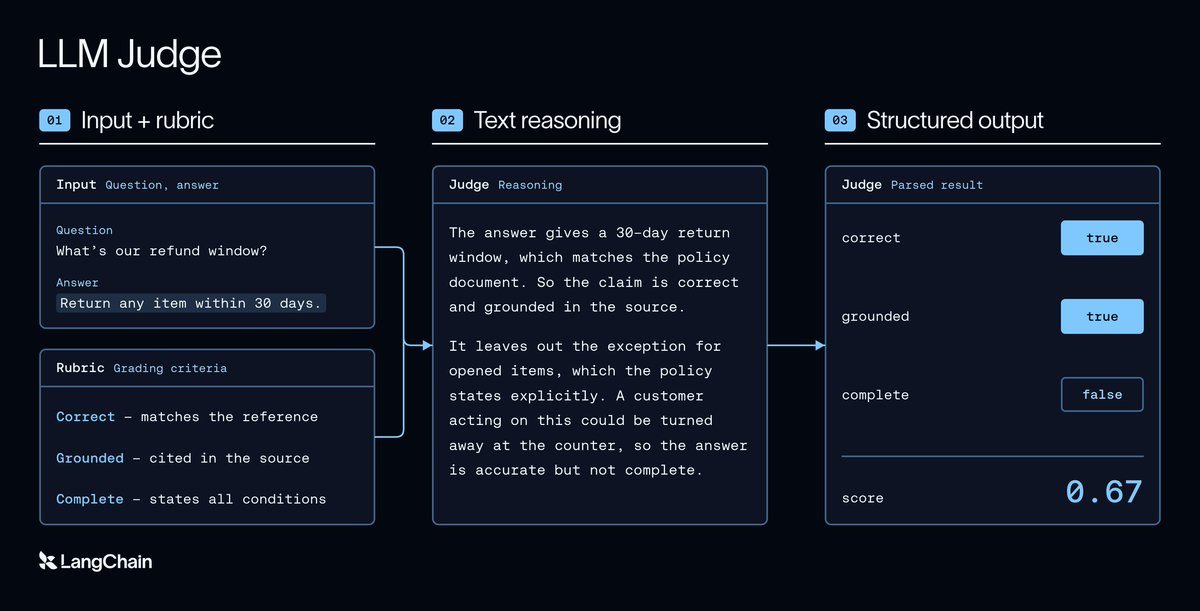
LLM法官如何为评估生成结构化结果
然而,正如任何代理工程师都会证实的那样,LLM 评判器并非完美的解决方案。它们本质上是非确定性系统,难以作为可信测试工具的坚实基础。此外,与传统的基于代码的评估方法相比,它们运行速度更慢、成本更高。
智能体评估是一项决策任务:根据智能体的状态与行为,为其打分并提供反馈。Jev正是为此类场景而设计的。它将输入的文本型问题与结构化状态进行匹配,并以概率形式返回相应的文本型答案。相比之下,自回归模型则是通过逐个生成token的方式来得出最终判断。在我们的实验中,这种以决策为先的设计同时带来了更低的延迟、更低成本和更小的方差。
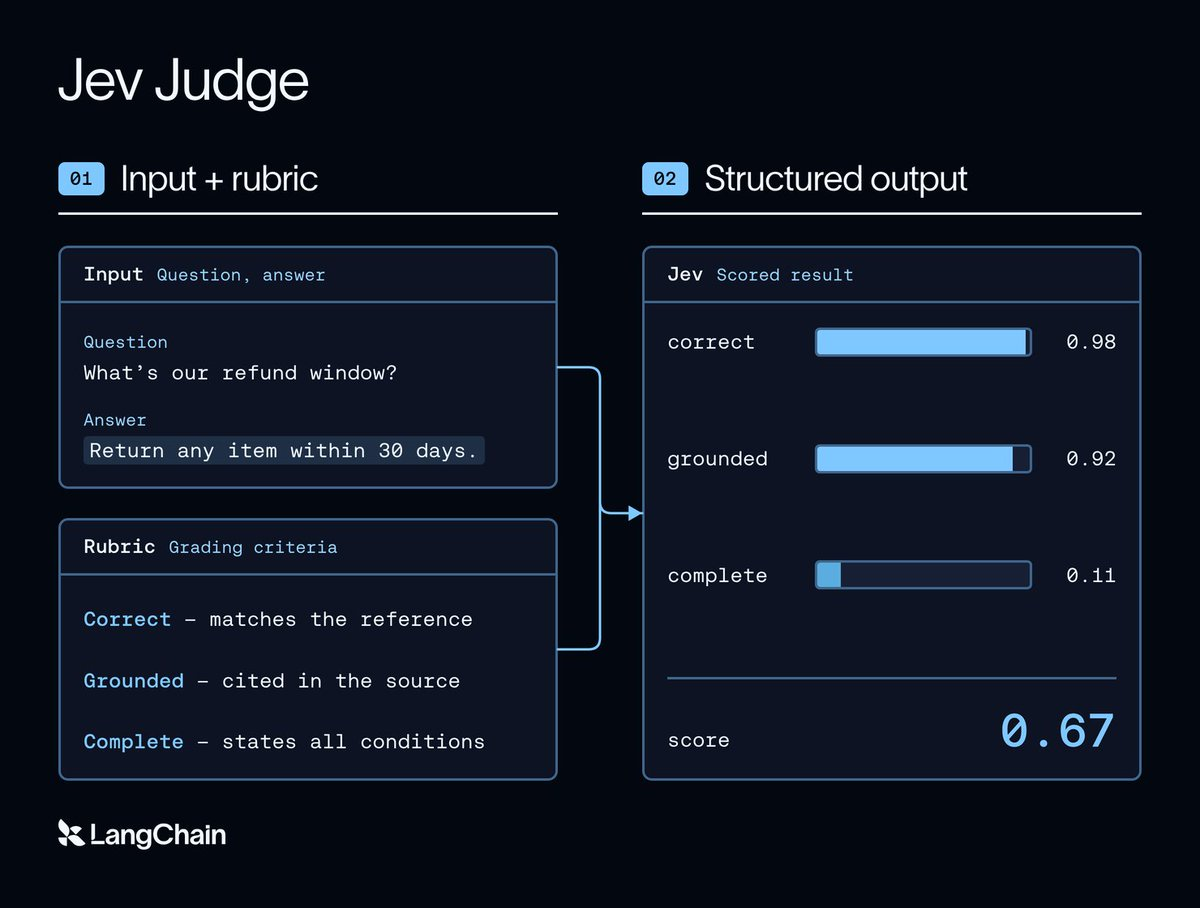
杰夫·贾奇如何为评估生成结果,请注意,结构化输出已作为模型的原生功能提供
Jev 支持三种类型的题目:
Choice 选择一个选项,并返回概率与置信度。
•
示例:“最终答案是否基于检索到的证据?”
•
响应:一个介于0.0到1.0之间的浮点数,其中1.0表示完全有据可依
评分 根据有序评分标准对答案进行打分,并返回概率与置信度。
•
示例:“该答案有多有用?”
•
回复:从1分(无帮助)到5分(非常有用)的评分标准,以及概率和置信度
Noul返回一个是/否判断为真的概率。
•
示例:“哪个搜索结果最能描述这次运行?”
•
响应:搜索结果为“适当搜索”、“不必要搜索”或“未搜索成功”之一,并附带概率与置信度
多个原子级查询可以针对同一状态并行求值。
Jev能够回答的三类问题及其在评估中的应用
当每次运行中的智能体行为、检索数据或追踪上下文发生变化时,对不同智能体进行比较便十分困难。Deep Agents和LangSmith使我们能够将单次智能体运行记录为数据集,并在各个模型上进行回放。
使用Jev进行评估
为了检验Jev的能力,我们需要一位评分代理。我们利用开源的代理框架Deep Agents构建了一个目标代理,随后将测试集定义为LangSmith数据集,以便每位评估者都能针对相同的问题和预期行为进行评测。测试集由五个天气请求组成:
对于数据集中每个示例,我们捕获了天气代理的响应,并将完整输出作为固定示例存储在 LangSmith 中。每位评审员针对所捕获的五次运行,依据两个指标进行评估:质量——一个连续评分;以及是否通过——一个二元判定。
为将正确性与重复性分开衡量,我们安排了一名人工评审员按照同一评分标准对每条修正后的答案进行打分。以人工评审员的打分作为基准评分,有助于更深入地分析精确度与正确性对整体评估者效能的影响。
准确率衡量与人类评判标准的一致性。方差则用于评估同一裁判在面对相同智能体行为时是否能得出一致的判断。方差越低并不必然意味着准确率越高:裁判仍可能始终作出错误的判断。然而,当法官的判断准确时,更低的方差会使这种准确性在实际应用中更加可靠.
我们对比了Jev与GPT-5.6 Luna、GPT-5.6 Terra以及Claude Sonnet 4.6,通过100次重复计算每例的方差,并评估其与人类专家的一致性。
评估结果
准确率
以人工审核者的标注作为本次比较的参考标准,我们计算了二分类通过/不通过决策的准确率。
对于二元“是否通过”评分,Jev在全部500次重复决策中均与预言机一致。Terra在99.8%的决策中与预言机一致,Luna为96.4%,而Claude为80.0%。
精确率
准确率用于衡量裁判是否与人类评判者的意见一致。精确率则用于考察在代理行为保持不变的情况下,其输出的质量得分是否具有稳定性。我们通过计算每位裁判评分的观测方差来度量精确率。
杰夫的每例均值方差观测值最低,为0.0000149。卢娜高出433倍,泰拉高出913倍,克劳德高出92倍。
这项实验无法说明为何Jev的得分波动更小。一种假设是,这些模型针对不同类型的输出进行了优化。TypeSafe将Jev描述为一种经过训练、能够输出校准概率与类型化答案的决策模型,而自回归语言模型评判器则先生成文本,随后由评估者将该输出映射为评分。这种差异可能使Jev更适合这项有界评估任务,但这一结论仅基于观察,尚不足以证明其训练目标导致了方差的降低。
50%
50%
成本与延迟
低成本意味着大规模开展智能体评估变得切实可行。当评估通话费用高昂时,团队往往需要在覆盖范围与预算之间做出权衡。而在本实验中,每次通话仅需0.00035美元,Jev使这一权衡不再那么严峻。团队能够承受更多次的重复判断,以及更频繁的回归检查。这一点在在线评估中尤为重要,因为每次调用的成本更低,使团队能够在更大比例的生产轨迹上部署更多评估人员,从而生成更密集的反馈信号。
大规模解锁在线评估
对于一个每天生成1万条调用链的生产环境代理而言,所观测到的每次调用成本差异将带来显著的运营效益。
为衡量低成本调用是否具有实用价值,我们定义信号值为二元预言一致性与二元可重复性的乘积。其中,可重复性是指在同一轨迹上进行的两次独立调用给出相同结果的概率。这一指标既奖励那些既准确又稳定的裁判,也惩罚那些持续出错的裁判。
像 Jev 这样信号强、成本低的评估工具,有望为在线评估体系带来更高的价值。团队可以针对更多生产环境中的运行轨迹生成反馈,更早发现质量变化,并在这些反馈趋势出现异常时及时发出预警。
一种新型的智能体评估
如今,每一次智能体评估都面临权衡:增加智能体运行次数、扩展评估维度,或测试更多变更,都会导致测试成本上升。这迫使团队的评估力度低于其期望。
在我们的实验中,一次Jev判断的成本仅为0.00035美元。除了成本低廉之外,Jev还具有高准确性和低方差,这意味着其判断结果可靠且信号强烈。以这样的价格获得高质量的判断,意味着开发者能够针对多个关键指标对每次智能体运行进行评估,量化每一次策略调整,并在需要高度置信度时反复进行判断。
这一点至关重要,因为打造优秀的智能体需要进行大量测试与监控。对智能体的评估频率越高,就越能为开发周期提供更有价值的反馈。
我们仍需验证本实验的结果是否适用于其他智能体和生产工作流。此外,低成本也可能放大错误——如果评估器长期出现偏差,就可能在大规模应用中产生不良反馈。因此,工程师仍需将人工审核与对齐性评估纳入其工作流程。
全新的 System One 风格模型有望让高质量评估更加普及,从而加速整个智能体开发生命周期。智能体工程师能够将更多运行轨迹转化为反馈,更早发现回归问题,并在构建、测试、监控与部署智能体的过程中实现更快的迭代与交付。解锁不仅意味着更便宜的评估,还意味着构建可靠智能体时更加紧密的反馈循环。