Jev到底是什么?
咱们不绕弯子,开门见山,先把大家最关心的几个核心问题一次讲清楚。
Q1:Jev 到底是个什么东西?是哪个大厂出的,还是套壳产品?
它是一个货真价实独立训练出来的闭源基础模型,来自旧金山的创业公司 TypeSafe,刚拿了 4000 万美元种子轮融资。创始人 Diogo Almeida 之前在 OpenAI,是 InstructGPT 论文的作者之一。官方给模型起名 Jev,名字取自经济学家 William Stanley Jevons(提出杰文斯悖论的那位学者)。
Q2:它开源了吗?
完全闭源。官方目前只提供云端 API,根本没有公开模型权重。网上大家看到的各种 GitHub 仓库,都是社区开发者调用它的 API 写的辅助工具和应用 demo。
Q3:它能帮我写代码、写文章、跟我聊天吗?能替代 Claude 或者 ChatGPT 吗?
一个字都不会写。你让它写首诗或者写个排序算法,它直接报错。它压根就不是拿来聊天的,连自由文本生成的接口都没有。
Q4:既然连作文都不会写,为什么全网开发者都在兴奋?
因为大家忽然发现:我们平时让大模型干的事,其实一大半根本不需要它写作文。
做个自动化流程,判断一条新闻要不要进日报;做个客服系统,判断客户是要退款还是问物流;做个 Agent,判断下一步该调哪个工具。这些全都是判断题。以前为了做这道判断题,你得叫动参数几十上百亿的大模型,等它慢吞吞吐两秒钟字,花上几分钱,代码还得写一堆防御逻辑去从它吐出的废话里抠结果。
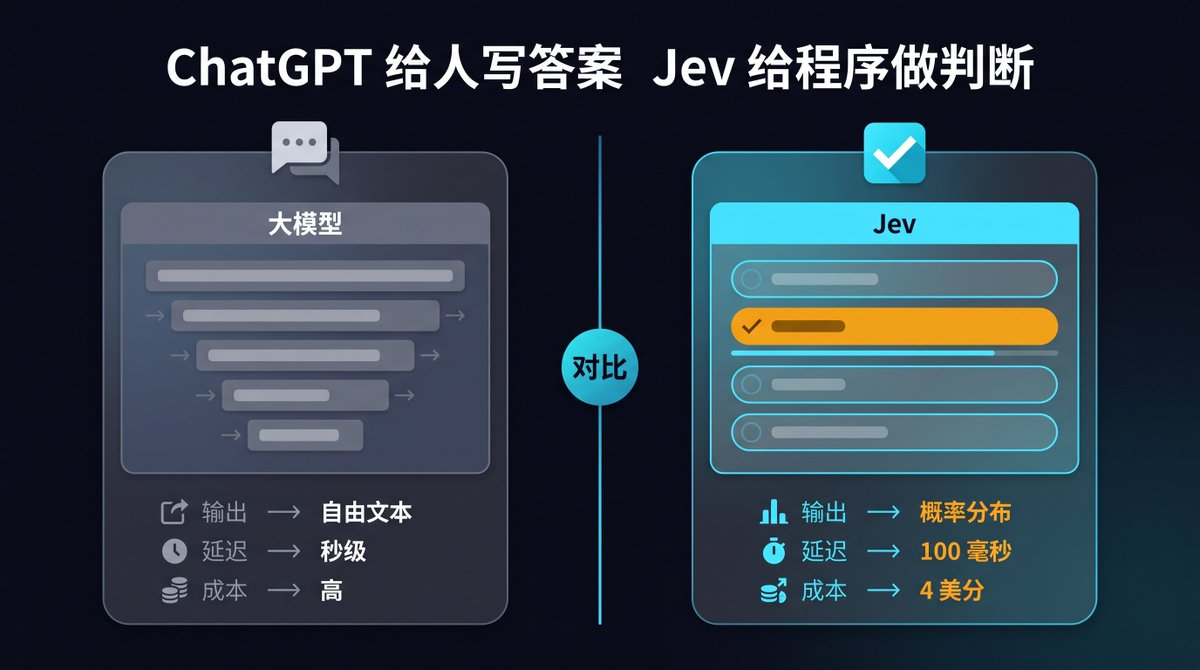
Jev 就是专为这种事情生的:它只做判断题和选择题,100 毫秒出结果,一百万 token 只要 4 美分。
一句话记住它和传统大模型的区别:ChatGPT 给人写答案,Jev 给程序做判断。
一. 它只会做哪三种题
把 Jev 放到平时写代码的场景里,它其实就像个极速答题机,只接受三类题型。
第一种是判断题(官方叫 Noul)。
你给它一段内容,再给一个命题,比如:这段用户留言是不是在骂客服?
它不跟你解释前因后果,直接返回一个布尔概率:比如判定为真的概率是 94%。你的代码拿到这个数字,写个大于 80% 的阈值判断,直接就能走拦截流程。
第二种是选择题(官方叫 Choice)。
你预先设定好选项,最多可以塞 255 个。比如处理工单时,选项只有三种:账单问题、物流延迟、退换货。它会返回每个选项的概率分布,外加一个置信度评分。
最关键的地方在这里:选项是你定死的,它绝不可能在输出格式里凭空编造出第四个不存在的类别。 你的程序拿到结果直接进 switch-case,再也不用担心 JSON 格式解析失败。
第三种是打分题(官方叫 Score)。
在你定义好的有序等级上打分,比如给客户怒气值打 1 到 5 分,它返回整个分数的分布。
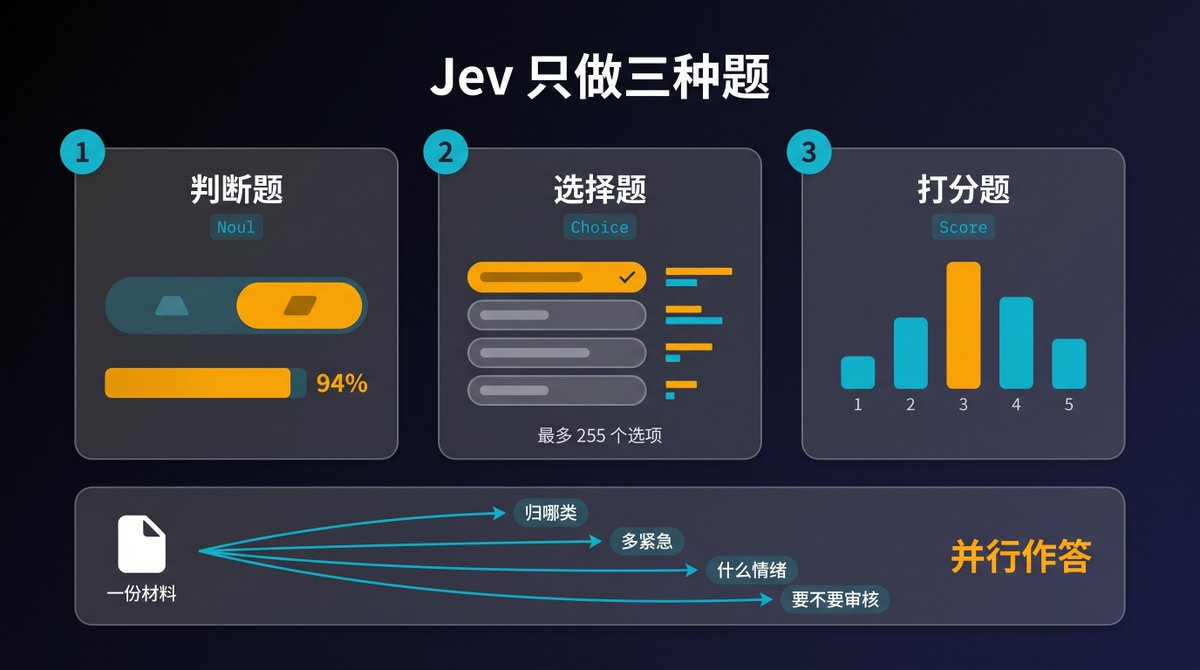
而且它还有一个很狠的机制:读一次材料,同时答多道题。
给它同一张工单的文本,你可以同时问它:归哪类、多紧急、客户情绪如何、要不要主管审核。Jev 只读一遍这段材料,四道题并行求值,几百毫秒全部答完交卷。
二. 这套技术路径真的可行吗?
很多人第一反应会怀疑:只做选择题的模型,到底靠不靠谱?是不是一种营销噱头?
如果从计算机底层和认知科学来看,这条路不仅可行,而且是非常符合工程逻辑的解法。
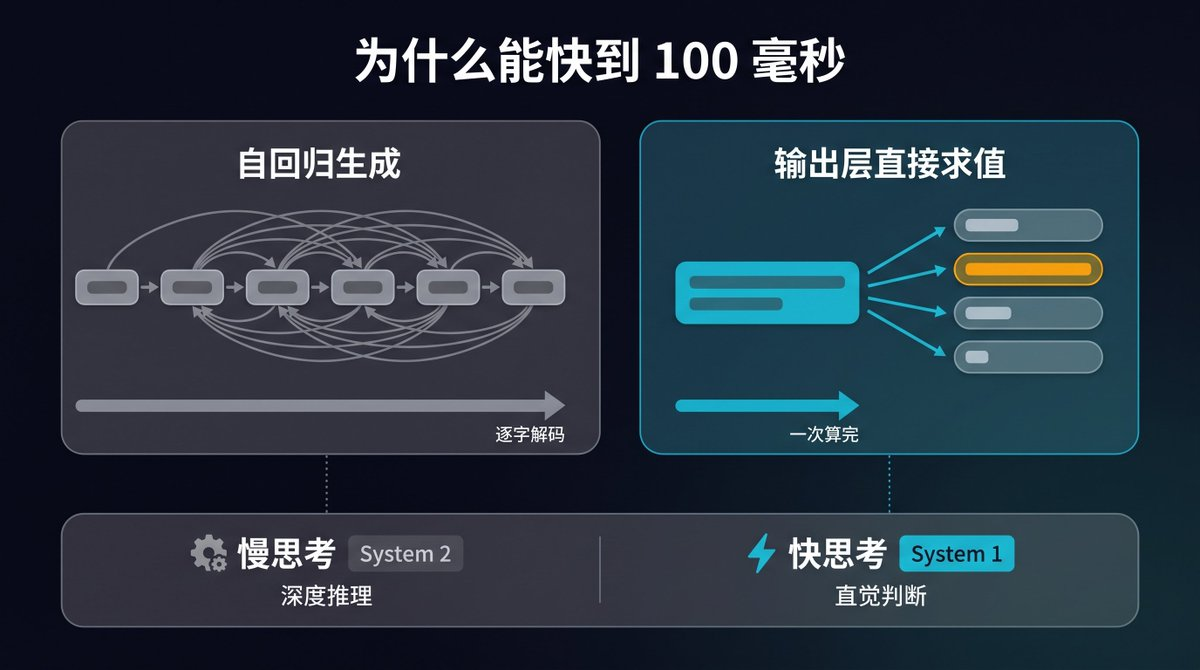
大模型之所以贵且慢,是因为它们采用的是自回归生成。每吐出一个字,模型都要把前面的全部内容在注意力机制里算一遍,就像一个人写作文,每写一个词都要停下来琢磨下一个词。这种机制赋予了大模型极强的创作能力,但拿来做是非判断,就像开着重型卡车去路口买一瓶水。
Jev 的逻辑完全反了过来。它不生成任意文本,而是把输出空间死死限制在开发者给定的几个槽位里。因为不需要像织毛衣一样逐字解码,它直接在模型的输出层一次性计算各个选项的概率分布,推理时间自然能被压缩到 70 到 500 毫秒之间,大多数时候都在 100 毫秒上下。
更核心的突破在于概率校准。
官方把这套训练方法叫做 RLCD(强化学习校准决策)。以前的小型分类模型虽然快,但经常蜜汁自信,明明猜错了也标着 99% 的置信度。Jev 的目标是让它像靠谱的天气预报一样:它给出 80% 把握的时候,在统计上一百次里确实大概对 80 次。这样工程师就可以在代码里放心地写策略分流:95% 置信度自动放行,60% 置信度交给人工复查。
当然,也要说明白:官方宣称的快 40 到 200 倍、便宜 400 倍,来自他们自建的工作流评测,参考答案也是拿外部大模型平均值对出来的。这属于最佳工况下的收益,但即使抛开这些宣传数字,它在工程架构上的合理性依然很立得住。
三. 现在的开发者,都拿它做了些什么?
Jev 刚发布几天,社区和各大平台就已经搞出了不少有意思的应用,远远不止简单的文本分类。
极速浏览器 Agent(Browser Use 社区)
Browser Use 社区这周刚开源了一个叫 Jev Ultrafast 的浏览器 Agent。以前让 AI 操作网页,每到一个新页面,大模型都要看半天 DOM、想两秒钟、再决定点哪,慢得像幻灯片。
现在他们把工作拆成两层:Jev 专门负责选按钮、选输入框,因为它面对的其实就是几十个元素里的单选题,几十毫秒就能决定点哪;只有当遇到要打字输入复杂的搜索词时,才叫一下小型文本生成模型。在实测中,它完成一次从苏黎世搜索到伦敦航班的全流程,只花了 7.1 秒,流畅得像写好的自动化脚本。
实时游戏决策(官方打 Doom 毁灭战士 Demo)
TypeSafe 官方做了一个让 Jev 玩经典射击游戏 Doom 的演示。输入不是游戏画面,而是解析好的结构化游戏状态(比如血量、敌人方位、剩余弹药)。Jev 每秒进行大约 10 次实时判断,快速决定走位和开火。连续玩一小时,成本大概只有 7 美元。这种每秒十次的高频连续决策,换成传统大模型,延迟根本跟不上游戏画面,账单也会直接起飞。
Agent 路由与工具选择(LangChain 官方集成)
LangChain 在发布第二天就火速推出了 TypeSafeClassifier。在复杂的 Multi-Agent 架构里,以前每走一步都要问大模型:下一步调用哪个工具?要不要退出循环? 这些原本耗费大量等待时间的控制流判断,现在直接交给 Jev 做极速路由,把 Agent 内部空转的耗时压缩到了极致。
实时安全守门员与输出裁判(Vercel AI SDK)
Vercel 在 AI Gateway 里第一时间支持了 Jev,并在 AI SDK 7 的 evaluate 函数里做了集成。开发者拿它当AI 裁判:大模型刚生成完一段内容,或者用户刚发来一段提问,Jev 可以在几十毫秒内完成合规审核、事实一致性打分或者情感倾向分析,再也不用为了审核一段话去重新调用一次昂贵的 GPT-4o。
复杂选项的两阶段竞速(Wikiracing 维基词条跳转)
Jev 的单次选择上限是 255 个选项。如果候选词条有上千个怎么办?社区跑出了两阶段策略:先用打分(Score)并行扫一遍所有候选做粗筛,再把前几十个送进选择(Choice)做精选。维基百科的词条竞速跳转,用这种方式几百毫秒就能完成一次高基数决策。
写在最后
这两年大家习惯了看百亿千亿参数的巨无霸模型在发布会上秀肌肉,看谁能写更长的小说、谁能写更复杂的全栈项目。
Jev 带来的启发,反而是让我们往后退了一步:在真实的软件工程里,计算机之间交互,真的每一步都需要长篇大论的自然语言吗?
大多数时候,程序要的不过是一个干净、极速、带着把握程度的布尔值或者枚举项。把大模型从沉重的造句任务里抽离出来,给系统装上一枚枚能毫秒级响应的智能 if 语句,这或许才是更多自动化流程能真正低成本跑起来的开始。