Jev工程:如何用10个步骤打造最快的AI智能体大脑
你所构建的每一个智能体都面临同样的问题:一个每次通话成本仅为0.03美元的大语言模型,始终在循环中回答“是”或“否”的问题、挑选下一位客服人员,并对相关性进行打分。那些决策无需生成,它们需要的是一个专为决策而构建的模型。这就是一套包含10个步骤的配置方案,能为您的智能体配备专属的决策大脑。
Split - 找到决策,而非文本
Jev 是 TypeSafe AI 的 System One 模型。您提供相关信息和预设问题,它会返回带有置信度的类型化答案。但它无法撰写您的简报、生成代码,也无法以文字形式解释其推理过程。
先从这样一项工作开始:
代码块
Python
Research three new AI-agent tools and draft tomorrow's briefing. Save
the draft for my review.
这项工作包含多项决策:我们是否有足够的资源?下一个该由哪位员工执行?草案是否已准备好供审阅?
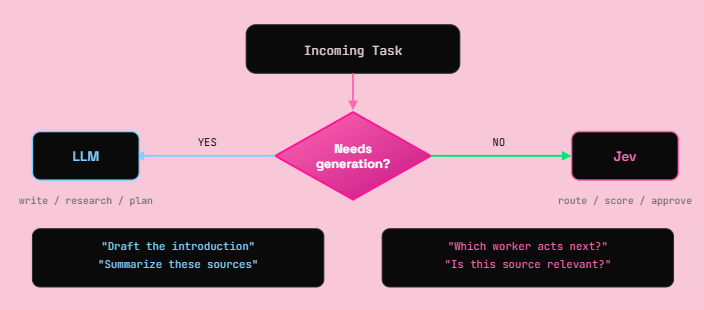
这些都属于Jev的候选任务。获取来源、撰写段落和保存文件仍应由您的工具与生成模型来完成。而诸如“执行十次操作后停止”之类的明确规则,则应当写入代码中。
拆分很简单。如果该操作生成文本,则保留在LLM中;如果该操作从列表中选择一个选项、为某个值打分,或回答“是/否”,则转交给Jev。
Playground - 先测试一个问题再写代码
打开TypeSafe Playground。如果您的账户需要,请登录并完成访问流程。
以此作为您的状态,并添加一个问题:“下一个该由哪位工作人员执行?”
代码块
Python
{
"goal": "Compare three AI-agent tools in a morning briefing.",
"completed_work": "No sources collected yet.",
"available_workers": ["Researcher", "Writer"],
"constraint": "Save drafts for review. Do not publish."
}
确定三个选项:
•
研究以补充缺失的证据,
•
撰写以充分证据为基础的草稿
•
审阅以应对不明确的需求或已完成的工作。
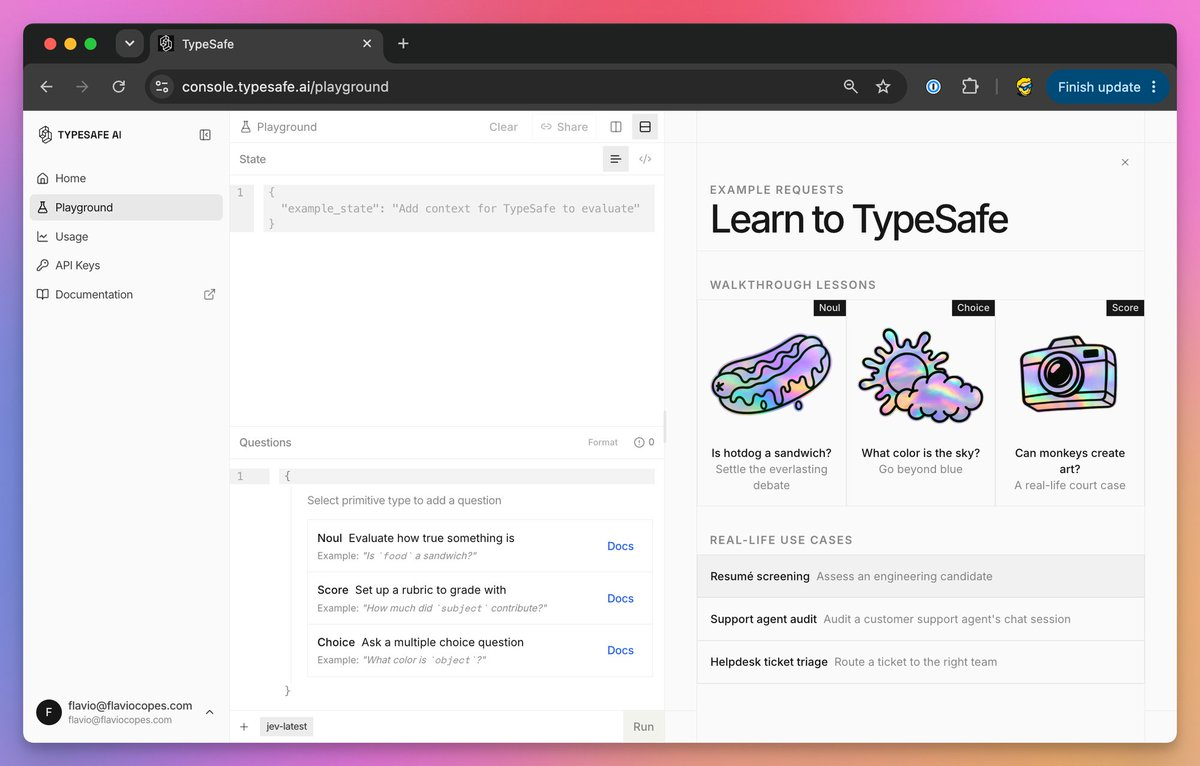
运行它。然后用实际的研究笔记替换已完成工作的字段,并对比决策结果。这正是官方快速入门中所描述的基本交互流程。
SDK - 安装并连接API
您需要一个已启用API访问权限的TypeSafe账户,并从密钥设置中获取密钥。API调用费用将计入该账户。
安装 Python 3.12 或更高版本,然后打开终端。
代码块
Python
$ mkdir jev-starter
$ cd jev-starter
$ python3 -m venv .venv
$ .venv/bin/python -m pip install --upgrade typesafe-sdk
代码块
Python
> mkdir jev-starter
> cd jev-starter
> py -3 -m venv .venv
> .\.venv\Scripts\python.exe -m pip install --upgrade typesafe-sdk
在安装好 Node.js/npm 后,添加 TypeSafe 的官方技能:
代码块
Python
npx skills add typesafe-ai/skills --skill typesafe-ai
系统提示时,请选择您支持的客服机器人。该技能会提供集成说明,而 Jev 本身则通过 API 运行。
交接——将决策保存为本地 JSON 队列
在 jev-starter 中、.venv 之外创建 chief.py。这是一个独立的决策路由器:输入一项任务,让 Jev 选择其目标位置,并将交接信息保存在您的电脑上。
代码块
Python
import json
import os
from getpass import getpass
from pathlib import Path
代码块
Python
$ .venv/bin/python chief.py
请打开那个 JSON 文件。其中包含您的请求、进度、Jev 的选择、置信度以及目标地址。每次运行都会在 queue/research、queue/write 或 queue/review 目录下生成一个新文件。
这些是本地任务队列。已保存的作业会等待工作者将其消费。
置信度阈值已设置为0.85。请根据工作流中的标注样本进行调整。置信度并非准确率百分比\
问题——选项、分数与Noul
Jev为您提供三种问题类型,每种类型都针对不同类型的决策而设计:
一个有用的细节:Jev 看不到您的问题 ID。为字段命名为 safe_to_publish 并不会提供任何指导。请在问题中明确写出实际需求,并对每个选项进行清晰说明。
同时请提供证据。“研究人员已完成”这一表述向Jev传递的信息,不及来源、研究发现及尚存的空白所传达的丰富程度。请将这些字段与原始请求分开填写
System One 模型会并行评估请求中的每一个问题。增加问题几乎不会影响响应时间,且仅需支付额外问题的令牌费用。
动态菜单——每回合重新构建选项
每次点击后,浏览器的可用操作都会发生变化。Browser Use 会根据已观察到的控件生成一份新的列表,并让 Jev 从中进行选择。当需要填写输入框时,小型 LLM 才会生成文本。
将该设计应用于您的幕僚长。基于现有且可获取的员工选项进行构建。在选择研究资料时,请纳入当前的来源ID。
在工具更改状态后,请刷新选项。否则,您的决策模型将基于昨日的菜单进行选择。
并行——一次调用处理批量问题
您的调度员可能需要一名工作人员、一个紧急程度评分以及一项审批检查。如果这三者都能检查同一状态,请将它们一并发送。
TypeSafe 支持并行提问与推测分支:先询问可能的下一步行动,然后仅使用与所选分支相关的答案。
问题之间无法互相查看答案。如果某项决策需要新的搜索结果,请先执行搜索。
代码块
Python
result = client.system_one(
state=state,
questions={
"next_worker": Choice(
instructions="Choose the next step.",
criteria={...}
),
"urgency": Score(
instructions="Rate request urgency.",
labels=["low", "medium", "high", "critical"]
),
"safe_to_run": Noul(
instructions="The requested action is safe to execute without human review."
),
},
)
浏览器使用示例揭示了另一个性能瓶颈。其优化后的运行时将浏览器协议调用的中位数从1,092次降至101次,同时在三组匹配样本中,任务执行时间的中位数也下降了25%。两个版本均采用了相同的模型。
这些改动包括一次性读取页面状态,并避免对不相关的动画进行重新预测。在为更快速的模型付费之前,请先检查重复的工具调用。
防护栏——设置限制与停止条件
对于晨会简报,允许进行来源收集与草稿创建,随后在审核环节停止。发布操作应另行进行权限校验。
该应用程序还需设置操作次数上限、支出上限,并保存已执行的进度。在中断后,它应在重新执行任何操作之前检查上次已完成的操作。即使给出了确定的答案,也无法证明文件已被保存或消息已被发送。
浏览器会独立检查在Jev选择“完成”后的结果。请将这种分离机制用于您自己的完成状态检查。
代码块
Python
AGENT HANDOFF BRIEF
Read the TypeSafe skill and inspect my worker interfaces. Connect
chief.py's JSON queues to existing research and writing handlers.
Prevent duplicate processing. Save progress after each action. Add
如果启动程序失败,请根据错误信息选择解决方案:
深度解析 // JEV 背带
智能体以循环方式运行:由大语言模型决定行动方案,工具执行相应操作,模型对结果进行评估,循环持续进行,直至任务完成。两项基本机制使这一过程更加便捷:通过工具调用来实现结构化请求,以及通过结构化输出来获得结构化的结果。
但即使有了这些机制,该循环中的每一个决策仍然需要进行一次完整的模型调用。
这正是为什么工具链比模型本身更重要的原因。
同样是同一款型号,背带设计的差异让性能从78%提升到42%。重量相同,但环扣结构不同。背带的设计决定了最终的性能表现。
像Codex和Cursor这样的编码辅助工具,都已经推出了某种机制,能够在危险操作被执行之前对其进行分类。
这一分类器步骤已逐步帮助建立人们对智能体的信任。此前,它一直被封闭在该框架的专有组件中。
既然已经存在一种廉价且高效的分类器模型,你就可以沿用同样的模式,并将其应用于所有智能体。
相同的模型。相同的工具。不同的实验环境。不同的结果。
LangChain 的 AutoModeMiddleware 在工具执行前,利用 Jev 对每一次工具调用进行风险决策检查。仅需一行中间件代码,安全检查过程中不消耗任何生成令牌。
代码块
Python
from langchain.agents import create_agent
from langchain_typesafe.experimental.middleware import (
AutoModeMiddleware,
)
# Jev checks every tool call before execution
该框架为您提供了两层 Jev 保护。顶部的模型路由器会挑选出能够处理该请求且成本最低的模型;底部的自动模式门控则会在危险的工具调用执行之前将其拦截。
费用——每百万0.042美元能买什么
Jev 1.13 的输入token费用为每百万个0.042美元,无输出token费用。按每次决策消耗1,000个计费输入token计算,1万次决策的Jev推理费用为0.42美元。
飞行演示报告的0.0039美元费用,与其记录的90,558个Jev输入token以及文本助手报告的收费相符。浏览器费用不计入该计算。其约七秒的计时从首次页面观测后开始,并且不包括运行后的再次验证。
它能查询航班信息,但不提供机票预订服务。
在另一项工作负载下,Vercel的fx团队报告称,其安全分类速度比GPT-5.6-Luna快约5至18倍,同时准确率也有所提升。
该比较针对的是分类器,而非整个智能体运行的时长。
按已完成的任务跟踪费用。一个代价低廉的决策,却可能让员工误入歧途,其成本甚至超过决策本身。
部署 - 五个生产用例
完成基本设置后,Jev已经能够读取任务的状态,并在预定义的选项中进行选择。现在您只需决定将哪个重复性决策实现自动化。
控制浏览器
浏览器使用 Jev 来选择下一步操作和正确的页面元素。该客服在 7 秒内以 0.0039 美元的价格找到了航班。
重复方法:
运行官方的浏览器使用项目,添加您的 TypeSafe 和 OpenRouter 密钥,然后为智能体指定一个网站和一个目标。Jev 会自动选择操作和目标,浏览器则负责执行该决策。
研究分类:
哈桑使用Jev对1,018篇人工智能研究论文进行了分类。整个分类过程仅花费0.08美元,每篇论文的端到端平均延迟为256毫秒。
如何重复:
将每篇论文的标题和摘要发送给Jev,然后将你的选题定义为选项。保存选定的类别,并将最优秀的论文发送给你的写作代理。
对收件箱进行分级处理:
莱利·布朗演示了Jev如何对收到的电子邮件进行分类,并决定下一步该如何处理。3.5美分即可完成500封邮件的分类。
如何重复:
将每封邮件作为状态,然后将回复、调研、等待和审核作为选项。将每个答案与相应的文件夹或邮件代理关联起来。
在模型之间路由任务:
LangChain 使用 Jev 根据任务选择更经济实惠且性能更强的模型。简单任务交由快速模型处理,复杂任务则交由推理模型处理。
代码块
Python
from langchain.agents import create_agent
from langchain_typesafe.experimental.middleware import (
ModelChoice, ModelRouterMiddleware,
)
router = ModelRouterMiddleware(
choices={
"fast": ModelChoice(
model="openai:luna",
criteria="Direct lookups, extraction, localized changes.",
),
"powerful": ModelChoice(
model="openai:sol",
criteria="Architecture and high-stakes decisions.",
),
},
instructions="Choose the least costly model that can complete the task.",
即时上下文压缩
塔玛拉找到了完美的应用场景:即时压缩。到了2026年,为什么压缩仍然是一个汇总提示?杰夫可以通过对每一次工具调用进行打分,并舍弃无关内容,让这一过程变得即时。
亚历克斯·沃尔科夫进行了测试:将一个近100万令牌的Claude会话压缩至8.6万令牌仅需1秒。这并非一次摘要生成,而是在Jev速度下的相关性过滤
结论:
Jev并非又一个聊天机器人。它是一个快速的决策层,能够读取您系统的当前状态,并在您所定义的选项中做出选择。
而真正的核心价值并不在于那7秒的飞行演示,也不在于0.08美元的纸张分类任务。
真正的超额收益在于意识到,你的智能体内部有多少昂贵的大型语言模型调用其实根本无需生成:
让大型语言模型进行研究、规划并撰写内容。
让Jev负责路由、评分、审批或升级处理。
让代码执行决策。
这种拆分会改变整个智能体的架构。
您现在已经完成了部署,拥有了可用的决策路由器,并且掌握了四种切实可行的部署方式。不妨从一个重复出现的决策开始,对其进行衡量,然后再替换下一个决策。
大多数建造者都会持续将前沿模型代币花在每一个是、否、路线和得分上。