模型路由(Model Routing):如何根据任务复杂度选择模型?
难度:中级 分类:Production & Deployment
简短回答
模型路由(Model Routing)是在运行时根据每个请求的特征(复杂度、类型、延迟要求、成本约束)动态选择最合适的 LLM 的技术。核心思想:不用一个模型处理所有任务——简单问答用 GPT-4o-mini($0.15/M token),复杂推理用 GPT-4o($2.50/M),极难问题用 o3($10/M)。ICLR 2025 发表的 RouteLLM 证明:通过智能路由可以仅使用 26% 的 GPT-4 调用就达到 95% 的 GPT-4 质量,成本削减约 85%。主要路由策略:(1) 基于规则——关键词/长度/类别匹配(最简单);(2) 分类器路由——训练小模型判断复杂度(RouteLLM 方法);(3) 语义路由——基于查询的向量相似度匹配最佳模型(Red Hat LLM Semantic Router);(4) 级联路由——先用小模型尝试,不确定时升级到大模型。2026 年调查显示 37% 的企业在生产中使用 5+ 个模型,智能路由已从"优化手段"变为"必备基础设施"。主流工具:RouteLLM、LiteLLM、Portkey、Azure Model Router、OpenRouter。
详细解析
为什么需要模型路由
代码块
Plain Text
问题:所有请求都用同一个模型
├── 用最强模型(如 GPT-4o)→ 成本高,简单任务浪费
├── 用最便宜模型(如 GPT-4o-mini)→ 复杂任务质量差
└── 手动选择 → 不可扩展,需要领域知识
解决:智能路由
├── 自动判断每个请求的复杂度
├── 路由到"刚好够用"的模型
├── 平衡质量、成本和延迟
└── 结果:85% 成本削减 + 95% 质量保持
四种路由策略
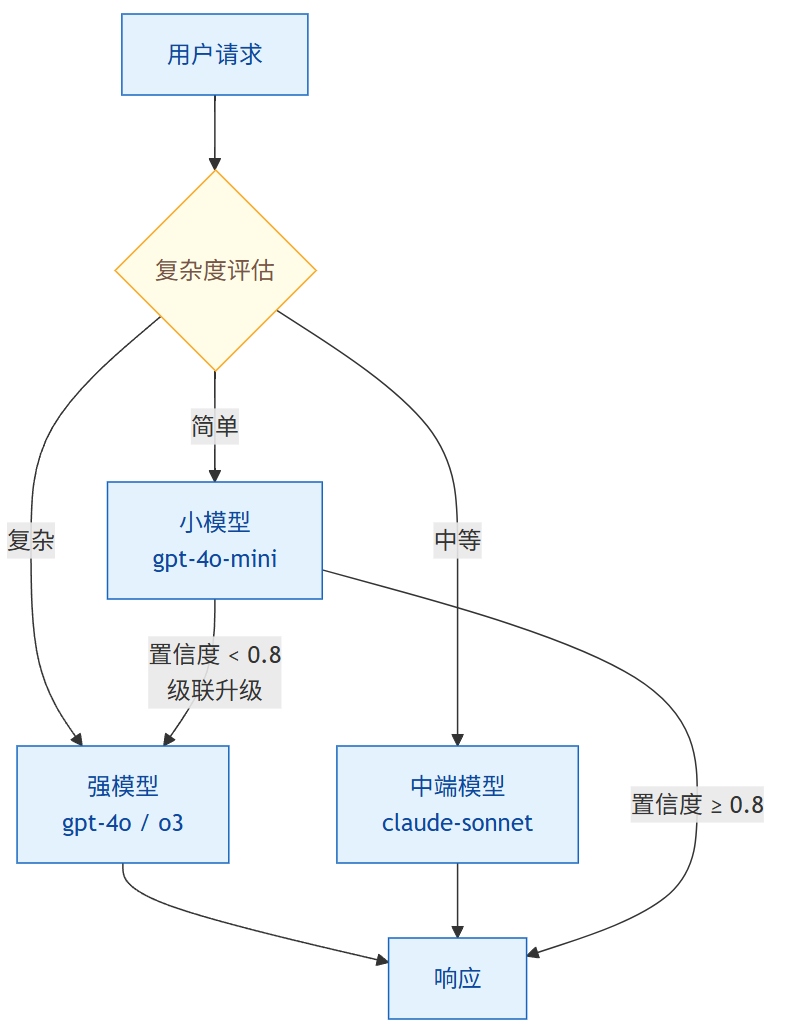
路由让每个请求用"刚好够用"的模型:26% 强模型调用保住 95% 质量、砍 85% 成本;级联变体则先试小模型,置信度不足再升级。
代码块
Python
# 策略 1:基于规则的路由(最简单,立即可用)
class RuleBasedRouter:
"""基于预定义规则路由"""
def route(self, query):
# 按任务类型
if query.task_type == "translation":
return "gpt-4o-mini" # 翻译用小模型即可
if query.task_type == "code_generation":
return "claude-sonnet-4-5" # 代码生成用中端模型
多维度路由决策
代码块
Python
class MultiDimensionalRouter:
"""综合考虑多个维度的路由决策"""
路由工具生态
常见误区 / 面试追问
误区:"路由器本身的开销会抵消收益" — 分类器路由(如 RouteLLM 的矩阵分解模型)推理时间 < 10ms,成本几乎为零。相比于将简单请求从 $2.50/M 路由到 $0.15/M 的节省,路由器开销微不足道。
误区:"两个模型就够了(强+弱)" — 实际生产系统通常需要 3-5 个模型:最轻量(FAQ/简单任务)→ 中端(一般任务)→ 高端(复杂推理)→ 特化模型(代码/数学/创意)。37% 的企业在 2026 年使用 5+ 个模型。
追问:"如何评估路由器的效果?" — 两个核心指标:(1) 质量保持率——路由后的整体质量 vs 全部使用强模型的质量(目标 > 95%);(2) 成本削减率——路由后的总成本 vs 全部使用强模型的成本(目标 > 50%)。同时监控各模型的实际调用比例和各自的质量指标。
追问:"路由器会不会过时?更强的模型会不会让路由不再需要?" — 不会。即使最强的模型变得很便宜,不同模型在不同任务上仍有各自优势(速度、专业性、上下文长度)。而且新的强模型出来后,旧的模型变成"弱模型",路由的价值持续存在。这是一个结构性需求。