什么是 12-Factor Agents?如何用它评审生产级 Agent?
难度:中级 分类:生产部署
简短回答
12-Factor Agents 是 HumanLayer 创始人 Dex Horthy 于 2025 年提出的一套「生产级 LLM 应用设计原则」,直接致敬 2011 年 Heroku 团队的经典 12-Factor App。项目开源在 humanlayer/12-factor-agents,目前在 GitHub 收获约 2.4 万 star,是 Agent 工程化领域传播最广的方法论文档之一。它的核心论断是:真正能在生产环境交付给客户的 "AI Agent",绝大多数并不是「给个 prompt + 一袋工具 + 死循环到目标」的魔幻自治体,而是「以 LLM 决策为节点、以确定性代码为边」的软件系统。
这套方法论回答一个工程问题:怎样构建「好到可以交付给生产客户」的 LLM 驱动软件? 作者调研了上百位 SaaS 创业者后发现一条高度一致的路径——抓一个框架快速冲到 70~80% 质量分 → 发现 80% 对面向客户的功能远远不够 → 想突破必须逆向工程框架的 prompt/流程/状态 → 最终推倒重写。12-Factor Agents 的立论正是:与其 all-in 某个框架,不如把 Agent 的核心能力拆成 12 条可独立采纳的模块化原则,融进你现有的产品代码里。
12 条原则可以浓缩为一句话:把 Agent 当作「LLM 决定下一步 + 确定性代码执行 + 结果回灌上下文」的循环,并把这个循环里的每一个关键环节(prompt、上下文、状态、控制流、错误、人工介入)都显式地「收归己有」。它既是一份反模式清单,也是一张可逐条打勾的生产化评审表。面试中它常作为「你怎么评审一个 Agent 架构」的标准答案出现。
详细解析
核心理念:Agent 本质上是一个「确定性外壳 + LLM 决策内核」的循环
12-Factor Agents 的起点是对「Agent 是什么」的重新定义。作者指出,业界宣传的 Agent 往往是「丢掉 DAG(有向无环图),让 LLM 实时决定路径」的乌托邦;但真正跑通的 Agent,骨子里是一个稳定的循环:
代码块
Python
# 12-Factor Agents 的「最小 Agent 循环」(来自官方 README)
initial_event = {"message": "..."}
context = [initial_event]
while True:
# 1. LLM 根据当前上下文,决定下一步(输出结构化的 tool call)
next_step = await llm.determine_next_step(context)
context.append(next_step)
# 2. 如果 LLM 认为做完了,返回最终答案
if next_step.intent == "done":
return next_step.final_answer
# 3. 确定性代码执行这一步,把结果追加进上下文
result = await execute_step(next_step)
context.append(result)
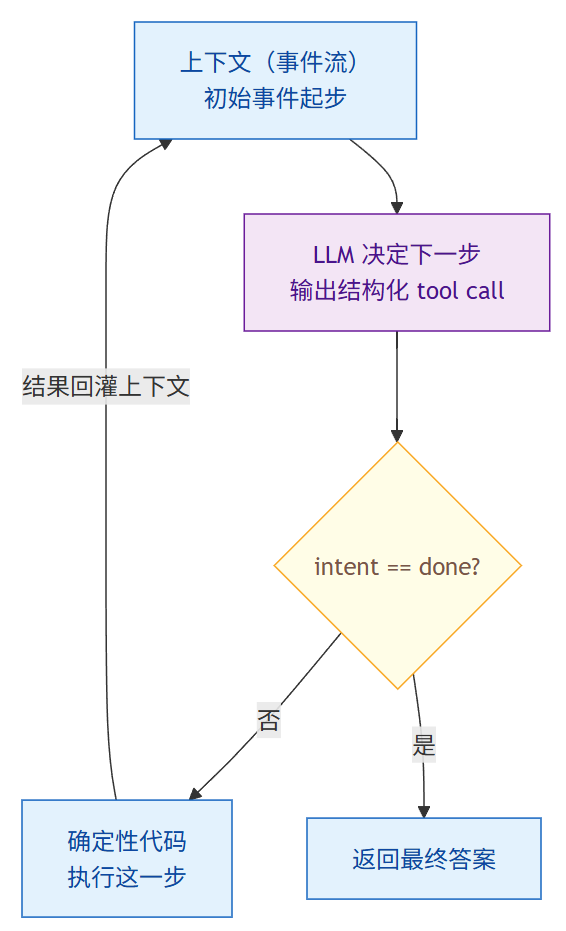
Agent = 确定性外壳 + LLM 决策内核:LLM 定下一步、代码执行、结果回灌上下文,12 条原则都在加固这个循环。
这个循环里只有三件事:LLM 决定下一步 → 代码执行 → 结果进上下文 → 重复。12 条原则中的每一条,都是在加固这个循环的某一个面——让 prompt 可控、让上下文可管、让状态可恢复、让错误可自愈、让人工可介入。理解了这个循环,就理解了 12-Factor Agents 的全部锚点。
12 条原则逐条解读
下表先给出全景,随后对易误解的几条展开说明。
附录还有一条「Factor 13: Pre-fetch all the context you might need」(预先抓取所有可能需要的上下文),作为荣誉条目,强调在 LLM 决策前由确定性代码先把上下文备齐,而不是让 LLM 边走边找。
几条容易踩坑的原则展开说明:
•
Factor 5(统一状态) 是 12 条里工程含量最高的一条。它的核心是:不要让「loop 当前进度」这种执行态只活在内存变量里,而业务结果活在数据库里——两者一旦分离,进程崩溃就无法恢复。正确做法是把所有发生的事(用户消息、LLM 的 tool call、工具结果、人工审批)都作为**事件(event)**追加到同一条 thread 里,状态就是事件的折叠结果。这样「恢复」等价于「重新 replay 这条事件流」。
•
Factor 7(人工作为工具) 与 Factor 8 是孪生兄弟。作者反复强调他「对每个 Agent 框架的头号需求」就是:能在工具被「选中」和「被执行」之间插入一个暂停点,让人审核。没有这个粒度,你就只能在「只让 Agent 做只读研究」和「给它高危权限然后祈祷」之间二选一。
•
Factor 12(无状态 reducer) 听起来玄,本质就是把 Agent 写成纯函数:new_state = agent(events_so_far, new_event)。任何一个时刻,只要把事件流喂进去,就能还原出与原运行完全一致的 Agent 状态。这让 Agent 天然可重放、可恢复、可水平扩展——这也是「stateless reducer」这个名字直接借用前端 Redux/Array.reduce 范式的原因。
反模式 → 原则对照表
把 12 条反过来读,就是一份「Agent 翻车常见姿势」清单。下面给出工程实践中最常见的反模式及其对应原则:
与经典 12-Factor App 的呼应与差异
12-Factor Agents 刻意沿用了「12 条」的形式与命名,但两者的关注层完全不同:12-Factor App(2011)面向 SaaS 云原生时代的部署与可移植性(代码库、依赖、配置、后端服务、并发、日志),而 12-Factor Agents(2025)面向 LLM 时代的应用内循环设计(prompt、上下文、状态、控制流)。可以这样对应理解:
表格加载中...
差异同样关键:原版 12-Factor App 不关心业务逻辑长什么样,它假设你写的是普通确定性代码;而 12-Factor Agents 专门处理 LLM 引入的非确定性——如何约束 LLM 的输出(F4)、如何在它跑偏时纠错(F8/F9)、如何在它「失忆」前缩小任务范围(F10)。可以认为:12-Factor App 解决「软件怎么上云」,12-Factor Agents 解决「带 LLM 的软件怎么上生产」,两者是互补而非替代关系。
落地方法:用 12 条评审自己的 Agent 架构
面试中如果被问「你会怎么评审一个 Agent 架构」,12 条本身就是现成的 checklist。下面给出一个可操作的评审流程,先看整体评审链路图:
代码块
Plain Text
对应的最小可运行骨架(伪代码,体现 F1/F4/F5/F8/F9 几条核心原则):
代码块
Python
from pydantic import BaseModel
from typing import Literal, Union
# ── F4: Tools as Structured Outputs ──
# 把「下一步」定义成带 schema 的结构化输出,而非自由文本
class Done(BaseModel):
intent: Literal["done"]
final_answer: str
class DeployBackend(BaseModel):
intent: Literal["deploy_backend"]
tag: str
env: Literal["staging", "production"]
class RequestApproval(BaseModel):
intent: Literal["request_approval"]
读这段骨架时把它对着 12 条逐行标注:prompt 你自己写(F2)、输出有 Pydantic schema(F4)、状态全在 thread 事件流里(F5)、审批会落盘后暂停而非阻塞(F6/F7/F8)、错误会压缩回灌并计数熔断(F9)、整个 thread 可重放(F12)——这就是「评审通过」的样子。
常见误区 / 面试追问
误区:「12 条必须全部遵守,少一条就不算生产级」 — 这是最大的误读。作者明确说这些原则「可以独立采纳」,你可以只取其中一条(例如只做 F9 错误压缩)而不做其他 11 条。它的定位是菜单而非教条。正确的理解是:把它当 checklist 逐条自检「我有没有刻意思考过这一面」,而不是追求集齐 12 个徽章。
误区:「12-Factor Agents 是反框架的,用了 LangGraph 就违背它」 — 不准确。作者的态度是「框架能帮你拿到大多数原则,但一旦需要深度控制就会成为负担」。事实上 LangGraph 1.0 GA 后的 per-node 超时、checkpointing、interrupt-before 等特性,恰好分别对应了 F6(暂停恢复)、F5(状态持久化)、F7/F8(在节点执行前插入人工审批)。问题不是「能不能用框架」,而是「框架的黑盒你是否逆向得动」。自研 vs 框架的差异在于:自研天然满足全部 12 条(因为循环你自己写),框架则满足其中大部分但可能对 F2(prompt 透明)和 F8(控制流)做了封装,需要你额外花力气「打开」。
追问:「12 条里优先级最高的是哪几条?」 — 如果只能选三条,工程界共识倾向 F5(统一状态)+ F8(自控控制流)+ F10(小而专注)。F5 决定了 Agent 能不能从崩溃中恢复,F8 决定了你能不能在关键步骤插审批和熔断,F10 决定了上下文会不会爆炸。F1/F4 是基础前提(没有结构化输出谈不上生产化),而 F11/F12 更多是规模化后的优化项。面试时给出带排序的理由,比背诵 12 条更有说服力。
追问:「Factor 10 说 Agent 要小,那 LLM 变强后这条不就过时了?」 — 作者专门回答过这个问题,结论是:即使 LLM 能跑 100 步,保持小而专注依然是更优策略。原因是确定性代码比 LLM 决策便宜、可靠、可测试几个数量级,把能确定化的部分留在 DAG 里、只把真正需要灵活判断的环节交给 Agent,永远比「全塞给一个大 Agent」更经济。随着模型能力提升,单个 Agent 的 scope 可以「慢慢长大」,但「刻意控制规模」的工程纪律不会消失——这与大型代码库重构的直觉一致。
追问:「12-Factor Agents 和 MCP / A2A 是什么关系?」 — 正交且互补。MCP(Model Context Protocol)解决的是「Agent 怎么发现和调用工具」,对应 F4 中「工具作为结构化输出」的工具侧标准化;A2A 解决的是「Agent 之间怎么通信」,对应 F10/F11 的多 Agent 编排与触发。12-Factor Agents 不规定你用哪种工具协议,但 F1/F4/F8 会约束你「无论用什么协议,工具调用必须是结构化的、控制流必须在你手里」。作者在 README 里也半开玩笑地说「我不会专门讨论 MCP,但你应该看得出它插在哪里」。