场景题:你的 Agent 在生产环境出了故障,如何系统性排查和修复?
难度:高级 分类:Production & Deployment
简短回答
Agent 生产环境故障排查需要建立系统性的可观测性体系,核心方法论是"Trace 驱动排查"——从 Trace ID 出发,逐步还原 Agent 每一步的决策路径、工具调用和上下文状态。排查流程遵循 OODA 循环(Observe → Orient → Decide → Act):先通过 Metrics 告警发现异常,再通过 Distributed Tracing 定位到具体 step,然后分析 LLM Input/Output 和 Tool Response 找到根因,最后制定修复方案并验证。关键原则是不要猜测,要用数据说话——每个故障都必须有对应的 Trace 证据。常见的 Agent 生产故障包括无限循环、幻觉输出、工具超时、权限越界和模型版本漂移,每类故障都有特定的排查模式和防御性修复策略。修复后必须进行 Post-Mortem,将故障模式沉淀为自动化检测规则,防止同类问题复发。
详细解析
Agent 生产故障的特殊性
与传统软件不同,Agent 故障具有非确定性——同样的输入可能产生不同的执行路径。这使得排查必须依赖完整的 Trace 记录而非简单的日志回放。
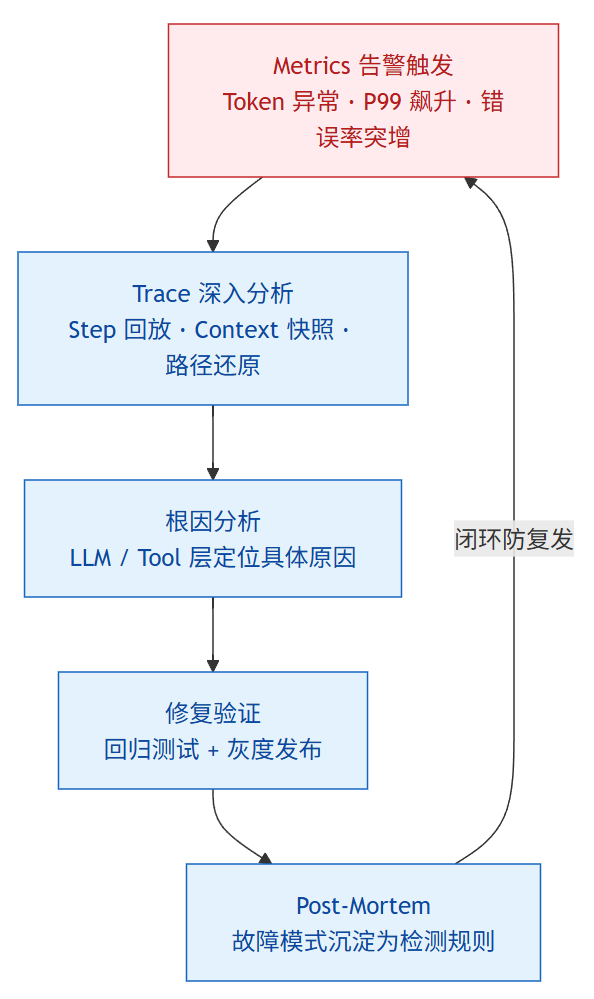
Trace 驱动排查四步:告警发现→Trace 定位→根因分析→修复验证,Post-Mortem 把故障沉淀回检测规则。
核心排查工具集
代码块
Python
import time, json, hashlib, asyncio, random, difflib
from dataclasses import dataclass
from typing import Optional
Scenario 1: Agent 陷入无限循环
问题描述:监控告警显示某 Agent 会话 Token 消耗在 5 分钟内暴涨 20 倍,LLM 反复调用 query_database,每次调用后又判断"需要重试"。
排查步骤:
代码块
Plain Text
┌─────────────────────────────────────────────────────────────┐
│ 无限循环排查路径 │
├─────────────────────────────────────────────────────────────┤
│ Step 1: Token 告警触发 │
│ ▼ │
│ Step 2: 查看 Trace → step_count = 47(正常 < 10) │
│ ▼ │
│ Step 3: 分析 tool_call pattern → query_database × 42 │
│ ▼ │
│ Step 4: 检查 tool response │
│ │ → "Error: connection timeout, please retry" │
根因:工具错误信息含 "please retry",LLM 将其解读为系统指令而非错误报告。缺少循环检测和 max_steps 限制,Agent 陷入无限重试。
修复方案:
代码块
Python
class LoopDetector:
"""循环检测器 —— 防止 Agent 无限循环"""
def __init__(self, max_same_calls: int = 3, max_steps: int = 25):
self.max_same_calls = max_same_calls
self.max_steps = max_steps
self.history: list[str] = []
def check(self, tool_name: str) -> dict:
self.history.append(tool_name)
if len(self.history) >= self.max_same_calls:
Scenario 2: RAG 检索正常但回答仍然幻觉
问题描述:用户反馈 Agent 回答错误。检查 RAG Pipeline 发现检索到的文档正确(Recall 正常),但最终回答与检索内容完全不符。
排查步骤:
代码块
Plain Text
#SlPSfgCGUSWJ text{white-space:pre}.fb0{stroke:var(--N900-FG, 0.15)}.fx0{stroke-miterlimit:10}.fa1{fill:#bbbfc4}.fx1{font:normal 400 12px MonospacedNumber,LarkHackSafariFont,LarkEmojiFont,LarkChineseQuote,-apple-system,BlinkMacSystemFont,Helvetica Neue,Tahoma,PingFang SC,Microsoft Yahei,Arial,Hiragino Sans GB,sans-serif,Apple Color Emoji,Segoe UI Emoji,Segoe UI Symbol,Noto Color Emoji}.fx2{text-anchor:middle}.fx3{dominant-baseline:central}.fx4{stroke:none}.fc0{fill:var(--text-caption)}.fa2{fill:var(--text-link-disabled)}.fx5{font:400 normal 13px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"}.fx6{text-anchor:start}.fx7{dominant-baseline:alphabetic}.fc1{fill:rgb(0, 0, 0)}.fx8{font:400 normal 13px LarkHackSafariFont, LarkEmojiFont, "ui-monospace", -apple-system, BlinkMacSystemFont, "Helvetica Neue", Helvetica, "Noto Sans", Tahoma, "Nimbus Sans L", Arial, "Liberation Sans", "PingFang SC", "Hiragino Sans GB", "Noto Sans CJK SC", "Source Han Sans SC", "Source Han Sans CN", "Microsoft YaHei", "Wenquanyi Micro Hei", "WenQuanYi Zen Hei", STHeiti, SimHei, sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji", system-ui}.fb1{fill:var(--N900-FG, 0.15)}.fb2{fill:rgb(209, 217, 224)}.fa3{fill:var(--bg-body)}ABC123456排查阶段1. 时间维度2. 工具维度3. 错误类型4. 流量分析5. 根因确认检查项错误率 vs 时间曲线按工具分类统计分析响应码统计 QPS 峰值检查 API 文档发现错误集中在 14:00-16:00仅 受影响429 Too Many Requests (78%)高峰 QPS 达限额的 120%Rate Limit: 100 req/minsearch_api
根因:检索结果被放在 Prompt 中间位置,受 Lost-in-the-Middle 效应影响,LLM 对中间信息关注度下降,更倾向于依赖自身参数知识。
修复方案:
代码块
Python
class ContextWindowOptimizer:
"""Context Window 优化器 —— 解决 Lost-in-the-Middle"""
def build_prompt(self, system: str, docs: list[dict],
history: list[dict], query: str) -> str:
# 只保留最近 3 轮对话,减少噪声
recent = history[-3:] if len(history) > 3 else history
history_text = "\n".join(f"{m['role']}: {m['content']}" for m in recent)
# 按相关性排序,只取 Top-3
sorted_docs = sorted(docs, key=lambda d: d["score"], reverse=True)[:3]
docs_text = "\n\n".join(
f"[文档{i+1}] (相关性:{d['score']:.2f})\n{d['content']}"
for i, d in enumerate(sorted_docs))
# 关键:检索内容紧跟 System Prompt,利用 Primacy Bias
Scenario 3: 工具调用间歇性超时
问题描述:14:00-16:00 高峰期工具调用失败率从 1% 飙升到 35%,非高峰完全正常。
排查步骤:
根因:第三方 API 有 100 req/min 限制,高峰期并发超限触发 HTTP 429。
修复方案:
代码块
Python
class RateLimitAwareToolCaller:
"""限流感知调用器 —— 指数退避 + 缓存 + 限流预检"""
def __init__(self, rate_limit: int = 90): # 留 10% 余量
self.rate_limit = rate_limit
self.timestamps: list[float] = []
self.cache: dict[str, dict] = {}
async def call(self, tool_name: str, args: dict, func, retries: int = 3) -> dict:
Scenario 4: Agent 执行了危险的不可逆操作
问题描述:用户要求"清理过期数据",Agent 直接调用 delete_records 删除了 50,000 条记录(含有效数据),无确认、无备份。
排查步骤:
代码块
Plain Text
┌──────────────────────────────────────────────────────────────────┐
│ 危险操作排查路径 │
├──────────────────────────────────────────────────────────────────┤
│ 用户输入: "清理过期数据" │
│ ▼ │
│ LLM 决策: delete_records(filter="created_at < 2024-01") │
│ ├──→ ⚠ filter 条件由 LLM 自行推断,未经确认 │
│ ├──→ ⚠ delete_records 无权限分级 │
│ ├──→ ⚠ 无 dry-run 预览 │
根因:工具权限过于粗放,delete_records 无条件执行;缺少 Human-in-the-Loop 审批;LLM 自行推断 filter 条件无人审核。
修复方案:
代码块
Python
Scenario 5: 模型 API 升级后 Agent 行为突变
问题描述:某天大量用户反馈输出格式异常——JSON 变为自然语言叙述,多步规划退化。前一天无任何代码变更。
排查步骤:
根因:模型供应商静默升级默认版本,新版本 Instruction Following 行为变化。Agent 未 pin 具体版本,直接受影响。
修复方案:
代码块
Python
class ModelVersionGuard:
"""模型版本守卫 —— 防止静默升级"""
def __init__(self, pinned: str, allowed: list[str]):
self.pinned = pinned
self.allowed = allowed
self.baselines: dict[str, str] = {}
def verify(self, headers: dict) -> dict:
actual = headers.get("x-model-version", "unknown")
if actual not in self.allowed:
return {"status": "mismatch", "expected": self.pinned,
"actual": actual, "action": "回退到 pinned 版本"}
return {"status": "ok"}
五大场景对比总结
构建 Agent 可观测性体系
代码块
Plain Text
┌────────────────────────────────────────────────────────────────────┐
│ Agent 可观测性三支柱 │
├────────────────────────────────────────────────────────────────────┤
│ ┌──────────────┐ ┌──────────────────┐ ┌──────────────────────┐ │
│ │ Metrics │ │ Tracing │ │ Logging │ │
│ │ 指标监控 │ │ 分布式追踪 │ │ 结构化日志 │ │
│ ├──────────────┤ ├──────────────────┤ ├──────────────────────┤ │
│ │ Token 消耗/s │ │ Trace ID 串联 │ │ Step 级别日志 │ │
│ │ 延迟 P50/99 │ │ 每步 Input/Output│ │ 错误堆栈 │ │
│ │ 工具成功率 │ │ Tool Response │ │ 决策理由(CoT) │ │
│ │ 步数分布 │ │ Context 快照 │ │ 审计操作日志 │ │
Post-Mortem 模板
代码块
JSON
常见误区 / 面试追问
误区:"直接看日志就够了,不需要专门的 Trace 系统" — Agent 执行路径是非确定性的,传统日志只能看到离散事件点,无法还原完整决策链路。必须有 Trace 系统将 LLM 调用、工具调用、Context 变化串联成完整轨迹。多步推理中某一步的错误可能几步之后才显现,没有 Trace 串联根本无法回溯。
误区:"出了问题直接回滚代码就能解决" — Agent 故障很多时候不是代码问题,而是模型行为变化、外部 API 状态变化、数据分布漂移等非代码因素。回滚代码对这类问题完全无效。正确做法是先通过 Trace 定位根因类别(Prompt / 模型 / 工具 / 数据),然后针对性修复。
追问:"如何设计 Agent 的可观测性体系?" — 三个层次:Metrics(Token 消耗速率、工具成功率、端到端延迟、步数分布)发现异常;Tracing(每步 Input/Output、Tool Response、Context 快照、模型版本)定位根因;Logging(结构化决策日志、错误堆栈、审计记录)事后分析。三者通过 Trace ID 关联,告警阈值基于历史基线动态设定。
追问:"生产故障后如何做 Post-Mortem?" — 遵循 Blameless Post-Mortem:建立完整事件时间线,用 "5 Whys" 追溯根因到系统性缺陷,产出有负责人和截止日期的 Action Items。关键是将每次故障模式沉淀为自动化检测规则——发现无限循环就添加循环检测中间件,确保同类问题不复发。