高并发场景下的 Agent 系统扩展策略
难度:高级 分类:Production & Deployment
简短回答
Agent 系统的高并发扩展面临独特挑战:每个请求执行时间长(秒到分钟级)、资源消耗不确定(Token 数量变化大)、有状态(多步执行需要维护上下文)。核心扩展策略:(1) 无状态设计+外部状态存储——将 Agent 会话状态存储到 Redis/PostgreSQL,使服务实例可以自由水平扩展;(2) 任务队列解耦——用 Celery/RabbitMQ 将请求接收和 LLM 处理解耦,Worker 独立扩缩容;(3) 智能自动扩缩容——基于队列深度、并发数(而非 CPU)触发扩容,LLM 服务有其独特的并发限制;(4) 模型路由+故障转移——多提供商分散流量,避免单一 API 限流成为瓶颈;(5) 多层缓存——语义缓存+Prompt 缓存减少实际 LLM 调用量。ByteDance 的 HeteroScale 已在数万 GPU 上验证,通过网络感知调度和协调式扩缩容策略显著提升资源利用率。MIT 研究提出 LLM Archetypes 方法可将 Agent 模拟从千级扩展到百万级。关键指标:TTFT、TPS、QPS 在并发增加时的变化趋势,以及达到"饱和点"后的降级策略。
详细解析
Agent 高并发的独特挑战
#LdofieSbtMgM text { white-space: pre; }#LdofieSbtMgM .fb0 { stroke: var(--N900-FG, 0.15); }#LdofieSbtMgM .fb0 {stroke: rgba(31,35,41, 0.15)}#LdofieSbtMgM .fx0 { stroke-miterlimit: 10; }#LdofieSbtMgM .fx0 {stroke-miterlimit: 10}#LdofieSbtMgM .fa1 { fill: rgb(187, 191, 196); }#LdofieSbtMgM .fa1 {fill: rgb(187, 191, 196)}#LdofieSbtMgM .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#LdofieSbtMgM .fx1 {font-style: normal}#LdofieSbtMgM .fx2 { text-anchor: middle; }#LdofieSbtMgM .fx2 {text-anchor: middle}#LdofieSbtMgM .fx3 { dominant-baseline: central; }#LdofieSbtMgM .fx3 {dominant-baseline: central}#LdofieSbtMgM .fx4 { stroke: none; }#LdofieSbtMgM .fx4 {stroke: none}#LdofieSbtMgM .fc0 { fill: var(--text-caption); }#LdofieSbtMgM .fc0 {fill: #646a73}#LdofieSbtMgM .fa2 { fill: var(--text-link-disabled); }#LdofieSbtMgM .fa2 {fill: rgb(187, 191, 196)}#LdofieSbtMgM .fx5 { font: 400 13px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#LdofieSbtMgM .fx5 {font-style: normal}#LdofieSbtMgM .fx6 { text-anchor: start; }#LdofieSbtMgM .fx6 {text-anchor: start}#LdofieSbtMgM .fx7 { dominant-baseline: alphabetic; }#LdofieSbtMgM .fx7 {dominant-baseline: alphabetic}#LdofieSbtMgM .fc1 { fill: rgb(0, 0, 0); }#LdofieSbtMgM .fc1 {fill: rgb(0, 0, 0)}#LdofieSbtMgM .fb1 { fill: var(--N900-FG, 0.15); }#LdofieSbtMgM .fb1 {fill: rgba(31,35,41, 0.15)}#LdofieSbtMgM .fb2 { fill: rgb(209, 217, 224); }#LdofieSbtMgM .fb2 {fill: rgb(209, 217, 224)}#LdofieSbtMgM .fa3 { fill: var(--bg-body); }#LdofieSbtMgM .fa3 {fill: #fff}ABC1234567维度请求处理时间资源消耗状态扩展指标失败模式连接传统 Web 服务10-100ms可预测无状态(通常)CPU/内存超时/500短连接Agent 系统1-60s(甚至更长)Token 消耗不确定(变化 10x)多步执行有状态并发数/队列深度API 限流/成本爆炸长连接/SSE 流式
核心矛盾:
•
Agent 占用连接时间长 → 同等并发需要更多实例
•
API 限流 → 不能无限扩展实例
•
成本与流量正比 → 流量翻倍成本翻倍
扩展架构设计
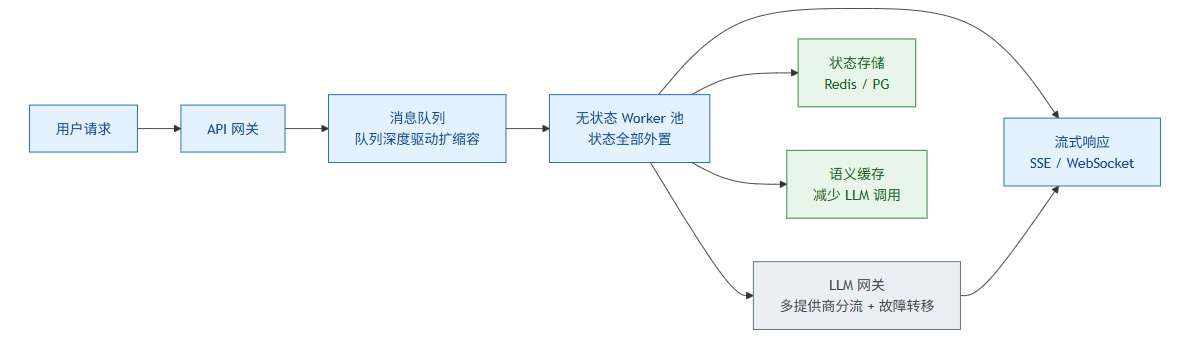
高并发公式:无状态 Worker + 队列解耦 + 外部状态,扩容看队列深度不看 CPU——真瓶颈在上游 API 限流。
代码块
Python
# 推荐的高并发 Agent 架构
class ScalableAgentArchitecture:
任务队列模式
代码块
Python
from celery import Celery
自动扩缩容策略
代码块
Python
多提供商流量分散
代码块
Python
class MultiProviderRouter:
"""多 LLM 提供商分散流量"""
def __init__(self):
self.providers = {
降级策略
代码块
Plain Text
高并发时的降级策略(按优先级):
常见误区 / 面试追问
误区:"Agent 系统和 Web 服务一样用 CPU 指标扩容" — Agent Worker 大部分时间在等待 LLM API 响应(I/O 密集),CPU 利用率可能只有 10% 但已经满载。应该用队列深度、并发连接数或 API 配额剩余量作为扩缩容指标。
误区:"加机器就能解决高并发" — Agent 系统的瓶颈通常不在计算资源,而在 LLM API 的限流。无限加 Worker 只会更快地触及 API 限流上限。需要多提供商分散流量 + 缓存减少 API 调用 + 模型路由优化。
追问:"如何估算 Agent 系统需要的资源?" — 关键公式:所需 Worker 数 = 目标 QPS × 平均响应时间(秒) / 每 Worker 并发数。例如:目标 100 QPS,平均响应 5s,每 Worker 并发 5 → 需要 100 个 Worker。再加上缓存命中率的折扣。
追问:"Serverless 适合 Agent 系统吗?" — 适合低流量和突发流量场景。但要注意:(1) 冷启动延迟(2-10s)影响用户体验;(2) 执行时间限制(Lambda 15min)可能不够长 Agent 使用;(3) 高流量时成本可能高于容器化部署。建议低流量用 Serverless,高流量用容器化。