Agent 系统的日志、监控与告警设计
难度:中级 分类:Production & Deployment
简短回答
Agent 系统的可观测性需要全新的监控栈——传统软件的日志+指标+告警不够用,因为 LLM 输出非确定性、故障模式是"质量退化"而非"服务崩溃"、成本与用量直接关联。2025 年的最佳实践是三层可观测性:(1) 结构化日志——记录每个 Prompt、Completion、工具调用和错误,附带元数据(模型、Token 数、用户 ID、时间戳);(2) 分布式追踪——用 Trace/Span 捕获完整的 Agent 执行路径(每步推理、工具调用、LLM 交互),支持单请求全链路排查;(3) 多维度指标+智能告警——监控质量(LLM Judge 评分)、性能(TTFT/P95 延迟)、成本(每请求/每用户成本)、安全(护栏触发率),在指标偏离基线时自动告警。关键原则:"存储很便宜,事故中缺少数据很贵"——宁可多记少用。主流平台:Langfuse(开源)、LangSmith(LangChain 生态)、Datadog(企业级)、Braintrust(评估+监控)。告警规则示例:预算使用 80% → 警告;P95 延迟 > 5s → 警告;质量评分连续下降 3 天 → 紧急。
详细解析
为什么传统监控不够
#iDZBHyQTTURK text { white-space: pre; }#iDZBHyQTTURK .fb0 { stroke: var(--N900-FG, 0.15); }#iDZBHyQTTURK .fb0 {stroke: rgba(31,35,41, 0.15)}#iDZBHyQTTURK .fx0 { stroke-miterlimit: 10; }#iDZBHyQTTURK .fx0 {stroke-miterlimit: 10}#iDZBHyQTTURK .fa1 { fill: rgb(187, 191, 196); }#iDZBHyQTTURK .fa1 {fill: rgb(187, 191, 196)}#iDZBHyQTTURK .fx1 { font: 400 12px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#iDZBHyQTTURK .fx1 {font-style: normal}#iDZBHyQTTURK .fx2 { text-anchor: middle; }#iDZBHyQTTURK .fx2 {text-anchor: middle}#iDZBHyQTTURK .fx3 { dominant-baseline: central; }#iDZBHyQTTURK .fx3 {dominant-baseline: central}#iDZBHyQTTURK .fx4 { stroke: none; }#iDZBHyQTTURK .fx4 {stroke: none}#iDZBHyQTTURK .fc0 { fill: var(--text-caption); }#iDZBHyQTTURK .fc0 {fill: #646a73}#iDZBHyQTTURK .fa2 { fill: var(--text-link-disabled); }#iDZBHyQTTURK .fa2 {fill: rgb(187, 191, 196)}#iDZBHyQTTURK .fx5 { font: 400 13px MonospacedNumber, LarkHackSafariFont, LarkEmojiFont, LarkChineseQuote, -apple-system, BlinkMacSystemFont, "Helvetica Neue", Tahoma, "PingFang SC", "Microsoft Yahei", Arial, "Hiragino Sans GB", sans-serif, "Apple Color Emoji", "Segoe UI Emoji", "Segoe UI Symbol", "Noto Color Emoji"; }#iDZBHyQTTURK .fx5 {font-style: normal}#iDZBHyQTTURK .fx6 { text-anchor: start; }#iDZBHyQTTURK .fx6 {text-anchor: start}#iDZBHyQTTURK .fx7 { dominant-baseline: alphabetic; }#iDZBHyQTTURK .fx7 {dominant-baseline: alphabetic}#iDZBHyQTTURK .fc1 { fill: rgb(0, 0, 0); }#iDZBHyQTTURK .fc1 {fill: rgb(0, 0, 0)}#iDZBHyQTTURK .fb1 { fill: var(--N900-FG, 0.15); }#iDZBHyQTTURK .fb1 {fill: rgba(31,35,41, 0.15)}#iDZBHyQTTURK .fb2 { fill: rgb(209, 217, 224); }#iDZBHyQTTURK .fb2 {fill: rgb(209, 217, 224)}#iDZBHyQTTURK .fa3 { fill: var(--bg-body); }#iDZBHyQTTURK .fa3 {fill: #fff}AB123456789传统 Web 服务监控HTTP 状态码(200/500)响应时间CPU/内存使用率错误率吞吐量Agent 系统需要的监控输出质量评分(语义层面)多步执行的完整轨迹Token 消耗和成本幻觉检测安全护栏触发率Prompt 漂移检测工具调用成功率模型版本变化追踪
核心区别:Agent 的“失败”通常不是崩溃,而是质量退化——API 返回 200,输出看似合理,但实际不准确或不安全。这种“静默失败”只有通过语义级别的监控才能发现。
三层可观测性架构
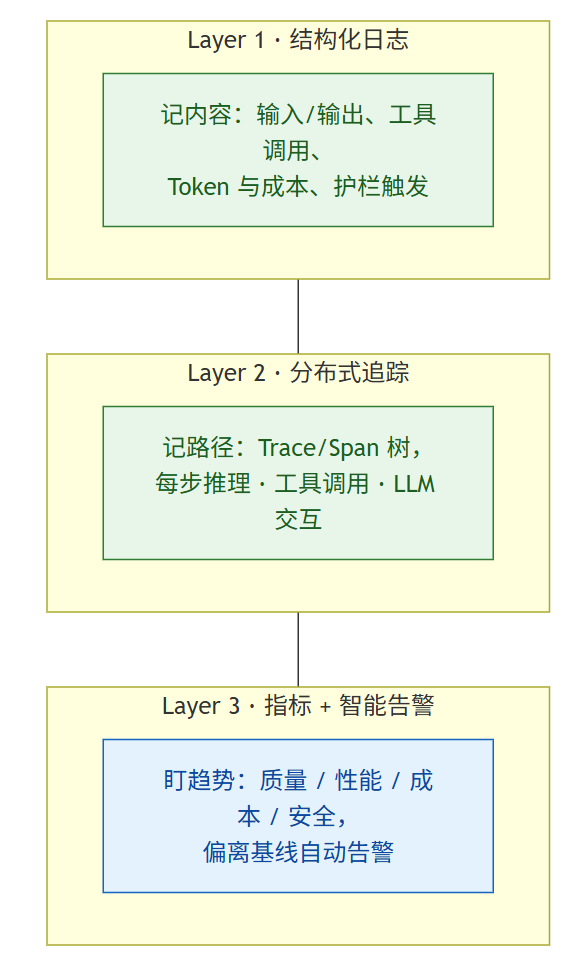
三层可观测性:日志记内容、Trace 记路径、指标+告警盯趋势——Agent 的静默失败只有语义层抓得到。
代码块
Python
# Layer 1: 结构化日志
class AgentLogger:
"""Agent 专用的结构化日志"""
def log_request(self, request_id, data):
"""记录完整的请求-响应对"""
log_entry = {
"request_id": request_id,
"timestamp": datetime.utcnow().isoformat(),
"user_id": data["user_id"],
# 输入
"input": data["user_message"],
"system_prompt_version": data["prompt_version"],
警告规则设计
代码块
Python
alert_rules = {
# 成本告警
"budget_warning": {
"condition": "daily_cost > budget * 0.8",
"severity": "warning",
监控平台选择
选择建议:
•
小团队/起步 → Langfuse(免费开源)
•
LangChain 技术栈 → LangSmith
•
企业级/已有 Datadog → Datadog LLM Observability
•
专注评估质量 → Braintrust
常见误区 / 面试追问
误区:"记录所有请求太贵了" — 日志存储远比你想象的便宜。S3 存储成本约 $0.023/GB/月,一天 10 万请求的完整日志约 1-5GB。而一次线上事故排查时缺少日志的代价远高于此。原则:宁可多记少用。
误区:"有了 Trace 就不需要日志了" — Trace 和日志互补。Trace 展示请求的执行路径和时间分布,日志记录详细的输入输出内容。排查"为什么这个请求输出了错误答案"需要日志;排查"为什么这个请求很慢"需要 Trace。
追问:"如何平衡监控粒度和性能开销?" — (1) 日志:全量记录元数据(Token 数、延迟),抽样记录完整内容(10-20% 的请求记录完整 Prompt/Response);(2) 评估:抽样评估(5-10% 的请求做 LLM Judge 评分);(3) Trace:全量记录 Span 结构,按需记录详细属性。
追问:"告警太多导致疲劳怎么办?" — (1) 分级:只有 critical 发 PagerDuty,warning 发 Slack;(2) 聚合:相同告警在 1 小时内合并;(3) 自动恢复:短暂的指标波动自动取消告警;(4) 定期回顾:每月审查告警规则,删除无效告警。
场景追问:"你的监控系统突然告警'成本异常激增',每日预算在下午 4 点就被用完,正常情况是晚上 10 点。如何快速定位并止损?" — 这是成本失控的紧急情况。快速响应路径:(1) 立即检查 Token 消耗详情 → 找出消耗激增的接口或功能模块;(2) 对比异常请求和正常请求的差异 → 可能是某个查询触发了无限循环或过度检索;(3) 检查是否有模型降级失效 → 主模型故障时降级到更昂贵的模型;(4) 立即实施熔断 → 对问题接口限流或直接下线;(5) 长期优化:(a) 增加单请求 Token 上限;(b) 实施预算熔断机制,达到阈值自动降级或拒绝请求;(c) 加入成本预测,提前预警预算耗尽风险。
场景追问:"你的监控显示 Agent 的质量评分在每天下午 2 点到 4 点出现规律性下降,其他时间段正常。如何分析根因?" — 这是有规律的性能退化问题。分析路径:(1) 时间维度分析 → 2-4 点是否对应特定业务场景(如用户群变化或特定类型查询集中);(2) 资源维度分析 → 该时间段是否有系统资源竞争(如批处理任务运行);(3) 模型维度分析 → 是否有模型轮换或限流策略在此时段生效;(4) 检查相关 Trace → 对比降分请求和正常请求的执行路径差异;(5) 长期解决:(a) 针对高负载时段优化算法;(b) 实施智能扩容,在高峰前自动增加资源;(c) 调整模型路由策略,不同时段使用不同配置。
场景追问:"你的监控平台突然无响应,所有 Trace 和日志都无法查询,但 Agent 系统本身运行正常。如何恢复并防止再次发生?" — 这是监控系统自身的故障。恢复路径:(1) 检查监控平台的存储是否满 → 日志/Trace 数据可能爆满;(2) 检查监控系统依赖的外部服务(如向量库、消息队列)是否正常;(3) 临时降级监控 → 暂停非关键的日志收集,只保留核心指标;(4) 重启监控服务组件;(5) 长期预防:(a) 监控系统自身也需要监控(元监控);(b) 实施数据保留策略,自动清理过期数据;(c) 监控系统多副本部署,避免单点故障;(d) 定期演练监控系统故障的恢复流程。