Agent 系统的灾难恢复与高可用设计
难度:高级 分类:Production & Deployment
简短回答
Agent 系统的高可用(HA)和灾难恢复(DR)比传统服务更关键——因为 AI Agent 正从后台走向前台,直接面对客户。如果 Agent 背后的 LLM 服务或数据库宕机,用户立即感知。核心设计原则:(1) 多提供商冗余——不依赖单一 LLM 提供商,主备切换延迟 < 1 秒;(2) 状态持久化与检查点——每步保存 Agent 执行状态,支持从任意步骤恢复,跨越小时甚至天级别的长任务;(3) 多区域部署——Active-Passive 架构,故障区域的流量自动切换到备用区域;(4) 优雅降级——LLM 不可用时降级到规则引擎/缓存/人工接管,而非完全不可用;(5) 熔断器模式——检测到异常时自动停止 Agent 执行,防止级联故障。Microsoft Foundry Agent Service 推荐 Active-Passive 配合 Gateway Routing 模式,备用区域保持温备。LangGraph 提供了内置的检查点和恢复机制。两个常被引用的对照案例(数据请以原始来源为准):Wells Fargo 的 Fargo 虚拟助理 2024 报告披露年度互动达亿级量级且无人工介入;MD Anderson 与 IBM Watson 合作的肿瘤诊断项目(2013-2017)累计投入约 6200 万美元后被中止——前者展示正确架构的价值,后者警示架构决策的重要性。引用具体数字时请回查 Wells Fargo 年报与 The Texas Tribune(2017)原文。
详细解析
高可用架构设计
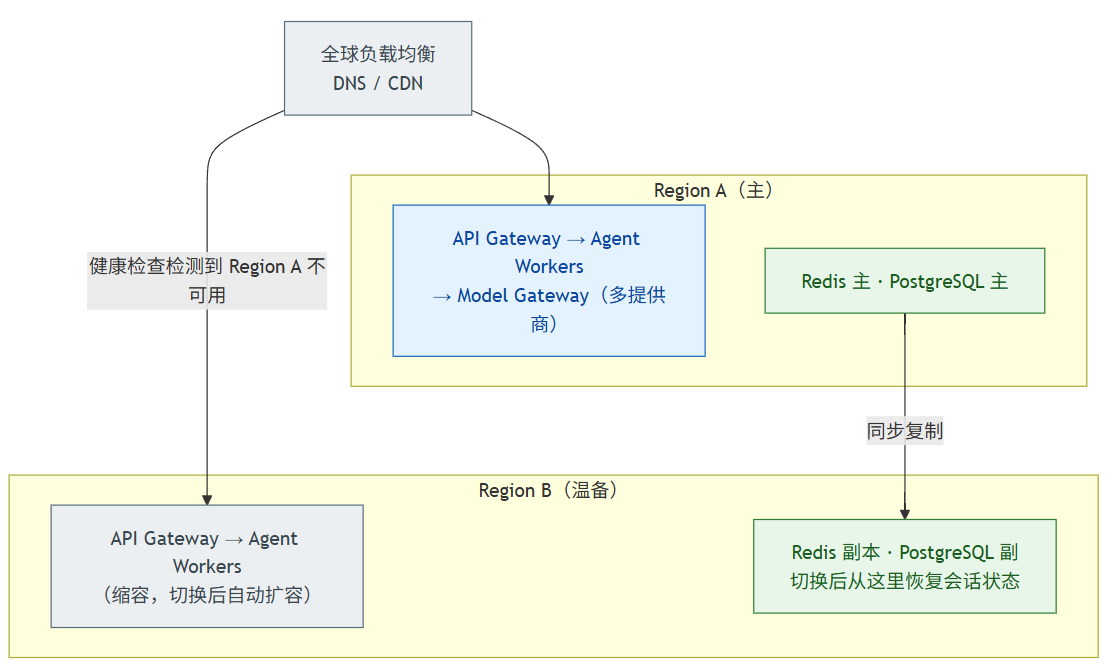
Active-Passive 温备:数据同步复制到备区,健康检查失败切流量,用户感知的中断时间 < 30 秒。
多提供商故障转移
代码块
Python
class LLMFailoverManager:
"""LLM 提供商级别的故障转移"""
def __init__(self):
self.providers = [
{"name": "openai", "priority": 1, "healthy": True},
{"name": "anthropic", "priority": 2, "healthy": True},
{"name": "google", "priority": 3, "healthy": True},
状态持久化与检查点
代码块
Python
优雅降级策略
代码块
Python
class GracefulDegradation:
"""Agent 系统的优雅降级"""
degradation_levels = {
"Level 0: 完全正常": {
"条件": "所有服务正常",
"行为": "完整 Agent 功能",
},
"Level 1: LLM 部分降级": {
"条件": "主 LLM 提供商限流或慢",
"行为": [
"切换到备用提供商",
"降级到更小的模型",
"增加缓存使用",
],
},
RTO/RPO 设计
Agent 系统的 RTO/RPO 目标:
常见误区 / 面试追问
误区:"LLM API 是云服务,不需要考虑可用性" — LLM API 提供商也会宕机或限流。2024-2025 年 OpenAI 和 Anthropic 都有过多次服务中断。必须有多提供商故障转移策略,不能把鸡蛋放在一个篮子里。
误区:"Agent 没有状态,不需要灾难恢复" — 多步 Agent 有大量状态:执行计划、已完成步骤的结果、对话历史、工具调用结果。丢失这些状态意味着任务从头开始,用户体验极差。检查点机制是必需的。
追问:"如何测试灾难恢复方案?" — (1) Chaos Engineering——随机中断 LLM API 连接,验证故障转移;(2) 故障注入——模拟数据库宕机、网络分区;(3) DR 演练——每季度进行一次完整的区域切换演练;(4) 恢复时间测量——记录实际 RTO 并与目标对比。
追问:"优雅降级和完全不可用之间如何选择?" — 原则:部分功能可用 > 完全不可用。用户宁可看到"AI 助手暂时简化模式运行"也不愿看到"服务不可用"。降级策略应该预先设计和测试,而不是在事故中临时决定。